
- Visitas mensais
- 23.207
- 2026-09
- Crescimento mensal +11,2%
GPUHub - GPUs dedicadas e infraestrutura elástica para cargas de trabalho de IA
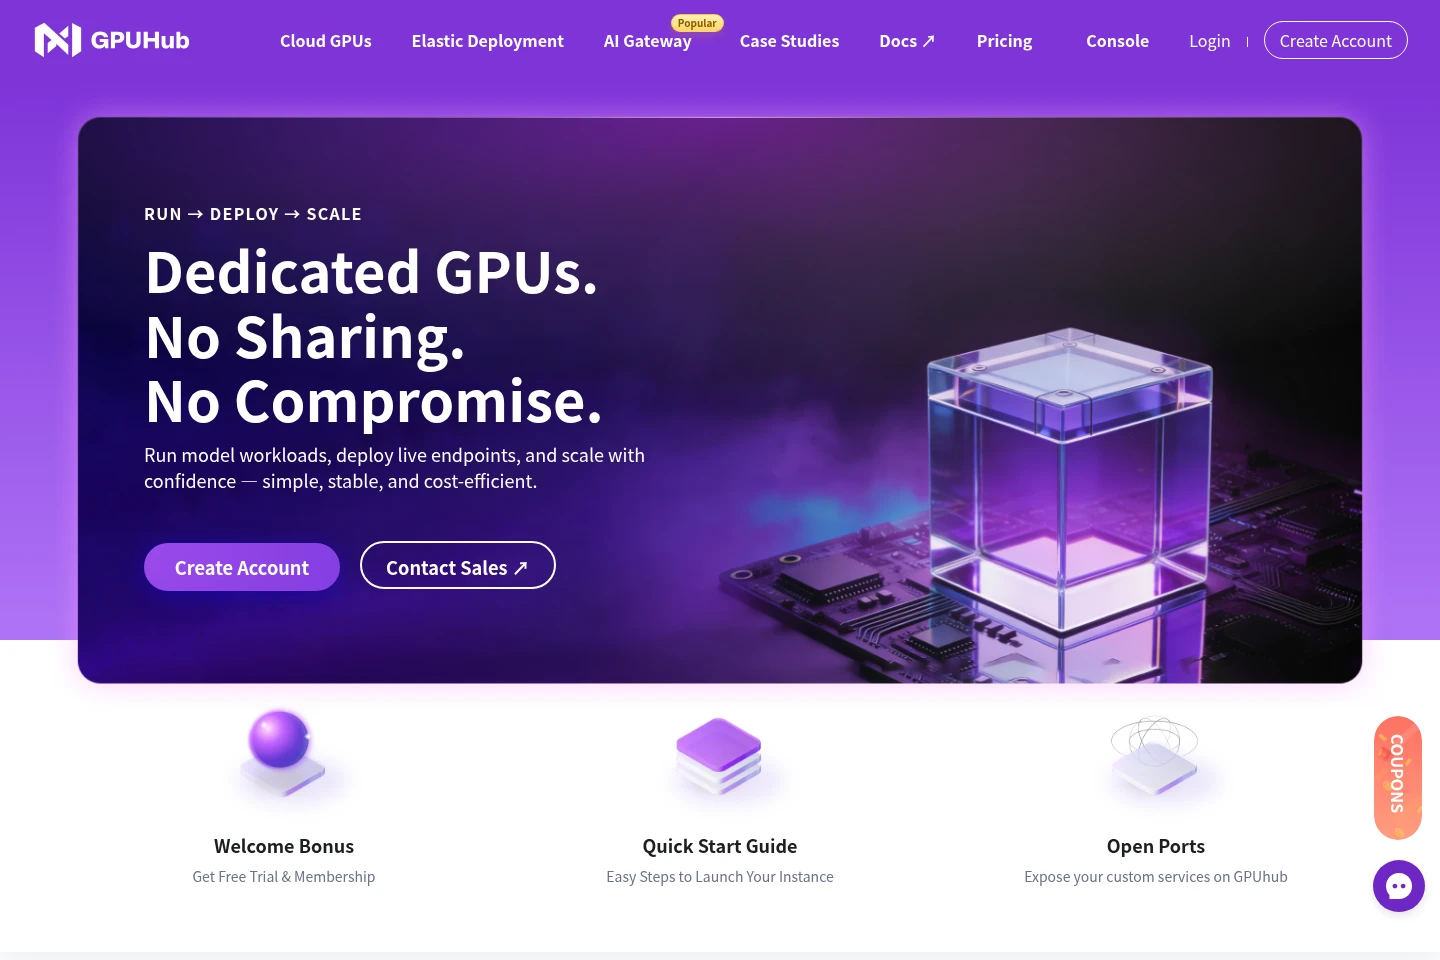
A GPUHub oferece GPUs dedicadas sob demanda para treinamento e inferência de modelos, além de implantação elástica baseada em contêineres. O AI Gateway permite acessar Claude, GPT e DeepSeek por um endpoint compatível com OpenAI. Os usuários podem iniciar imagens pré-configuradas, executar notebooks JupyterLab e escolher cobrança por hora ou fixa para computação GPU. Os preços variam conforme o modelo; a página também menciona upgrade gratuito de associação para estudantes.
- Desenvolvimento com LLM
- Nuvem GPU
- APIs de LLM
- nuvem de GPU dedicada
- API de inferência de modelos de IA
- implantação elástica de GPU
Funcionalidades
Computação GPU sob demanda
Inicia computação GPU dedicada para cargas de trabalho de modelos e disponibiliza uma instância em execução. O usuário escolhe o modelo de GPU e a imagem pré-configurada e depois define cobrança por uso ou fixa; a página lista preços por hora conforme o modelo e informa que desligar a instância interrompe a medição.
Implantação elástica
Implanta contêineres e ajusta réplicas de GPU conforme a demanda muda. O usuário implanta o contêiner e altera a quantidade de réplicas; a página mostra três, mas não informa uma cota.
AI Gateway
Envia solicitações para Claude, GPT e DeepSeek por um endpoint compatível com OpenAI. Os usuários acessam os modelos listados pelo gateway; a página não informa cotas de solicitações nem preço separado.
Notebooks JupyterLab
Inicia uma instância JupyterLab configurada para programar na infraestrutura GPU. A página diz que inclui CUDA e frameworks atuais e inicia em menos de 10 segundos; imagens e condições dependem da configuração escolhida.
Preços
A computação GPU é cobrada por uso ou por uma opção fixa; os preços por hora publicados variam conforme o modelo. Compare o preço do modelo e a modalidade de cobrança; a página não publica preços nem condições da opção fixa.
| Plano | Preço | Recursos e limites |
|---|---|---|
| Standard User | A partir de $0.30 por hora |
|
A página menciona upgrade gratuito de associação para estudantes, mas não explica os requisitos nem a duração. Os preços publicados variam conforme o modelo; a página não informa preços ou condições da cobrança fixa.
Casos de uso
Executar treinamento e inferência de modelos
Quando cargas de trabalho de modelos precisam de computação GPU dedicada, o usuário escolhe um modelo de GPU e uma imagem e inicia uma instância pela GPUHub. Os preços por hora são listados por modelo; a página diz que desligar a instância interrompe a medição.
Escalar serviços GPU em contêineres
Quando a demanda por um serviço em contêiner muda, o usuário implanta o contêiner e ajusta as réplicas GPU com Elastic Deployment. Assim, a quantidade de réplicas pode acompanhar a carga; a página não informa uma cota fixa.
Enviar solicitações aos modelos de linguagem disponíveis
Quando um aplicativo precisa chamar Claude, GPT ou DeepSeek, o usuário envia solicitações pelo AI Gateway e seu endpoint compatível com OpenAI. A página cita esses modelos, mas não informa limites específicos para cada um.
Trabalhar em um notebook JupyterLab com GPU
Quando é necessário um ambiente interativo de programação na infraestrutura GPU, o usuário inicia o notebook JupyterLab configurado. A GPUHub diz que inclui CUDA e frameworks e inicia em menos de 10 segundos; a disponibilidade depende da configuração de computação escolhida.
Limitações
Os preços e a computação GPU disponível dependem do modelo escolhido; a página lista preços por hora diferentes para cada modelo.
A página descreve cobrança por uso ou fixa para instâncias GPU, mas não informa os preços nem as condições da cobrança fixa.
As informações disponíveis sobre AI Gateway citam Claude, GPT e DeepSeek, mas não informam cotas de solicitações nem restrições específicas por modelo.
A página diz que estudantes podem receber upgrade gratuito de associação, mas não informa os requisitos de elegibilidade nem a duração da oferta.
Público-alvo
Desenvolvedores de modelos de IA que precisam de computação GPU dedicada para treinamento ou inferência.
Operadores de serviços em contêineres que precisam ajustar réplicas GPU conforme a demanda muda.
Desenvolvedores de aplicativos que precisam de um endpoint compatível com OpenAI para Claude, GPT e DeepSeek.
Pesquisadores e desenvolvedores que precisam de um ambiente JupyterLab configurado na infraestrutura GPU.
Perguntas frequentes
Quais modelos de GPU têm preços por hora publicados?
A página lista preços por hora para RTX 5090, RTX 5090D, RTX 4090, PRO 6000, PRO 6000D, A800 e RTX 4080(S). O preço varia por modelo, e a página mostra um desconto de 5% ao lado dos preços de associação.
Posso parar a cobrança da GPU quando não uso uma instância?
Sim. A página diz que é possível desligar uma instância GPU sob demanda a qualquer momento para interromper a medição. Ela também descreve a escolha entre cobrança por uso e fixa ao iniciar a instância.
Quais modelos posso acessar pelo AI Gateway?
A página cita Claude, GPT e DeepSeek e informa que eles podem ser usados por um endpoint compatível com OpenAI. Não informa cotas de solicitações nem restrições específicas para cada modelo.
Quanto tempo leva para iniciar um notebook JupyterLab?
A GPUHub informa que o JupyterLab configurado inicia em menos de 10 segundos. A página diz que inclui CUDA e frameworks; a inicialização também depende da disponibilidade de uma configuração GPU.
A GPUHub oferece upgrade gratuito de associação para estudantes?
A página diz que estudantes podem receber upgrade gratuito de associação. Ela não especifica critérios de elegibilidade, duração da oferta nem outras condições.
Comentários