DeepInfer
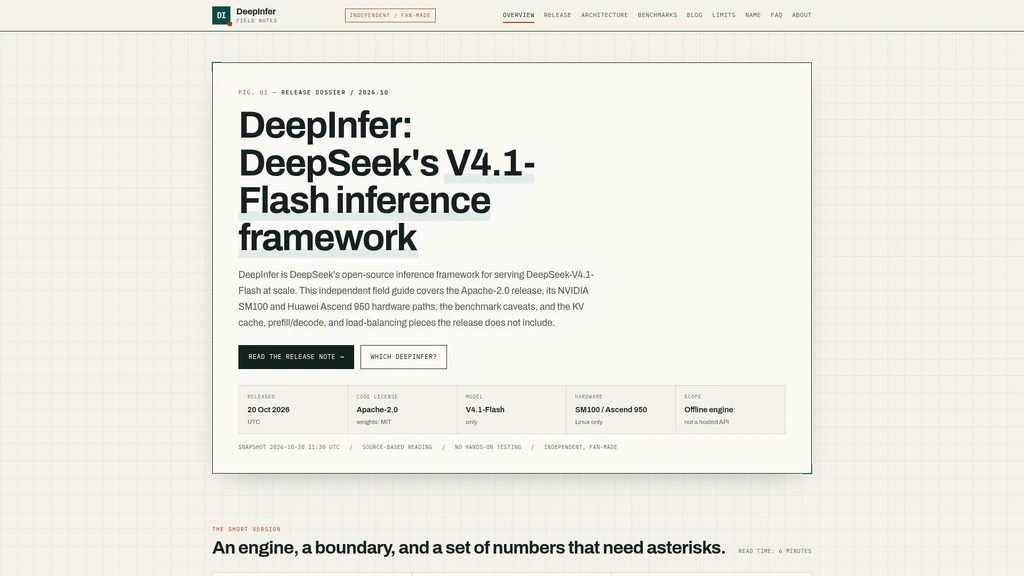
DeepInfer é o framework de inferência offline de código aberto da DeepSeek, licenciado sob a Apache-2.0, desenvolvido para executar o DeepSeek-V4.1-Flash em escala. Ele suporta hardwares NVIDIA SM100 e Huawei Ascend 950 executando no Linux, e sua documentação está disponível em um site de referência independente feito por fãs que cobre detalhes de lançamento, arquitetura, ressalvas de benchmarks e componentes não inclusos. A ferramenta não é uma API hospedada, um serviço online voltado para o usuário final ou uma pilha completa de atendimento ponta a ponta.
Principais Recursos
O DeepInfer vem com uma pilha pré-integrada de componentes otimizados, desenvolvidos especificamente para o DeepSeek-V4.1-Flash:
Um conjunto completo de kernels personalizados, incluindo FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect e kernels TileLang personalizados, montados a partir de componentes de kernel previamente lançados pela DeepSeek em um único motor unificado.
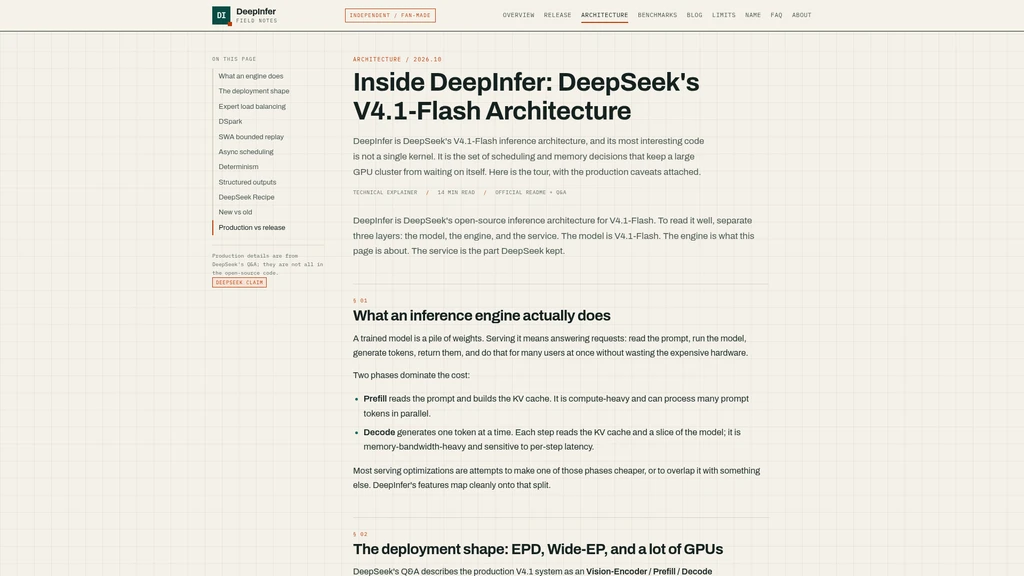
Configuração de paralelismo que combina paralelismo de especialistas (EP) para camadas MoE, paralelismo de dados de atenção (DP) e paralelismo de contexto balanceado (CP), projetada para distribuir especialistas entre 64–128 GPUs em implantações de produção, com cópias redundantes para reequilibrar especialistas com alta demanda.
Decodificação especulativa DSpark com verificação variável, que usa um cabeçalho de confiança para identificar quais tokens de rascunho exigem validação completa do modelo, entregando um ganho de rendimento de 4–7% relatado em pontos de operação padrão de produção.
Reprodução limitada de atenção de janela deslizante (SWA), que limita o custo de recomputação ao reproduzir apenas a cauda recente do cache, em vez de reconstruir todo o cache de janela deslizante em cada camada, para uma sobrecarga de computação previsível e limitada.
Agendamento assíncrono que executa o trabalho de preparação de lote na CPU em paralelo com a execução ativa da GPU, eliminando lacunas de ociosidade entre etapas de decodificação consecutivas.
Modos de inferência invariante ao lote e amostragem determinística disponíveis exclusivamente em hardware NVIDIA, para benchmarking auditável e comportamento consistente de execução de agentes.
Suporte nativo a saídas estruturadas para regras de regex, definições de JSON Schema e restrições de gramática EBNF.
A biblioteca complementar deepseek-recipe, um repositório separado licenciado sob a licença MIT que fornece conversão de protocolo de API e utilitários de tokenização.
Execução completa de inferência offline para o modelo DeepSeek-V4.1-Flash.
Públicos-Alvo
O DeepInfer foi desenvolvido para três grupos principais de usuários:
Desenvolvedores trabalhando diretamente com o modelo DeepSeek-V4.1-Flash que precisam de controle de baixo nível sobre a execução da inferência.
Pesquisadores de motores de inferência que estudam padrões de otimização de LLM voltados para produção, incluindo paralelismo amplo de especialistas, decodificação especulativa guiada por confiança e reprodução limitada de cache.
Engenheiros que constroem infraestrutura personalizada de atendimento de LLM e querem adaptar as otimizações de inferência derivadas da produção da DeepSeek para suas próprias implantações.
Fluxos de Trabalho Suportados
O framework é projetado para cargas de trabalho de inferência offline focadas no DeepSeek-V4.1-Flash, sem uma camada de atendimento pré-construída voltada para o usuário final. Os padrões de uso típicos incluem:
Integrar a pilha de kernels pré-otimizada e a configuração de paralelismo em pipelines de inferência internas personalizadas para o DeepSeek-V4.1-Flash.
Testar e auditar o comportamento determinístico da inferência para cargas de trabalho de benchmarking ou de agentes em hardware NVIDIA.
Implementar restrições de saída estruturada para cargas de trabalho do DeepSeek-V4.1-Flash sem middleware de terceiros adicional.
Estender o motor base para construir componentes de atendimento personalizados para requisitos específicos de infraestrutura interna.
Pesquisar e modificar otimizações de ponta de inferência de LLM, incluindo decodificação especulativa e balanceamento de carga de MoE.
Limitações e Recursos Explicitamente Não Inclusos
O DeepInfer tem um escopo definido e restrito, e não vem com os componentes necessários para uma pilha completa de atendimento online de produção:
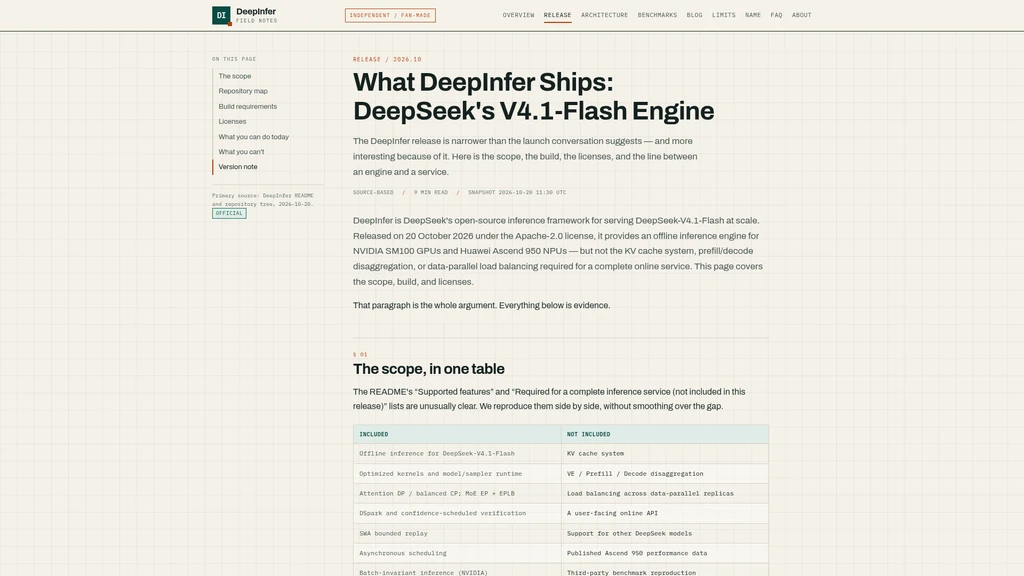
Ele não inclui um sistema de cache KV persistente que possa sobreviver a solicitações separadas ou a várias máquinas.
Ele não implementa a desagregação de preenchimento/decodificação para dividir cargas de trabalho entre pools de hardware dedicados separados.
Ele não inclui balanceamento de carga de paralelismo de dados entre várias réplicas de inferência.
Ele não é uma API online voltada para o usuário final, e não vem com um servidor compatível com OpenAI, autenticação, gerenciamento de cotas, faturamento ou ferramentas de observabilidade.
Ele não é um motor de inferência de propósito geral, e suporta apenas o modelo DeepSeek-V4.1-Flash, sem suporte oficial para outros modelos da DeepSeek ou LLMs de terceiros.
Nenhum dado de desempenho publicado está disponível para o hardware Huawei Ascend 950 no momento do lançamento.
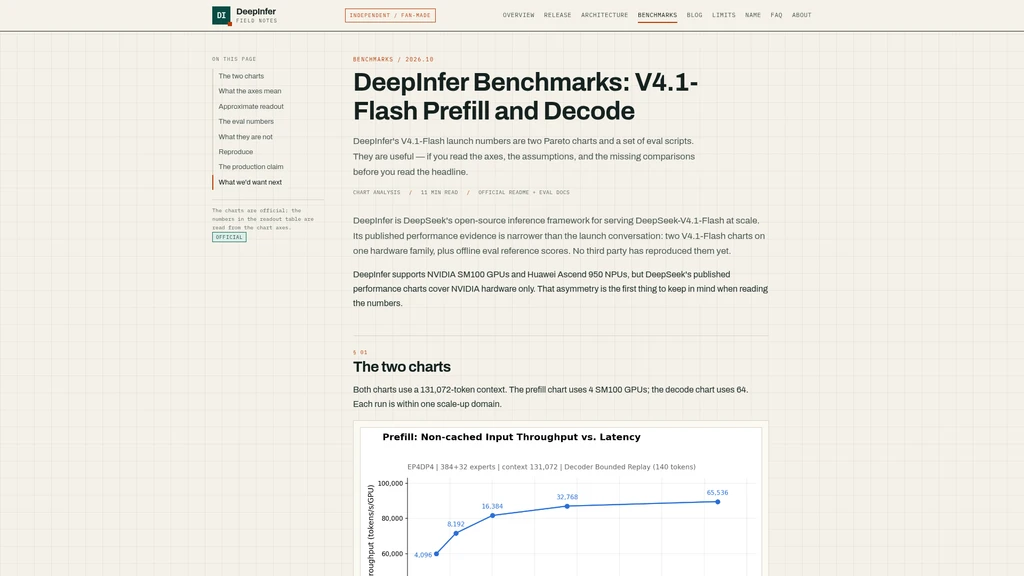
Nenhuma reprodução independente de terceiros dos gráficos de benchmark oficiais foi publicada a partir do snapshot de lançamento de 2026-10-20.
Todos os dados de benchmark oficiais são medidos com um comprimento de contexto de 131.072 tokens, não o contexto máximo completo de 1 milhão de tokens suportado pelo modelo DeepSeek-V4.1-Flash, e os números de desempenho de decodificação publicados assumem uma taxa de aceitação de tokens de rascunho de 75% que varia de acordo com a complexidade do texto de entrada.
O framework não suporta nenhum hardware fora do NVIDIA SM100 e Huawei Ascend 950 no Linux, sem suporte oficial para outras gerações da NVIDIA ou chips Ascend.
Licenciamento e Acesso
O DeepInfer é lançado sob a licença permissiva Apache-2.0, e está disponível para download gratuito, modificação e auto-hospedagem sem custos diretos associados. A biblioteca complementar deepseek-recipe é lançada sob a licença MIT. O site de referência independente feito por fãs que cobre o projeto não é afiliado à DeepSeek, NVIDIA ou Huawei, e todas as afirmações sobre produtos no site de referência são atribuídas diretamente a fontes oficiais públicas.




Comentários