
- Visitas mensais
- 223
- 2026-10
- Crescimento mensal +7.333,3%
daVinci-MagiHuman - Gere um vídeo falado com sincronização labial usando retrato e texto ou áudio
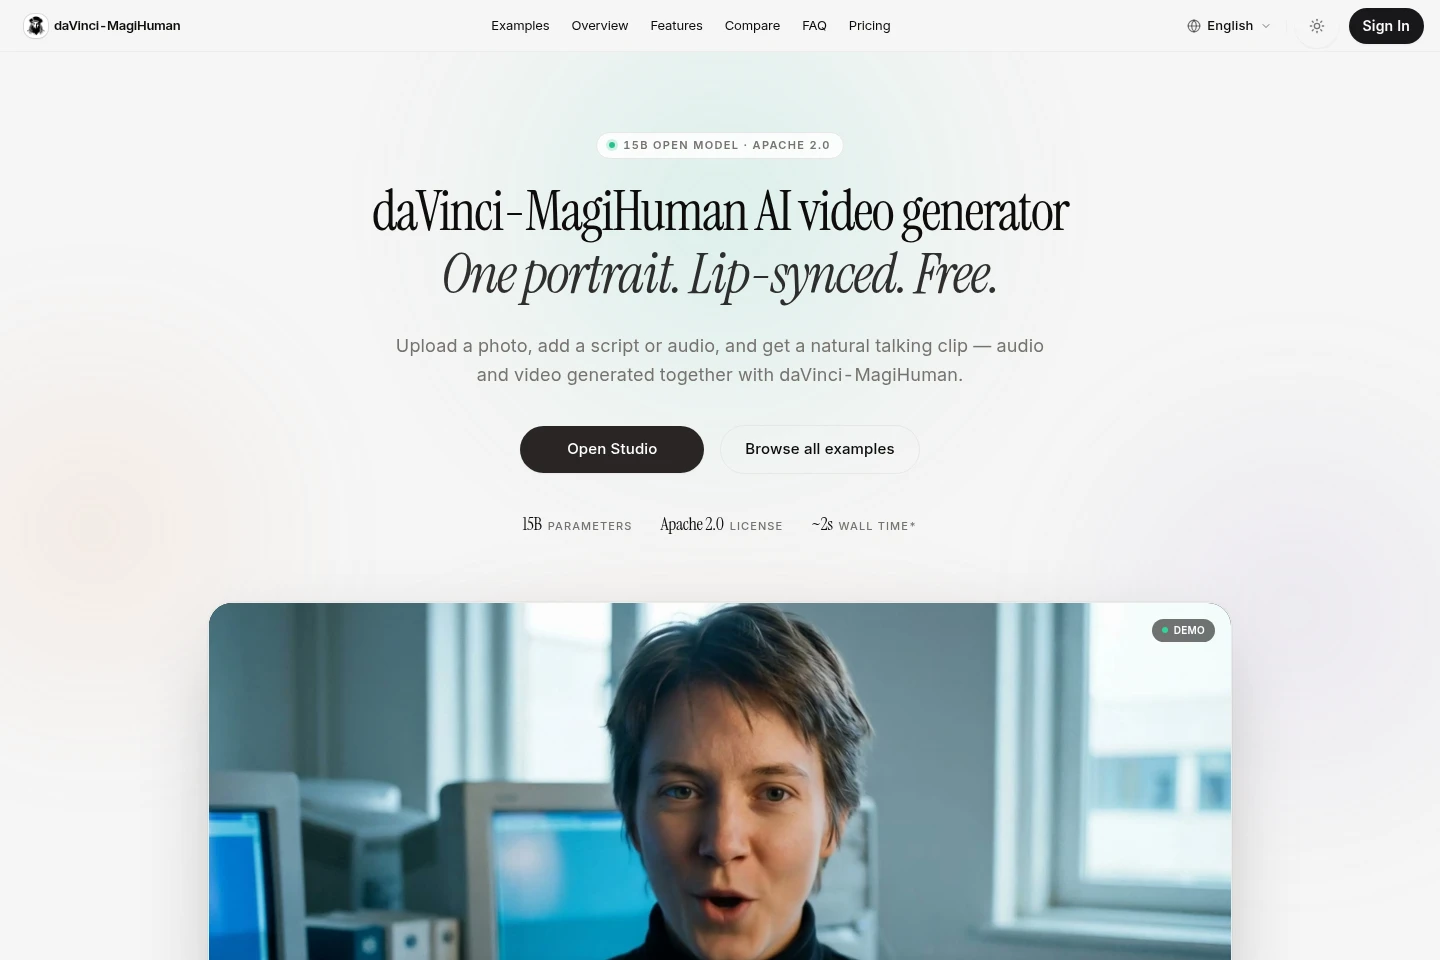
daVinci-MagiHuman é um modelo de IA de código aberto com 15 bilhões de parâmetros para gerar vídeos de retratos falantes. Ele recebe uma foto de retrato e texto ou áudio, e gera fala e vídeo sincronizados. O modelo é publicado sob a licença Apache 2.0 para inferência local e uso comercial conforme os termos da licença. Também há um estúdio online, com assinaturas e opções de créditos cobradas separadamente.
- Vídeo com IA
- Avatares de IA
- gerador de vídeo falado com IA
- modelo de sincronização labial de retrato
- IA de áudio e vídeo open source
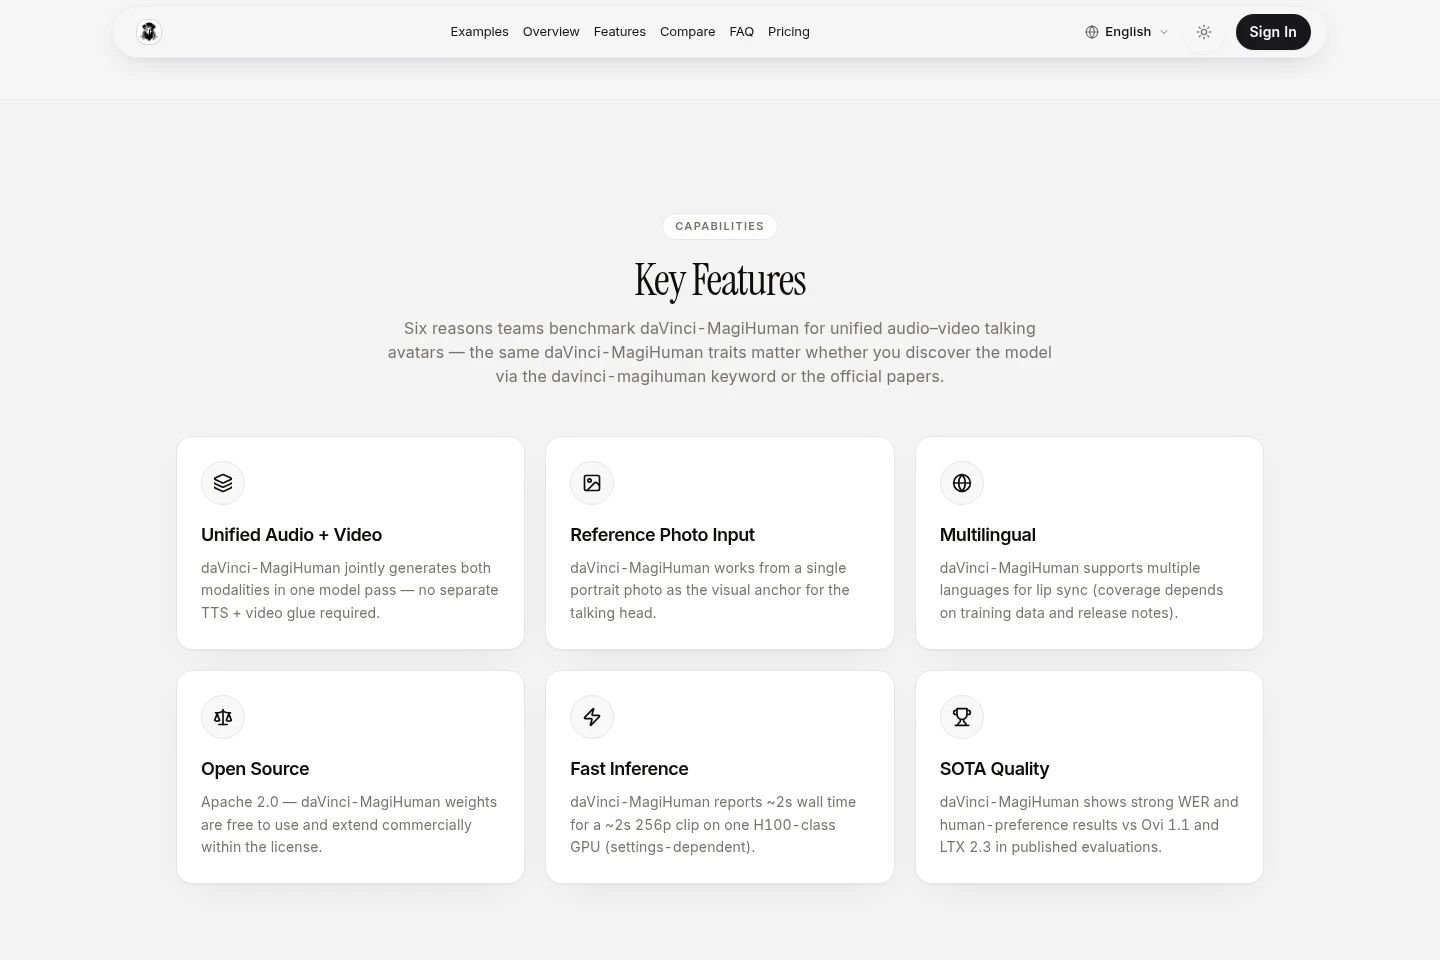
Funcionalidades
Geração de vídeo falado
Gera um vídeo falado com sincronização labial e áudio correspondente. A entrada é um retrato e um roteiro em texto ou áudio; a resolução de saída e a velocidade de inferência dependem das configurações e do hardware disponível.
Geração conjunta de áudio e vídeo
Gera áudio e vídeo juntos em uma única passagem do modelo. O Transformer de fluxo único processa tokens de áudio e vídeo em conjunto, sem exigir pipelines separados de texto para fala e vídeo.
Inferência local do modelo
Executa inferência local com os pesos publicados. Baixe os checkpoints e siga o README do projeto para configurar o ambiente, os scripts de inferência e as opções de linha de comando; o hardware afeta o desempenho.
Estúdio de vídeo online
Oferece um fluxo hospedado para geração de vídeos com IA. O estúdio pode ser usado online; a página de preços lista assinaturas e créditos comprados separadamente.
Preços
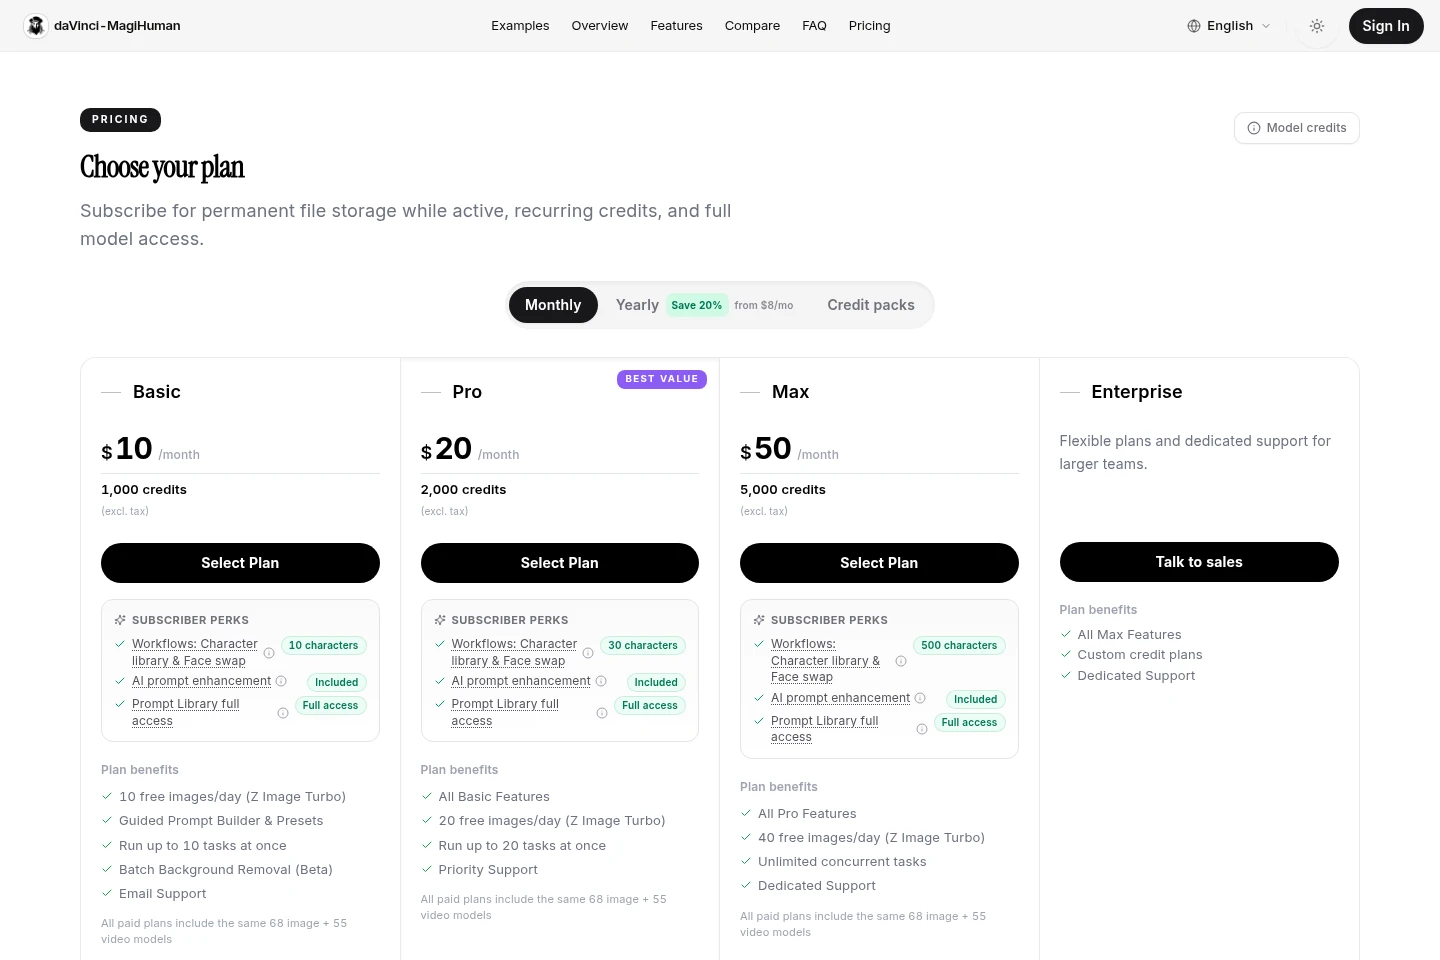
O estúdio hospedado oferece acesso gratuito, assinaturas mensais ou anuais e compras únicas de créditos. Compare créditos, imagens grátis por dia, tarefas simultâneas, limites de personagens, suporte e acesso aos modelos.
| Plano | Preço | Recursos e limites |
|---|---|---|
| Basic | US$ 10 por mês |
|
| Pro | US$ 20 por mês |
|
| Max | US$ 50 por mês |
|
| Enterprise | Planos flexíveis; fale com vendas |
|
| Pay-as-you-go credits | Compra única; preço variável |
|
Assinaturas anuais são cobradas uma vez pelo ano completo, com valor efetivo reduzido; a página anuncia economia de 20%. As assinaturas são renovadas automaticamente. Novas assinaturas têm prazo de reembolso de sete dias; problemas com cobranças de renovação devem ser comunicados em até 72 horas.
Casos de uso
Criar um clipe falado com sincronização labial
Quando um retrato precisa falar um roteiro ou áudio fornecido, envie a imagem e o texto ou áudio. O modelo gera um vídeo falado com os movimentos dos lábios alinhados à fala.
Executar inferência de vídeo no próprio hardware
Quando desenvolvedores ou pesquisadores querem executar o modelo localmente ou em um servidor, podem obter os checkpoints no Hugging Face e configurar a inferência pelo README do projeto. A geração então roda no hardware escolhido.
Gerar vídeos no estúdio hospedado
Para gerar online sem instalar o modelo, abra o estúdio de vídeo com IA e envie uma tarefa compatível. A página de preços explica assinaturas, créditos e o consumo de créditos por geração.
Limitações
Na assinatura hospedada, as solicitações são pausadas quando o saldo de créditos chega a zero; é possível comprar créditos adicionais ou mudar de plano para retomar a geração.
Os idiomas disponíveis para sincronização labial dependem dos dados de treinamento e do modelo publicado; a lista atual está no README oficial.
A velocidade de inferência depende das configurações e do hardware; a referência de cerca de dois segundos corresponde a um clipe 256p de aproximadamente dois segundos em uma GPU da classe H100.
O uso comercial do modelo está sujeito às condições da licença Apache 2.0, incluindo avisos e requisitos de atribuição aplicáveis.
Créditos comprados no modelo pay-as-you-go não expiram; créditos de assinatura são concedidos em ciclos mensais ou anuais.
Público-alvo
Desenvolvedores que integram ou executam um modelo aberto de vídeo falado
Pesquisadores que avaliam modelos de geração de áudio e vídeo
Criadores que precisam gerar vídeos de retratos falantes online
Perguntas frequentes
O que o daVinci-MagiHuman gera?
Ele gera um vídeo falado com sincronização labial e áudio correspondente a partir de um retrato e texto ou áudio. O modelo gera áudio e vídeo em conjunto.
O modelo pode ser usado de graça?
Os pesos publicados do modelo e o código estão disponíveis sob Apache 2.0. Assinaturas e créditos do estúdio hospedado têm preços e condições separados.
Posso usar o daVinci-MagiHuman comercialmente?
Sim, desde que você cumpra as condições da Apache 2.0. Confira os requisitos da licença para seu uso, incluindo avisos e atribuição.
Quais idiomas ele aceita para sincronização labial?
A cobertura depende do modelo publicado e dos dados de treinamento. Consulte o README oficial para ver a lista atual e possíveis observações por região.
Como são cobrados os créditos do estúdio online?
O consumo depende da duração de saída e de configurações como resolução e modo. O FAQ de preços traz estimativas; o estúdio mostra os totais em tempo real.
Os créditos pay-as-you-go vencem?
Não. Os créditos comprados na opção de pagamento único não vencem; os créditos de assinatura são concedidos mensal ou anualmente.

Comentários