Mistral Large 4
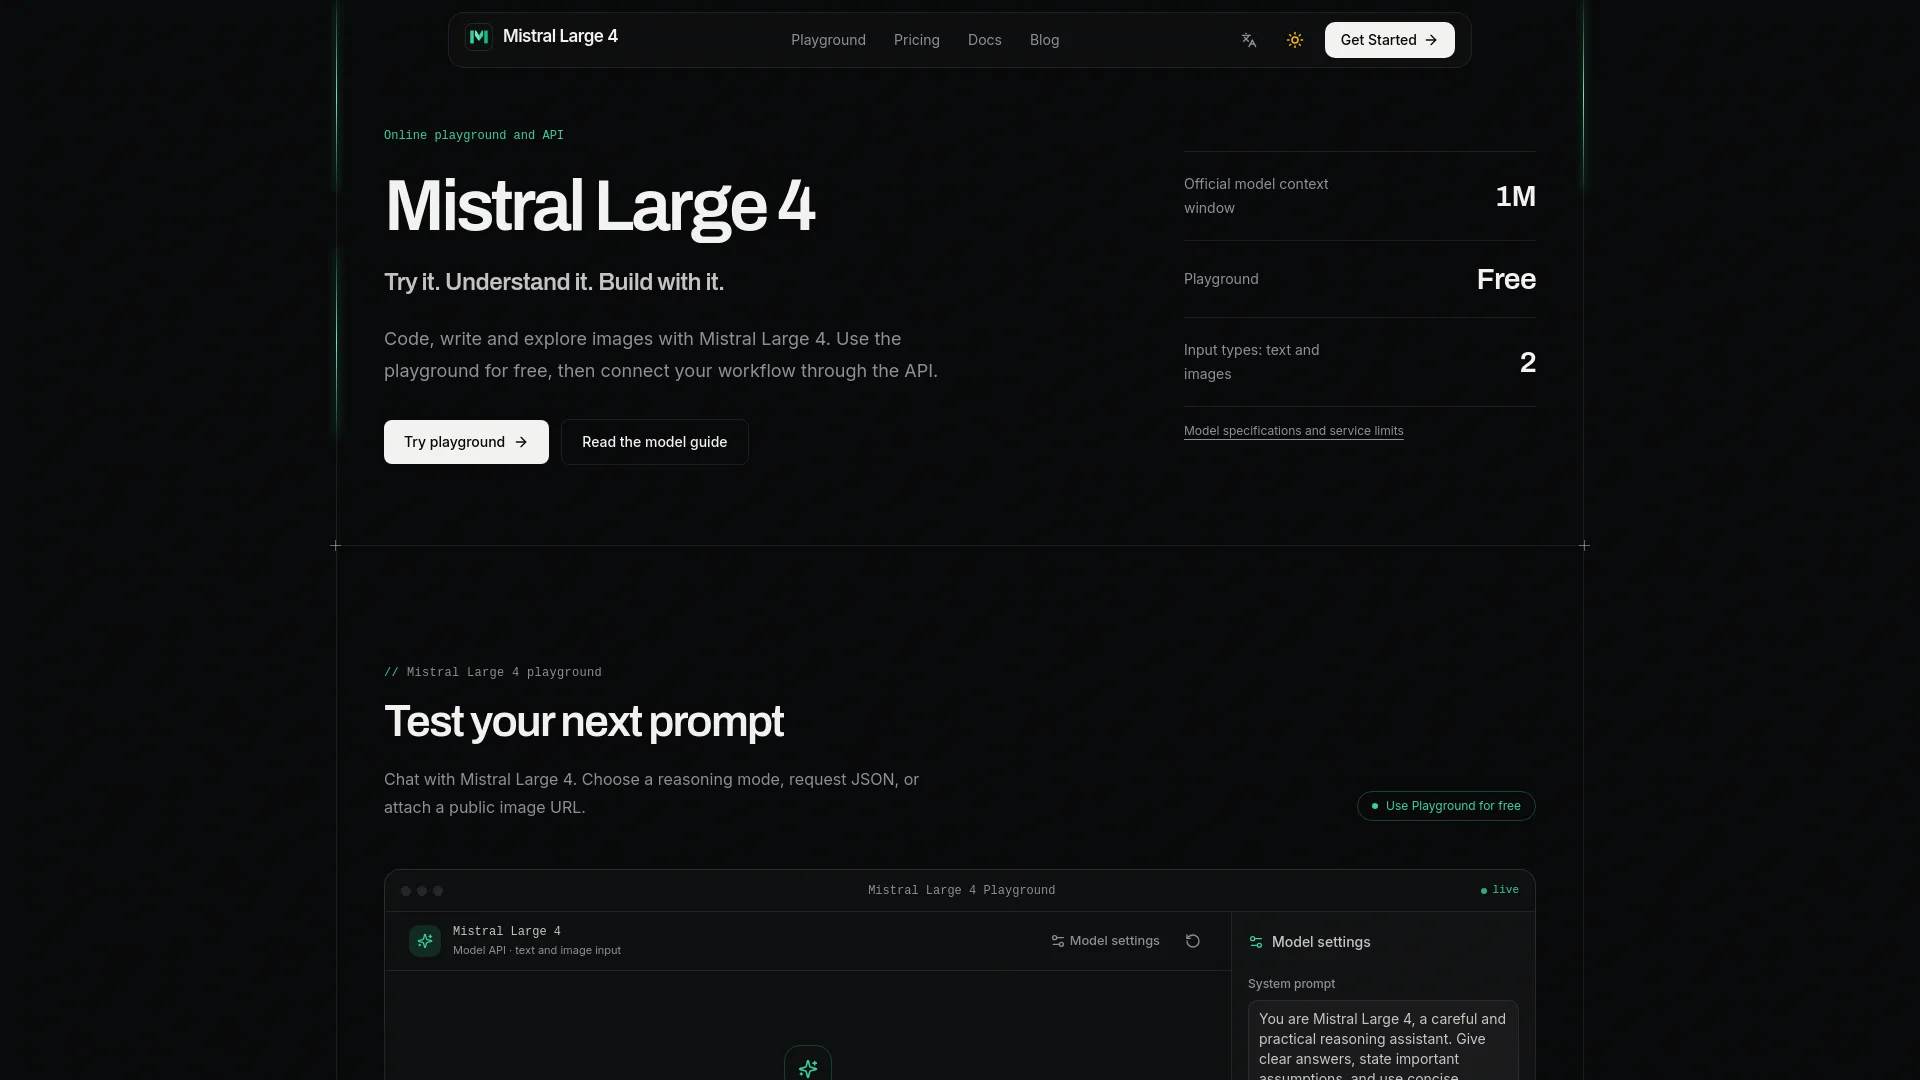
Mistral Large 4 est un modèle d'IA multimodale polyvalent, accessible via un espace de jeu gratuit basé sur navigateur et une API REST compatible OpenAI. Il est conçu pour prendre en charge les tâches d'IA courantes, notamment la programmation, l'analyse de documents, l'interprétation d'images, la rédaction et la génération de données structurées. Le modèle dispose d'une fenêtre de contexte officielle de 1 million de jetons, avec des paramètres ajustables pour affiner le comportement des sorties selon différents cas d'usage.
Capacités principales
Mistral Large 4 prend en charge à la fois les entrées de texte et d'image pour traiter directement un large éventail de tâches pratiques. Les utilisateurs peuvent soumettre des extraits de code pour examen, coller des extraits de documents pour poser des questions ciblées, ou partager des URL d'images publiques pour interpréter des captures d'écran, des diagrammes et des données visuelles.
Pour les flux de travail basés sur l'API, le modèle prend en charge les appels de fonction personnalisés pour permettre des intégrations d'outils telles que la recherche externe ou la consultation de données internes, le contrôle total de la logique d'exécution restant du côté de l'utilisateur. Le modèle peut générer nativement des sorties JSON structurées pour des cas d'usage incluant la classification de contenu, l'extraction de données et la planification de flux de travail, ce qui élimine le besoin d'étapes d'analyse supplémentaires pour les systèmes en aval qui attendent des données formatées prévisibles.
Des contrôles configurables intégrés permettent aux utilisateurs d'ajuster le comportement à chaque requête : ils peuvent définir des invites système personnalisées pour définir le rôle par défaut de l'assistant et le style de sortie, ajuster la température pour contrôler le caractère aléatoire des sorties, et faire varier l'effort de raisonnement entre des réponses directes à faible effort et un raisonnement plus approfondi à effort élevé pour la résolution de problèmes complexes.
L'espace de jeu en ligne gratuit ne nécessite aucune compétence en programmation pour tester des invites, tandis que l'API inclut une prise en charge native de la diffusion en continu pour la livraison de réponses en temps réel dans les applications intégrées.
Flux de travail pris en charge
Le flux de travail de l'espace de jeu sans code est conçu pour des tests rapides et sans friction :
Connectez-vous pour accéder à l'interface de l'espace de jeu gratuit
Collez du texte ou du code directement dans le champ de saisie, ou ajoutez une URL d'image publique à côté de votre invite, puis ajustez les paramètres du modèle, notamment l'effort de raisonnement, la température et le nombre maximal de jetons de sortie, selon vos besoins
Examinez la réponse du modèle, affinez votre requête avec des invites de suivi et validez les sorties par rapport à votre matériel source avant de passer à des intégrations plus importantes. Pour le contenu PDF, extrayez d'abord les extraits de texte pertinents pour les soumettre via le champ de saisie de texte.
Pour les intégrations d'API destinées aux développeurs, le flux de travail utilise des outils standard compatibles OpenAI :
Générez une clé API côté serveur dans les paramètres de votre compte, puis configurez votre client OpenAI pour qu'il pointe vers l'URL de base de l'API Mistral Large 4
Envoyez des requêtes avec votre texte, vos URL d'images, vos invites système personnalisées et toutes les fonctions d'outil définies, en spécifiant le niveau d'effort de raisonnement et le format de sortie souhaités
Validez toutes les demandes d'appel d'outil renvoyées dans votre propre logique d'application avant d'exécuter les fonctions approuvées, puis renvoyez les résultats au modèle pour poursuivre le flux de travail. Vous pouvez activer la diffusion en continu pour fournir des réponses incrémentielles aux utilisateurs finaux au fur et à mesure de leur génération.
Publics cibles
Mistral Large 4 est conçu pour quatre groupes d'utilisateurs principaux :
Les développeurs créant des applications et des agents d'IA personnalisés qui ont besoin d'un point de terminaison flexible compatible OpenAI pour intégrer des capacités multimodales et d'appel d'outils sans héberger de modèle personnalisé
Les utilisateurs occasionnels et les ingénieurs de prompts qui ont besoin de tester, d'itérer et d'affiner des invites d'IA sans écrire de code ni gérer d'infrastructure
Les équipes pluridisciplinaires travaillant sur des projets d'examen de code, d'analyse de documents et d'interprétation d'images qui ont besoin d'un environnement partagé pour tester les sorties avant de déployer des flux de travail à grande échelle
Les organisations qui cherchent à intégrer des capacités d'IA multimodale polyvalentes dans leurs flux de travail internes existants, avec une facturation à l'usage configurable pour s'adapter à une demande variable.
Tarification et conditions d'utilisation
Mistral Large 4 fonctionne selon un modèle freemium. L'espace de jeu en ligne est accessible gratuitement après connexion, et toute utilisation dépassant la limite gratuite est calculée selon un système de crédits : les crédits sont calculés en multipliant le coût réel du modèle en USD par 12 000, puis arrondis au nombre entier supérieur. Toutes les requêtes acceptées pour la génération sont comptabilisées dans l'utilisation, même si elles sont ultérieurement annulées ou ne parviennent pas à se terminer.
Des packs de crédits à usage unique sont disponibles pour les utilisateurs ayant une utilisation occasionnelle ou liée à un projet : ces packs n'expirent jamais et ne sont pas renouvelés automatiquement. Les packs à usage unique disponibles incluent 80 000 crédits pour 10 $, 1 000 000 de crédits pour 100 $ et 11 000 000 de crédits pour 1000 $.
Les abonnements mensuels accordent un nombre défini de crédits à chaque période de facturation, chaque attribution de crédits étant valable 90 jours à compter de la date à laquelle elle est ajoutée au compte. Tous les plans incluent l'accès à l'ensemble des fonctionnalités de l'espace de jeu, aux paramètres ajustables du modèle, à l'accès à l'API et à une assistance par e-mail.
Limites actuelles
Au 7 octobre 2026, les limites de service suivantes s'appliquent :
L'espace de jeu gratuit ne prend pas en charge les téléchargements de PDF, les entrées audio ou les entrées vidéo. Il n'accepte que le texte collé et les URL d'images publiques.
Les limites de saisie de l'espace de jeu sont fixées à 24 messages au total par conversation, 24 000 caractères par message individuel, 96 KiB par requête complète et un maximum de 16 384 jetons de sortie. La fenêtre de contexte officielle de 1 million de jetons du modèle ne correspond pas à la limite de saisie active de l'interface de l'espace de jeu.
L'intégration de l'API publique est configurée avec une limite de contexte de 524 288 jetons, qui est inférieure à la capacité maximale déclarée de 1 million de jetons du modèle.
Les poids du modèle ne sont pas encore disponibles pour l'auto-hébergement, une version publique étant prévue pour la fin d'octobre 2026. Aucun terme de déploiement auto-hébergé ou de licence commerciale n'est confirmé avant cette version.
L'espace de jeu hébergé n'est pas un déploiement privé. Les documents d'entreprise confidentiels ou les données sensibles réglementées ne doivent pas être soumis à l'espace de jeu, et il est recommandé aux utilisateurs de consulter la politique de confidentialité de la plateforme pour obtenir des détails sur le traitement des données, leur conservation et les régions d'hébergement géographiques avant de traiter du contenu sensible via l'API.




Commentaires