
- Visites mensuelles
- 23 207
- 2026-09
- Croissance mensuelle +11,2 %
GPUHub - GPU dédiés et infrastructure élastique pour les charges de travail IA
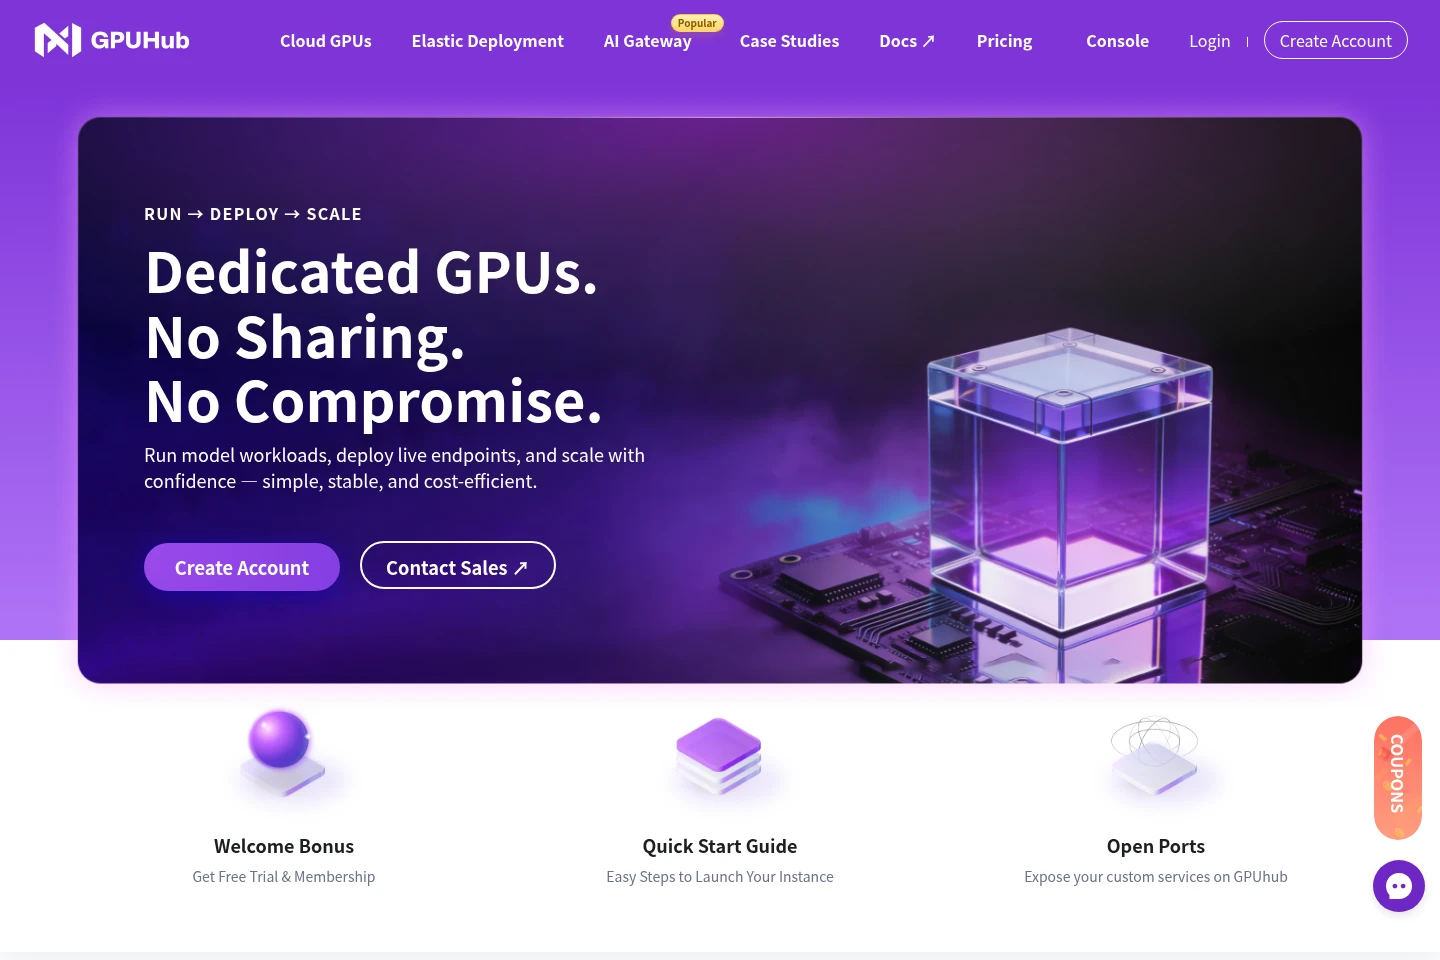
GPUHub fournit des GPU dédiés à la demande pour entraîner et inférer des modèles, ainsi qu’un déploiement élastique fondé sur des conteneurs. AI Gateway donne accès à Claude, GPT et DeepSeek via un endpoint compatible avec OpenAI. Les utilisateurs peuvent lancer des images préconfigurées, démarrer des notebooks JupyterLab et choisir une facturation horaire ou fixe pour le calcul GPU. Les prix dépendent du modèle ; la page mentionne aussi une mise à niveau gratuite de l’adhésion pour les étudiants.
- Développement LLM
- Cloud GPU
- API LLM
- cloud GPU dédié
- API d’inférence de modèles IA
- déploiement GPU élastique
Fonctionnalités
Calcul GPU à la demande
Lance un calcul GPU dédié pour des charges de travail de modèles et fournit une instance opérationnelle. L’utilisateur choisit un modèle GPU et une image préconfigurée, puis une facturation à l’usage ou fixe ; la page affiche les prix horaires par modèle et précise que l’arrêt de l’instance interrompt le compteur.
Déploiement élastique
Déploie des conteneurs et ajuste les réplicas GPU selon l’évolution de la demande. L’utilisateur déploie un conteneur et modifie le nombre de réplicas GPU ; la page en illustre trois sans préciser de quota.
AI Gateway
Envoie des requêtes à Claude, GPT et DeepSeek via un endpoint compatible avec OpenAI. Les utilisateurs accèdent aux modèles cités par l’intermédiaire de la passerelle ; la page ne précise ni quota de requêtes ni prix distinct.
Notebooks JupyterLab
Lance une instance de notebook JupyterLab configurée pour coder sur une infrastructure GPU. La page indique que CUDA et des frameworks récents sont inclus et que le démarrage prend moins de 10 secondes ; les images et conditions dépendent de la configuration choisie.
Tarifs
Le calcul GPU est facturé à l’usage ou selon une option fixe ; les tarifs horaires affichés varient selon le modèle. Comparez le prix horaire du modèle choisi et le mode de facturation ; la page ne donne pas les tarifs ni les conditions de l’option fixe.
| Offre | Prix | Fonctionnalités et limites |
|---|---|---|
| Standard User | À partir de $0.30 par heure |
|
La page mentionne une mise à niveau gratuite de l’adhésion pour les étudiants, sans préciser les critères ni la durée. Les prix affichés dépendent du modèle ; les tarifs et conditions de facturation fixe ne sont pas indiqués.
Cas d’utilisation
Exécuter l’entraînement et l’inférence de modèles
Lorsque des charges de travail de modèles nécessitent un calcul GPU dédié, l’utilisateur choisit un modèle GPU et une image, puis lance une instance sur GPUHub. Les prix horaires sont indiqués par modèle ; la page précise que l’arrêt de l’instance arrête le compteur.
Mettre à l’échelle des services GPU conteneurisés
Lorsque la demande d’un service conteneurisé évolue, l’utilisateur déploie le conteneur et ajuste ses réplicas GPU avec Elastic Deployment. Le nombre de réplicas peut ainsi suivre la charge ; aucun quota fixe n’est indiqué.
Envoyer des requêtes aux modèles de langage proposés
Lorsqu’une application doit appeler Claude, GPT ou DeepSeek, l’utilisateur envoie ses requêtes via AI Gateway et son endpoint compatible avec OpenAI. La page nomme ces modèles, sans préciser de limites propres à chacun.
Travailler dans un notebook JupyterLab avec GPU
Pour disposer d’un environnement de programmation interactif sur une infrastructure GPU, l’utilisateur lance le notebook JupyterLab configuré. GPUHub indique que CUDA et des frameworks sont inclus et que le démarrage prend moins de 10 secondes ; la disponibilité dépend de la configuration choisie.
Limites
Les prix et les ressources de calcul GPU disponibles dépendent du modèle choisi ; la page affiche des prix horaires différents selon les modèles.
La page décrit une facturation à l’usage ou fixe pour les instances GPU, sans préciser les prix ni les conditions de la facturation fixe.
Les informations disponibles sur AI Gateway citent Claude, GPT et DeepSeek, sans indiquer de quotas de requêtes ni de restrictions propres aux modèles.
La page indique que les étudiants peuvent bénéficier d’une mise à niveau gratuite de l’adhésion, sans préciser les critères d’éligibilité ni la durée de l’offre.
Public cible
Développeurs de modèles IA ayant besoin de calcul GPU dédié pour l’entraînement ou l’inférence.
Opérateurs de services conteneurisés devant ajuster les réplicas GPU selon la demande.
Développeurs d’applications ayant besoin d’un endpoint compatible avec OpenAI pour Claude, GPT et DeepSeek.
Chercheurs et développeurs ayant besoin d’un environnement JupyterLab configuré sur GPU.
Questions fréquentes
Quels modèles GPU ont des tarifs horaires affichés ?
La page affiche des tarifs horaires pour RTX 5090, RTX 5090D, RTX 4090, PRO 6000, PRO 6000D, A800 et RTX 4080(S). Le montant varie selon le modèle et une remise de 5 % apparaît à côté des prix d’adhésion.
Puis-je arrêter la facturation GPU quand une instance est inutilisée ?
Oui. La page indique qu’une instance GPU à la demande peut être arrêtée à tout moment pour interrompre le compteur. Elle mentionne aussi le choix entre facturation à l’usage et facturation fixe au lancement.
Quels modèles sont accessibles avec AI Gateway ?
La page cite Claude, GPT et DeepSeek et indique qu’ils sont accessibles via un endpoint compatible avec OpenAI. Elle ne précise ni quota de requêtes ni restriction propre à chaque modèle.
Combien de temps faut-il pour démarrer un notebook JupyterLab ?
GPUHub indique que le JupyterLab configuré démarre en moins de 10 secondes. La page précise que CUDA et des frameworks sont inclus ; le lancement dépend aussi de la disponibilité d’une configuration GPU.
GPUHub propose-t-il une mise à niveau gratuite aux étudiants ?
La page indique que les étudiants peuvent bénéficier d’une mise à niveau gratuite de l’adhésion. Elle ne précise ni les critères d’éligibilité, ni la durée de l’offre, ni d’autres conditions.
Commentaires