
- Visites mensuelles
- 250 617
- 2026-09
- Croissance mensuelle +24,1 %
Featherless - Exécutez des modèles ouverts avec une seule API d’inférence
Featherless fournit l’inférence hébergée de modèles ouverts via une API compatible avec OpenAI. Choisissez parmi plus de 40 000 modèles, créez une clé API et envoyez des requêtes sans provisionner de GPU. Les offres Chat, Developer et Business diffèrent par l’usage prévu, le contexte, la concurrence et la facturation.
- Développement LLM
- API LLM
- Cloud GPU
- API d’inférence de modèles ouverts
- hébergement LLM serverless
- API de modèles compatible OpenAI
Fonctionnalités
Inférence serverless de modèles
Exécute des modèles ouverts via une API d’inférence hébergée et renvoie leurs réponses. L’utilisateur choisit un modèle et envoie des requêtes avec une clé API ; Featherless exploite l’infrastructure GPU, sans provisionnement de GPU ni déploiement de poids par le client.
Catalogue de modèles ouverts
Permet de parcourir et choisir parmi plus de 40 000 modèles ouverts, notamment des familles, des modèles affinés et des variantes communautaires. Pour changer de modèle, il suffit de modifier son identifiant dans la requête API.
API compatible avec OpenAI
Envoie des requêtes de modèle via un endpoint API compatible avec OpenAI et renvoie les résultats d’inférence. Configurez l’endpoint et la clé API dans un SDK OpenAI ; les offres Developer et Business permettent l’usage de l’API en production.
Inférence sur GPU dédiés
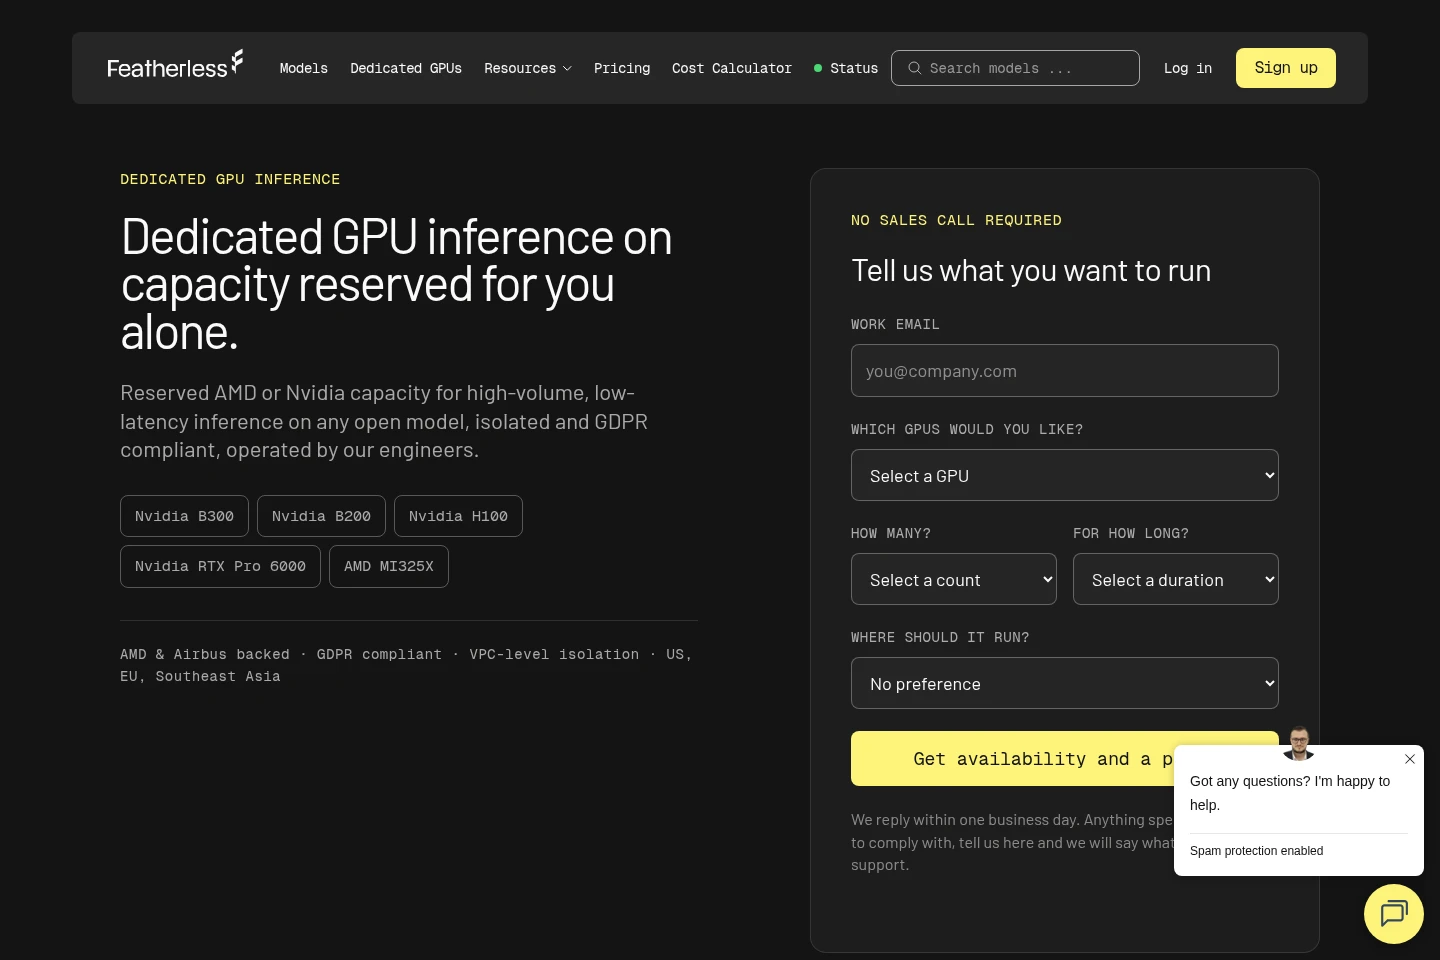
Exécute l’inférence sur une capacité GPU réservée, via un endpoint dédié. Choisissez parmi les accélérateurs Nvidia ou AMD disponibles ; les ingénieurs de Featherless assurent le réglage. L’offre comprend l’isolation au niveau VPC et la conformité GDPR.
Tarifs
Featherless propose l’abonnement mensuel Chat, Developer avec crédit mensuel facturé par token, et des contrats Business personnalisés. Comparez l’usage prévu, la fenêtre de contexte, la concurrence et la facturation forfaitaire, par token ou par contrat.
| Offre | Prix | Fonctionnalités et limites |
|---|---|---|
| Chat | 25 $/mois ; facturation mensuelle |
|
| Developer | 50 $ de crédit par mois |
|
| Business | Prix personnalisé ; contrats annuels |
|
Les abonnements Chat sont renouvelés chaque mois et peuvent être résiliés à tout moment. Les crédits Developer peuvent être rechargés par paiement ponctuel ; les appels sont suspendus lorsque le solde est épuisé. La durée du contrat Business est définie au cas par cas.
Cas d’utilisation
Intégrer un modèle ouvert à une application
Lorsqu’une application a besoin d’inférence LLM hébergée, choisissez un modèle, créez une clé API et configurez l’endpoint compatible avec OpenAI dans le SDK. Les requêtes utilisent le modèle choisi sans provisionnement de GPU ni hébergement de poids par l’opérateur de l’application.
Connecter des modèles à des agents de programmation
Lorsque des agents de programmation ont besoin d’accéder à des modèles, utilisez l’API Developer avec des outils comme Cline, Pi Agent, Kilo Code, OpenCode, OpenHands et n8n. Les requêtes sont déduites du crédit mensuel et les appels réussis sont facturés par token.
Mener des conversations interactives avec un modèle
Pour les conversations ou jeux de rôle saisis par l’acheteur, utilisez l’offre Chat avec un client compatible comme SillyTavern, RisuAI ou Wyvern. Elle comprend des tokens illimités, un contexte de 32K et quatre unités concurrentes, sous réserve de l’usage interactif humain.
Réserver une capacité d’inférence dédiée
Lorsqu’une charge de travail nécessite une capacité GPU réservée, indiquez les modèles ou accélérateurs, la quantité, la durée et la région. Featherless dimensionne et exploite une configuration dédiée pour l’inférence ; celle-ci dépend de la charge demandée.
Limites
L’offre Chat est réservée à l’usage interactif piloté par l’acheteur ; le trafic d’application ou API, la revente, l’automatisation en arrière-plan et le benchmarking sont exclus.
Chat fournit un contexte de 32K et quatre unités concurrentes ; Developer indique jusqu’à 256K de contexte et 100 unités concurrentes.
Les requêtes API Developer s’arrêtent lorsque le solde de crédits est épuisé et reprennent uniquement après l’ajout de crédits.
Business propose un prix personnalisé, des contrats annuels et des tarifs de volume ; capacité et concurrence dépendent des GPU sélectionnés.
Public cible
Développeurs d’applications ayant besoin d’inférence hébergée de modèles ouverts via API
Développeurs exploitant des agents de programmation ou des applications de production avec trafic API
Personnes souhaitant discuter avec un modèle via des clients frontend compatibles
Équipes ayant besoin de GPU réservés, de modèles affinés privés ou d’un contrat à coût fixe
Questions fréquentes
Faut-il héberger ses propres GPU pour utiliser Featherless ?
Non. L’API d’inférence serverless exécute les modèles sur l’infrastructure exploitée par Featherless. Le client choisit un modèle et utilise une clé API, sans provisionner de GPU ni charger les poids du modèle.
Comment les requêtes API Developer sont-elles facturées ?
Les requêtes réussies sont facturées selon les tarifs d’entrée et de sortie par token du modèle choisi. Les requêtes échouées sont gratuites, les crédits inutilisés n’expirent pas et les appels sont suspendus lorsque le solde est épuisé.
Chat peut-il servir au trafic d’application ou d’API ?
Non. Chat est destiné à l’usage interactif piloté par l’acheteur. Le trafic d’application ou API, la revente, l’automatisation en arrière-plan et le benchmarking sont exclus.
Que se passe-t-il lorsqu’un modèle est temporairement saturé ?
Un modèle saturé peut renvoyer une erreur HTTP 503 ; la tentative échouée n’est pas facturée. Réessayez ou choisissez un autre modèle. La FAQ des tarifs conseille de contacter le support si le problème persiste.
Peut-on passer de Chat à Developer pour obtenir plus de contexte ?
Oui. Le passage de Chat à Developer prend effet immédiatement, mais ne crédite ni ne rembourse la période Chat déjà payée. Le passage au renouvellement évite de perdre cette période prépayée.
Que comprend l’offre Business ?
Business est un contrat personnalisé destiné aux équipes qui ont besoin d’une latence garantie et d’un coût fixe. Sont indiqués des GPU dédiés, l’absence de limites partagées, des modèles affinés privés, des ingénieurs attitrés et un SLA ; les contrats sont annuels avec tarifs de volume.

Commentaires