DeepInfer
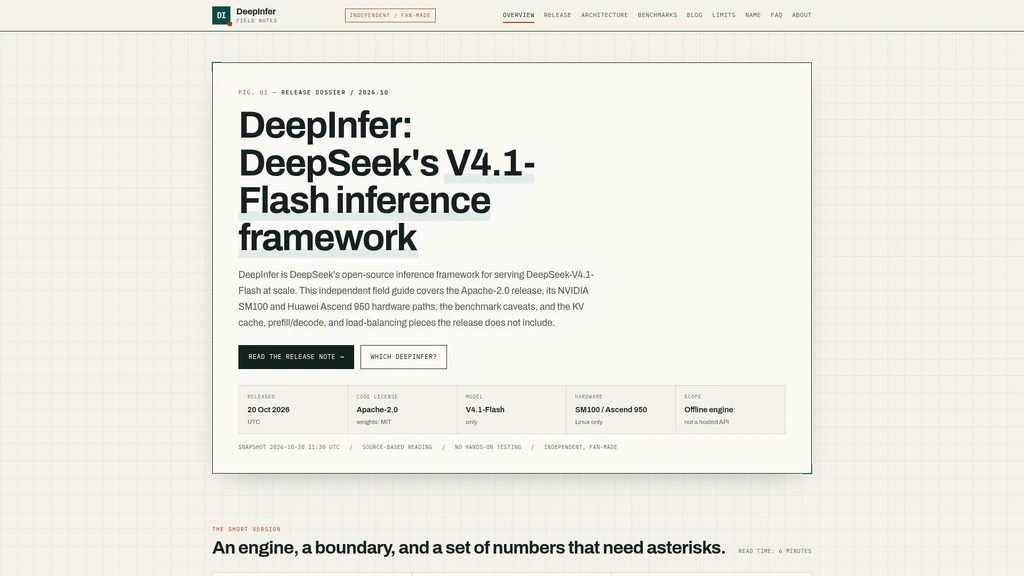
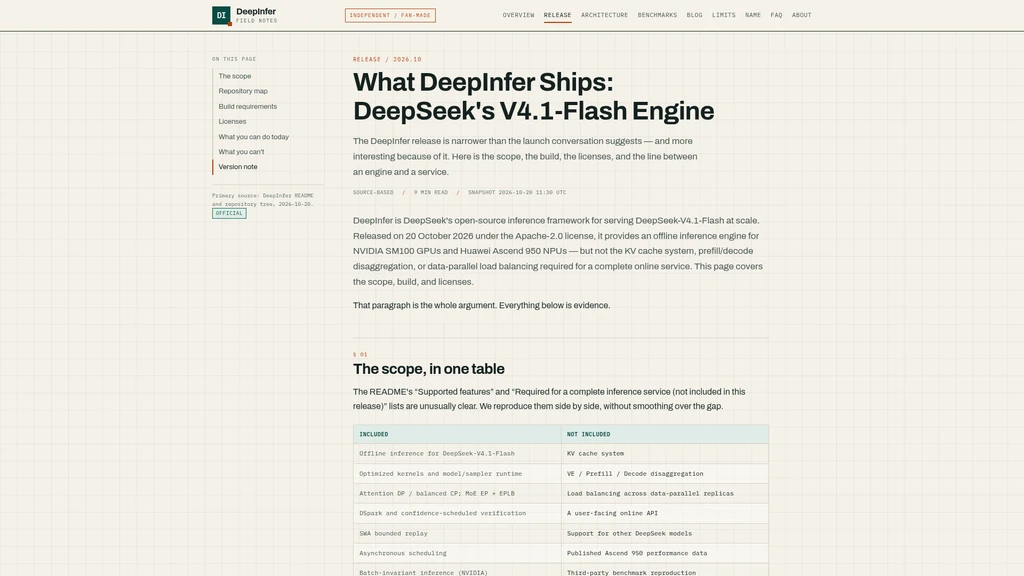
DeepInfer est le framework d'inférence hors ligne open-source de DeepSeek sous licence Apache-2.0, conçu pour déployer DeepSeek-V4.1-Flash à grande échelle. Il prend en charge les matériels NVIDIA SM100 et Huawei Ascend 950 fonctionnant sous Linux, et sa documentation est hébergée sur un site de référence indépendant créé par la communauté, qui couvre les détails des versions, l'architecture, les précautions relatives aux benchmarks et les composants non inclus. Cet outil n'est pas une API hébergée, un service en ligne destiné aux utilisateurs, ni une pile de diffusion de bout en bout complète.
Capacités principales
DeepInfer est fourni avec une pile de composants optimisés pré-intégrés, spécialement conçus pour DeepSeek-V4.1-Flash :
Un ensemble complet de noyaux personnalisés incluant FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect et des noyaux TileLang personnalisés, assemblés à partir de composants de noyaux DeepSeek précédemment publiés pour former un seul moteur unifié.
Une configuration de parallélisme qui associe le parallélisme d'experts (EP) pour les couches MoE, le parallélisme de données d'attention (DP) et le parallélisme de contexte équilibré (CP), conçue pour répartir les experts sur 64 à 128 GPU dans les déploiements de production, avec des copies redondantes pour rééquilibrer les experts sollicités.
Un décodage spéculatif DSpark avec vérification variable, qui utilise une tête de confiance pour identifier les jetons de brouillon nécessitant une validation complète du modèle, offrant un gain de débit de 4 à 7 % selon les rapports, dans les conditions de fonctionnement de production standard.
Une relecture limitée de l'attention à fenêtre glissante (SWA), qui limite le coût de recalcul en ne relisant que la partie récente de la fin du cache, au lieu de reconstruire l'intégralité du cache de fenêtre glissante sur chaque couche, pour une surcharge de calcul prévisible et limitée.
Une planification asynchrone qui exécute le travail de préparation des lots sur le CPU en parallèle de l'exécution active sur le GPU, éliminant les intervalles d'inactivité entre les étapes de décodage consécutives.
Des modes d'inférence invariable par lot et d'échantillonnage déterministe, disponibles exclusivement sur le matériel NVIDIA, pour des benchmarks vérifiables et un comportement cohérent des agents.
Une prise en charge native des sorties structurées pour les expressions régulières, les définitions de schéma JSON et les contraintes de grammaire EBNF.
La bibliothèque complémentaire deepseek-recipe, un dépôt distinct sous licence MIT qui fournit des utilitaires de conversion de protocole API et de tokenisation.
L'exécution complète de l'inférence hors ligne pour le modèle DeepSeek-V4.1-Flash.
Publics cibles
DeepInfer est conçu pour trois groupes d'utilisateurs principaux :
Les développeurs travaillant directement avec le modèle DeepSeek-V4.1-Flash qui ont besoin d'un contrôle de bas niveau sur l'exécution de l'inférence.
Les chercheurs en moteurs d'inférence qui étudient les schémas d'optimisation de LLM de qualité production, y compris le large parallélisme d'experts, le décodage spéculatif guidé par la confiance et la relecture limitée du cache.
Les ingénieurs qui créent une infrastructure de diffusion de LLM personnalisée et souhaitent adapter les optimisations d'inférence dérivées de la production de DeepSeek pour leurs propres déploiements.
Flux de travail pris en charge
Le framework est conçu pour les charges de travail d'inférence hors ligne centrées sur DeepSeek-V4.1-Flash, sans couche de diffusion préconçue destinée aux utilisateurs. Les modèles d'utilisation typiques incluent :
L'intégration de la pile de noyaux pré-optimisés et de la configuration de parallélisme dans des pipelines d'inférence internes personnalisés pour DeepSeek-V4.1-Flash.
Le test et la vérification du comportement d'inférence déterministe pour les benchmarks ou les charges de travail d'agents sur le matériel NVIDIA.
La mise en œuvre de contraintes de sortie structurées pour les charges de travail DeepSeek-V4.1-Flash sans middleware tiers supplémentaire.
L'extension du moteur de base pour créer des composants de diffusion personnalisés répondant à des exigences spécifiques d'infrastructure interne.
La recherche et la modification des optimisations d'inférence de LLM de pointe, y compris le décodage spéculatif et l'équilibrage de charge MoE.
Limitations et fonctionnalités explicitement non incluses
DeepInfer a un champ d'application étroit et défini, et n'est pas fourni avec les composants nécessaires pour former une pile complète de diffusion en ligne de production :
Il n'inclut pas de système de cache KV persistant capable de survivre à des requêtes distinctes ou à plusieurs machines.
Il n'implémente pas de désagrégation pré-remplissage/décodage pour répartir les charges de travail sur des pools de matériels dédiés distincts.
Il n'inclut pas d'équilibrage de charge par parallélisme de données sur plusieurs réplicas d'inférence.
Il ne s'agit pas d'une API en ligne destinée aux utilisateurs, et il n'est pas fourni avec un serveur compatible OpenAI, de l'authentification, de la gestion des quotas, de la facturation ou des outils d'observabilité.
Ce n'est pas un moteur d'inférence polyvalent, et il ne prend en charge que le modèle DeepSeek-V4.1-Flash, sans prise en charge officielle des autres modèles DeepSeek ou de LLM tiers.
Aucune donnée de performance publiée n'est disponible pour le matériel Huawei Ascend 950 au moment de la sortie.
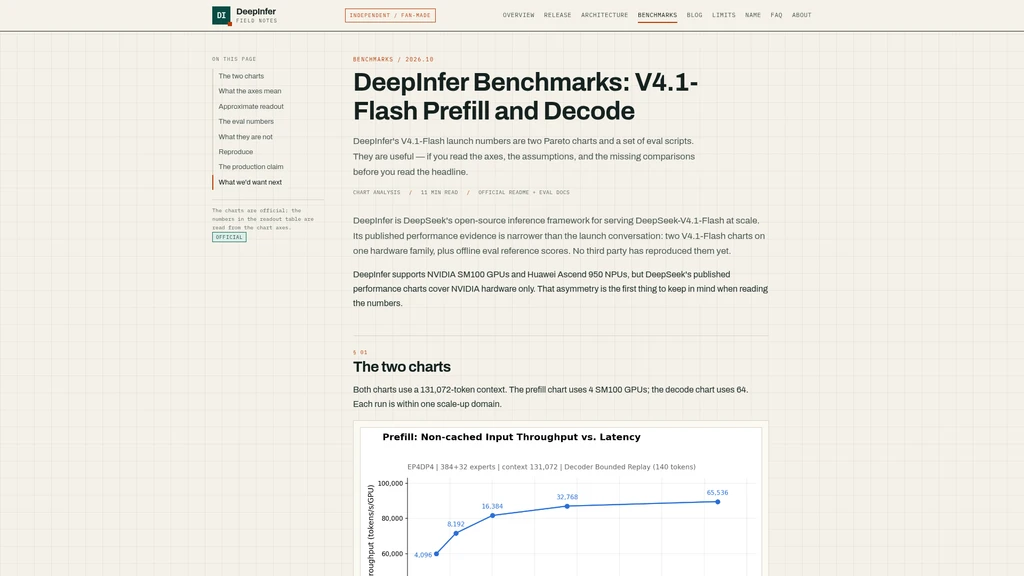
Aucune reproduction indépendante par un tiers des graphiques de benchmarks officiels n'a été publiée à la date de l'instantané de version du 20 octobre 2026.
Toutes les données de benchmarks officielles sont mesurées avec une longueur de contexte de 131 072 jetons, et non avec le contexte maximal de 1 million de jetons pris en charge par le modèle DeepSeek-V4.1-Flash, et les chiffres de performance de décodage publiés supposent un taux d'acceptation des jetons de brouillon de 75 %, qui varie en fonction de la complexité du texte d'entrée.
Le framework ne prend en charge aucun matériel autre que NVIDIA SM100 et Huawei Ascend 950 sous Linux, sans prise en charge officielle des autres générations de GPU NVIDIA ou puces Ascend.
Licence et accès
DeepInfer est publié sous la licence permissive Apache-2.0, et est disponible gratuitement au téléchargement, à la modification et à l'auto-hébergement, sans frais directs associés. La bibliothèque complémentaire deepseek-recipe est publiée sous la licence MIT. Le site de référence indépendant créé par la communauté qui couvre le projet n'est pas affilié à DeepSeek, NVIDIA ou Huawei, et toutes les déclarations sur les produits présentes sur le site de référence sont attribuées directement à des sources officielles publiques.




Commentaires