
- Visites mensuelles
- 223
- 2026-10
- Croissance mensuelle +7 333,3 %
daVinci-MagiHuman - Créez une vidéo parlante synchronisée à partir d’un portrait et de texte ou d’audio
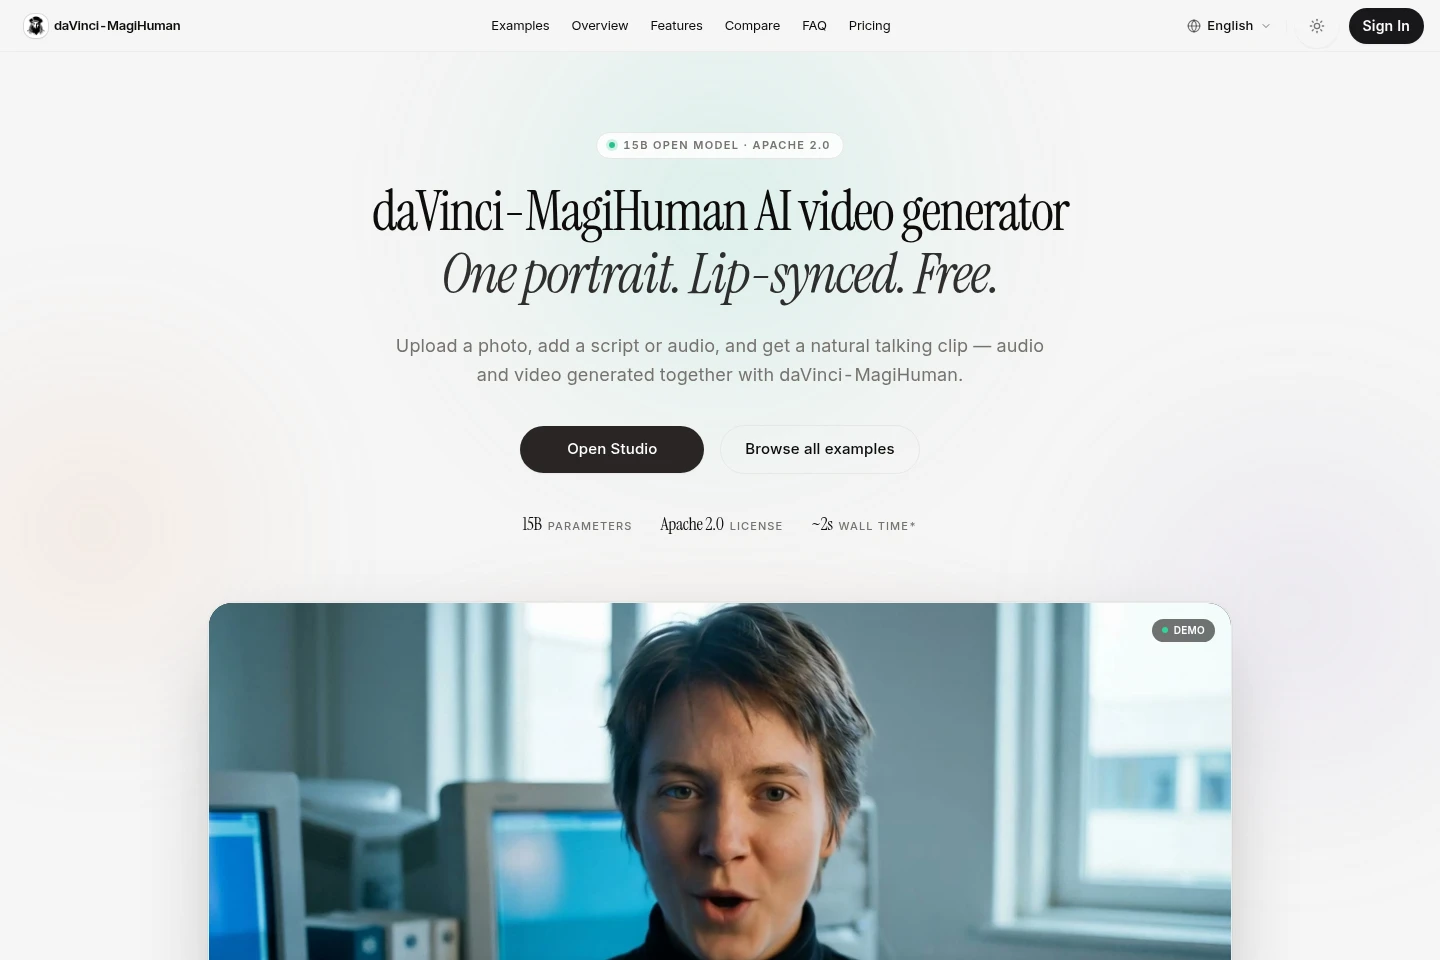
daVinci-MagiHuman est un modèle d’IA open source de 15 milliards de paramètres destiné à générer des vidéos de portraits parlants. Il reçoit une photo de portrait et du texte ou de l’audio, puis génère une voix et une vidéo synchronisées. Le modèle est publié sous licence Apache 2.0 pour l’inférence locale et l’usage commercial, sous réserve de ses conditions. Un studio en ligne est également proposé, avec des abonnements et des crédits facturés séparément.
- Vidéo IA
- Avatars IA
- générateur de vidéos parlantes par IA
- modèle de synchronisation labiale de portrait
- IA audio-vidéo open source
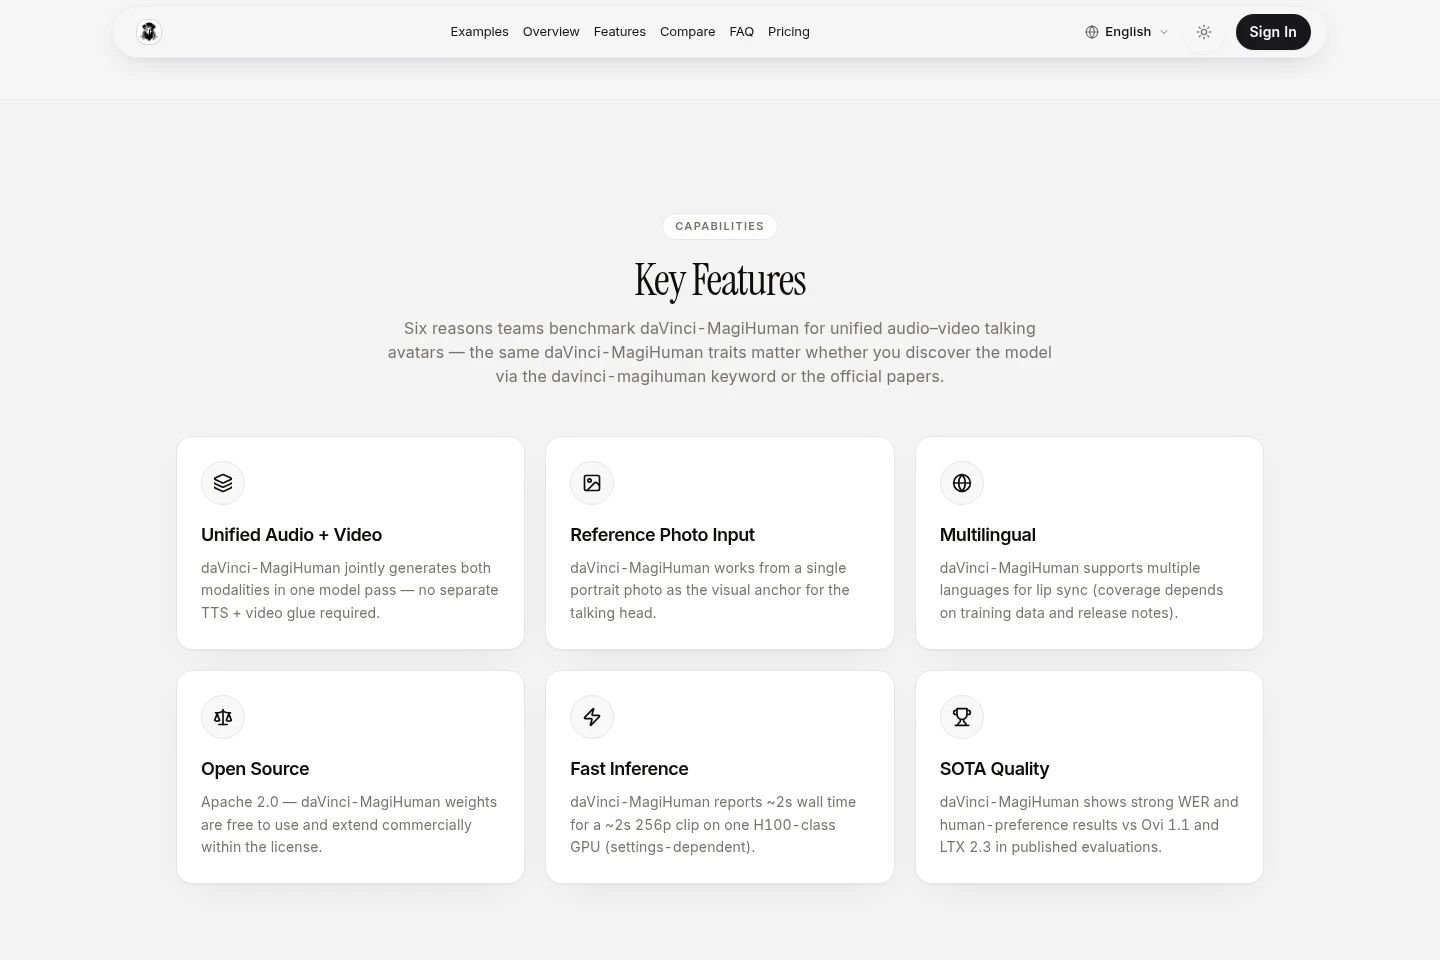
Fonctionnalités
Génération de vidéos parlantes
Génère une vidéo parlante synchronisée avec l’audio correspondant. Les entrées sont un portrait et un script ou un fichier audio ; la résolution de sortie et la vitesse d’inférence dépendent des réglages et du matériel disponible.
Génération audio-vidéo conjointe
Génère l’audio et la vidéo ensemble en un seul passage du modèle. Le Transformer à flux unique traite conjointement les jetons audio et vidéo, sans nécessiter des chaînes séparées de synthèse vocale et de vidéo.
Inférence locale du modèle
Exécute l’inférence localement avec les poids publiés. Téléchargez les checkpoints et suivez le README amont pour la configuration, les scripts d’inférence et les options de ligne de commande ; le matériel influe sur le débit.
Studio vidéo en ligne
Fournit un flux hébergé de génération vidéo par IA. Le studio est accessible en ligne ; les abonnements et les crédits achetables séparément figurent sur la page des tarifs.
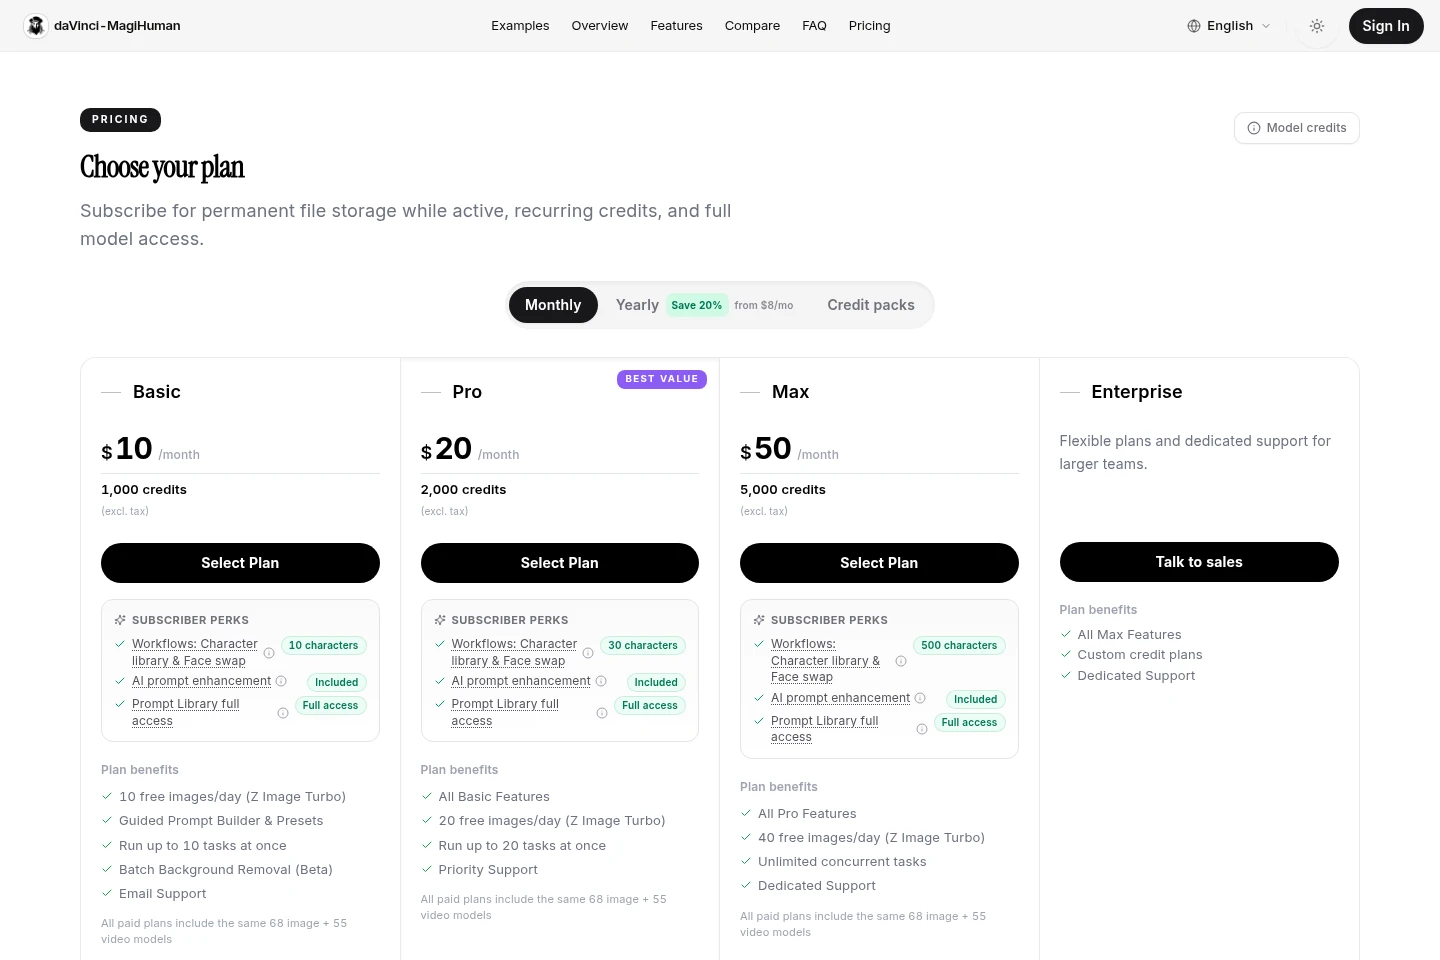
Tarifs
Le studio hébergé propose un accès gratuit, des abonnements mensuels ou annuels et des achats ponctuels de crédits. Comparez le volume de crédits, les images gratuites quotidiennes, les tâches simultanées, les limites de personnages, l’assistance et l’accès aux modèles.
| Offre | Prix | Fonctionnalités et limites |
|---|---|---|
| Basic | 10 $ par mois |
|
| Pro | 20 $ par mois |
|
| Max | 50 $ par mois |
|
| Enterprise | Offres flexibles ; contacter les ventes |
|
| Pay-as-you-go credits | Achat ponctuel ; prix variable |
|
Les abonnements annuels sont facturés une fois pour l’année complète à un tarif effectif réduit ; la page annonce 20 % d’économies. Les abonnements se renouvellent automatiquement. Les nouveaux abonnements bénéficient d’un délai de remboursement de sept jours ; les problèmes de renouvellement doivent être signalés sous 72 heures.
Cas d’utilisation
Créer un portrait vidéo synchronisé
Pour faire prononcer un texte ou un audio fourni à un portrait, transmettez l’image et le texte ou l’audio. Le modèle génère une vidéo parlante dont les mouvements des lèvres sont synchronisés avec la voix.
Exécuter l’inférence vidéo sur son matériel
Lorsque des développeurs ou chercheurs veulent exécuter le modèle localement ou sur un serveur, ils récupèrent les checkpoints sur Hugging Face et configurent l’inférence à l’aide du README du projet. La génération s’effectue ensuite sur le matériel choisi.
Générer des vidéos dans le studio hébergé
Pour générer en ligne sans installer le modèle, ouvrez le studio vidéo IA et lancez une tâche prise en charge. La page des tarifs décrit les abonnements, les crédits et leur consommation selon la génération.
Limites
Dans l’abonnement hébergé, les requêtes sont suspendues lorsque le solde de crédits atteint zéro ; l’achat de crédits à la demande ou le changement d’abonnement permet de reprendre la génération.
Les langues prises en charge pour la synchronisation labiale dépendent des données d’entraînement et du modèle publié ; la liste actuelle figure dans le README officiel.
La vitesse d’inférence dépend des réglages et du matériel ; l’indication d’environ deux secondes concerne un clip 256p d’environ deux secondes sur un GPU de classe H100.
L’utilisation commerciale du modèle est soumise aux conditions de la licence Apache 2.0, notamment aux mentions et obligations d’attribution applicables.
Les crédits achetés à la demande n’expirent pas ; les crédits d’abonnement sont attribués selon un cycle mensuel ou annuel.
Public cible
Développeurs qui intègrent ou exécutent un modèle vidéo parlant open source
Chercheurs qui évaluent les modèles de génération audio-vidéo
Créateurs qui souhaitent générer des portraits vidéo parlants en ligne
Questions fréquentes
Que génère daVinci-MagiHuman ?
À partir d’un portrait et de texte ou d’audio, il génère une vidéo parlante synchronisée avec l’audio correspondant. Le modèle génère l’audio et la vidéo ensemble.
Le modèle est-il gratuit ?
Les poids du modèle et le code publiés sont disponibles sous licence Apache 2.0. Les abonnements et crédits du studio hébergé ont des tarifs et conditions distincts.
Puis-je utiliser daVinci-MagiHuman à des fins commerciales ?
Oui, sous réserve du respect des conditions Apache 2.0. Vérifiez les obligations de licence applicables à votre usage, notamment les mentions et l’attribution.
Quelles langues sont prises en charge pour la synchronisation labiale ?
La couverture dépend du modèle publié et de ses données d’entraînement. Consultez le README officiel pour la liste actuelle et les éventuelles réserves régionales.
Comment les crédits du studio en ligne sont-ils facturés ?
La consommation dépend de la durée de sortie et de réglages comme la résolution et le mode. La FAQ des tarifs donne des exemples approximatifs ; le studio affiche les totaux en temps réel.
Les crédits à la demande expirent-ils ?
Non. Les crédits achetés avec l’option ponctuelle n’expirent pas ; les crédits d’abonnement sont attribués mensuellement ou annuellement.

Commentaires