
- Visites mensuelles
- 3 505
- 2026-10
- Croissance mensuelle -57,8 %
crawler.sh - Exploration locale, extraction Markdown et analyse SEO
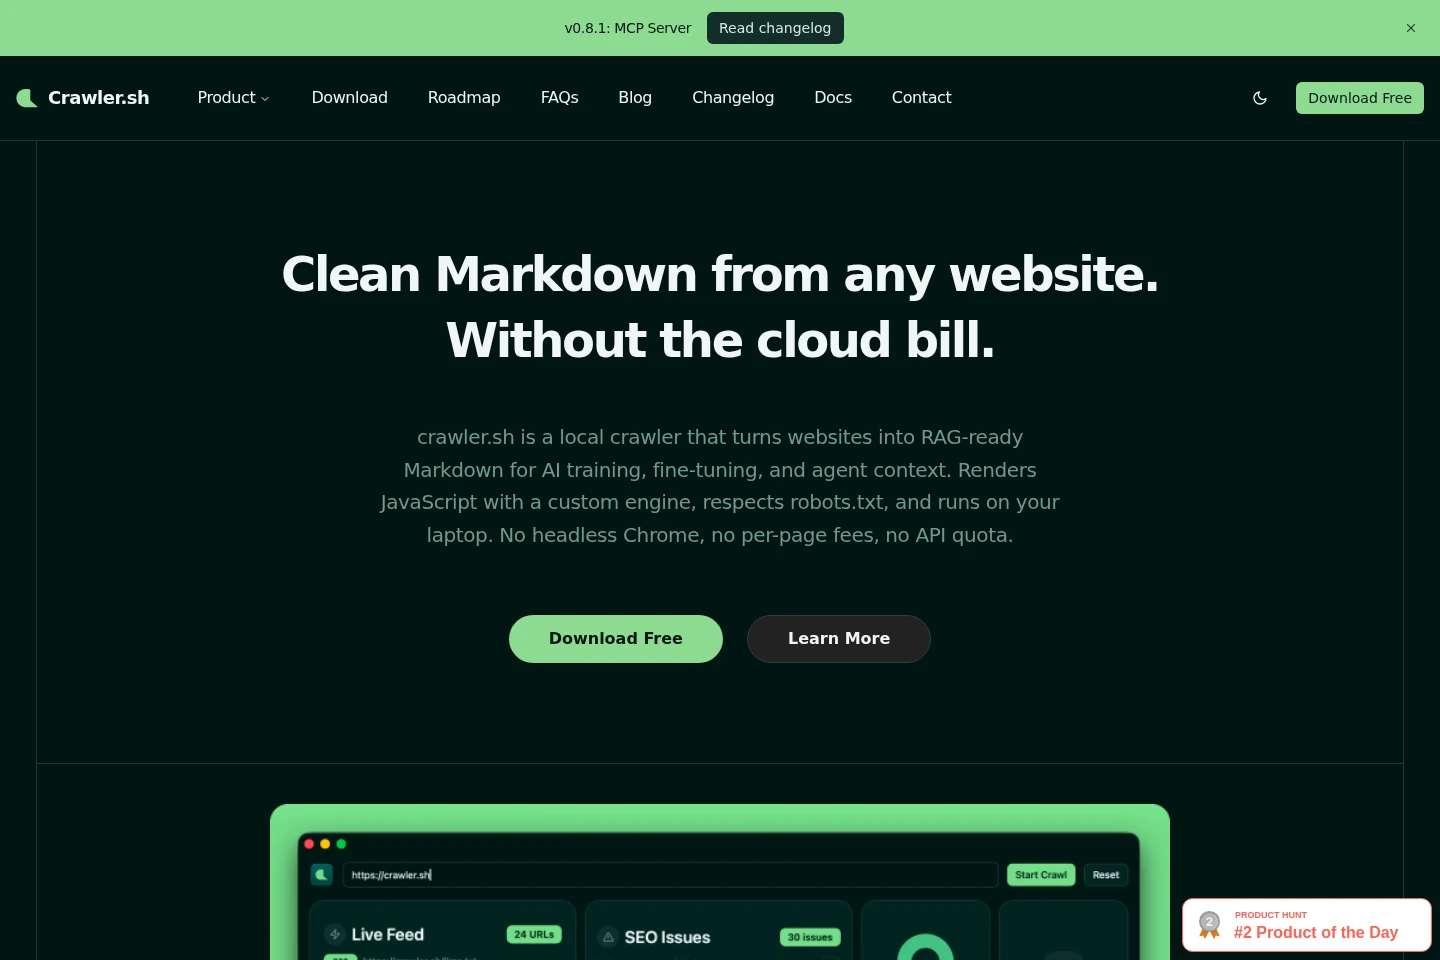
crawler.sh est un explorateur web local disponible en CLI et en application de bureau. Il extrait les articles en Markdown, rend les pages dépendantes de JavaScript et vérifie les pages explorées pour repérer les problèmes SEO. Il respecte robots.txt, exporte les résultats dans plusieurs formats et fonctionne sur l’appareil de l’utilisateur. L’offre gratuite permet jusqu’à 50 pages par session ; CLI Pro en permet jusqu’à 10 000.
- Marketing IA
- Outils SEO
- Web scraping
- explorateur de sites local
- extraction de contenu Markdown
- audit SEO
Fonctionnalités
Exploration de sites web
Explore les sites localement et enregistre les résultats des pages pour les examiner ou les exporter. La concurrence, les nouvelles tentatives et le rendu sont configurables ; robots.txt est respecté et le rythme s’adapte après des réponses 429 ou 403.
Extraction Markdown
Extrait l’article principal des pages HTML et produit un Markdown lisible avec le nombre de mots, la signature de l’auteur et un extrait. L’extraction est activée par défaut et peut être désactivée avec --no-extract.
Rendu JavaScript
Rend les pages dépendantes du JavaScript côté client à l’aide d’un moteur intégré. Le mode Auto détecte si le rendu est nécessaire ; --render le force et --no-render le désactive.
Analyse SEO
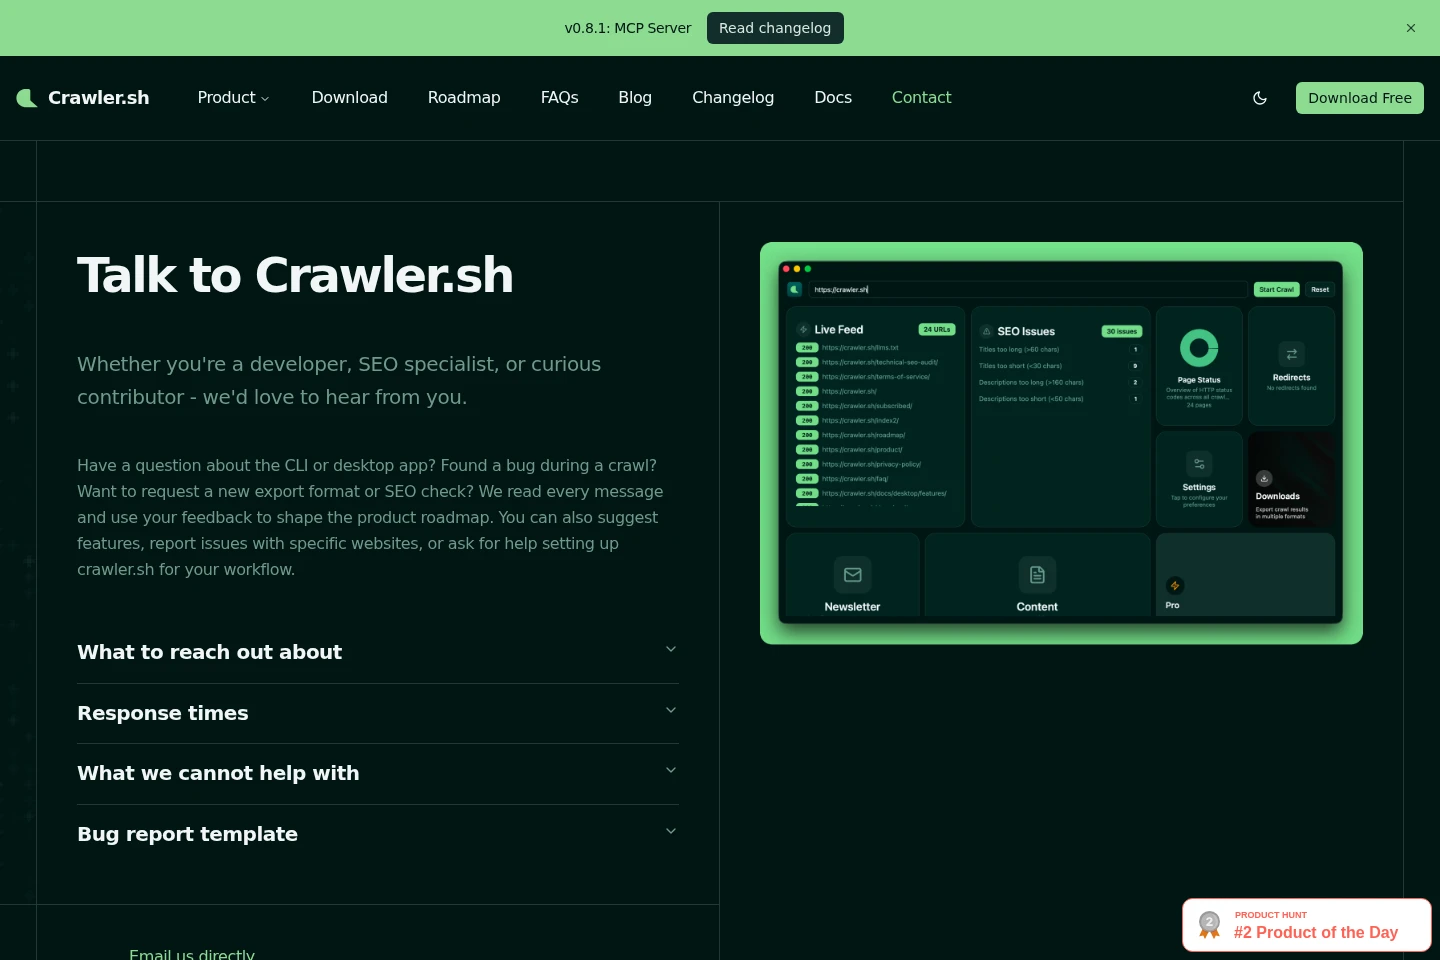
Vérifie les pages explorées pour repérer les problèmes SEO et exporte les résultats regroupés en CSV ou TXT. L’analyse couvre 24 catégories et ne traite que les pages HTML avec une réponse 2xx.
Export des données et du site
Exporte les données d’exploration en NDJSON, JSON ou Sitemap XML conforme au W3C ; les résultats SEO sont disponibles en CSV ou TXT. Pro Content Archive place chaque page extraite dans un fichier Markdown distinct d’une archive ZIP.
Tarifs
Une offre gratuite est disponible et les offres Pro payantes fonctionnent par abonnement. Comparez les limites par session, l’interface, l’analyse et les formats d’export. Free coûte $0 et CLI Pro est facturé à l’année ; le prix de Desktop Pro n’est pas indiqué.
| Offre | Prix | Fonctionnalités et limites |
|---|---|---|
| Free | $0 |
|
| CLI Pro | $99 par an |
|
| Desktop Pro | Prix non indiqué |
|
Un abonnement couvre la CLI et l’application de bureau. La page produit indique que la connexion porte la limite à 400 pages par crawl, sans préciser le prix ni les conditions de facturation de l’offre correspondante.
Cas d’utilisation
Préparer du contenu web pour des flux IA
Lorsque des pages web sont nécessaires au RAG, au fine-tuning ou au contexte d’agents, le site peut être exploré et son texte principal extrait. crawler.sh enregistre localement du Markdown propre et les métadonnées des pages pour les processus suivants.
Vérifier les problèmes SEO d’un site
Pour contrôler un site avant son lancement ou pendant sa maintenance, explorez ses pages et lancez l’analyse SEO. Consultez les problèmes regroupés, exportez-les en CSV ou TXT, puis examinez les URL concernées.
Créer une archive Markdown du contenu
Pour sauvegarder du contenu ou le transférer vers un autre processus, explorez les pages et exportez le contenu extrait. Pro Content Archive crée une archive ZIP contenant un fichier Markdown par page extraite.
Générer un plan de site depuis un crawl
Lorsque le plan de site doit refléter les pages explorées, lancez un crawl et exportez un Sitemap XML conforme au W3C. Le fichier généré peut servir de plan de site web.
Limites
Sans compte, la limite est de 50 pages par session ; la connexion la porte à 400 pages par crawl, et CLI Pro permet jusqu’à 10 000 pages par session.
L’analyse SEO traite uniquement les pages HTML qui renvoient une réponse 2xx.
La FAQ indique que Windows est sur la feuille de route ; elle liste actuellement macOS et Linux pour la CLI et l’application de bureau.
L’assistance est proposée en anglais ; l’équipe indique qu’elle fera de son mieux pour comprendre et répondre aux messages dans d’autres langues.
L’équipe n’explore pas les sites pour le compte des utilisateurs, ne crée pas de tableaux de bord sur mesure et ne rédige pas de rapports SEO personnalisés payants.
Aucune assistance téléphonique, SLA de tickets ni gestionnaire de compte dédié n’est proposé, y compris avec Pro.
Public cible
Développeurs ayant besoin d’exploration locale dans des scripts, tâches planifiées ou pipelines CI
Spécialistes SEO qui vérifient les problèmes techniques d’un site et exportent des rapports
Personnes préparant du texte web en Markdown pour le RAG, le fine-tuning ou le contexte d’agents
Responsables de sites souhaitant archiver du contenu, générer des plans de site ou suivre les changements
Questions fréquentes
Quels systèmes d’exploitation crawler.sh prend-il en charge ?
La CLI et l’application de bureau sont disponibles sur macOS et Linux. La FAQ précise Apple Silicon et Intel sur macOS, et x86_64 sur Linux ; Windows est sur la feuille de route.
Faut-il un compte pour explorer un site ?
Non. La CLI et l’application de bureau fonctionnent sans compte, avec une limite de 50 pages par crawl ; la connexion porte cette limite à 400 pages.
crawler.sh peut-il rendre les pages JavaScript ?
Oui. Le moteur intégré détecte les frameworks JavaScript côté client en mode Auto. Utilisez --render pour forcer le rendu ou --no-render pour le désactiver.
Quels formats crawler.sh peut-il exporter ?
Les données d’exploration peuvent être exportées en NDJSON, JSON ou Sitemap XML ; les rapports SEO en CSV ou TXT. Pro Content Archive exporte aussi les pages extraites en fichiers Markdown dans un ZIP.
Comment fonctionne l’extraction de contenu ?
Lorsqu’elle est activée, crawler.sh extrait l’article principal des pages HTML en Markdown et fournit le nombre de mots, la signature de l’auteur et un extrait. Elle est active par défaut et peut être désactivée avec --no-extract.
Quelles pages sont prises en compte par l’analyse SEO ?
Seules les pages HTML avec une réponse 2xx sont analysées. La commande SEO vérifie 24 catégories, dont les métadonnées, titres, liens, URL canoniques et signaux de fraîcheur du contenu.
Commentaires