
- Visitas mensuales
- 7580
- 2026-09
- Crecimiento mensual +44 %
Transcrisper - Transcribe audio y video de forma privada en tu navegador
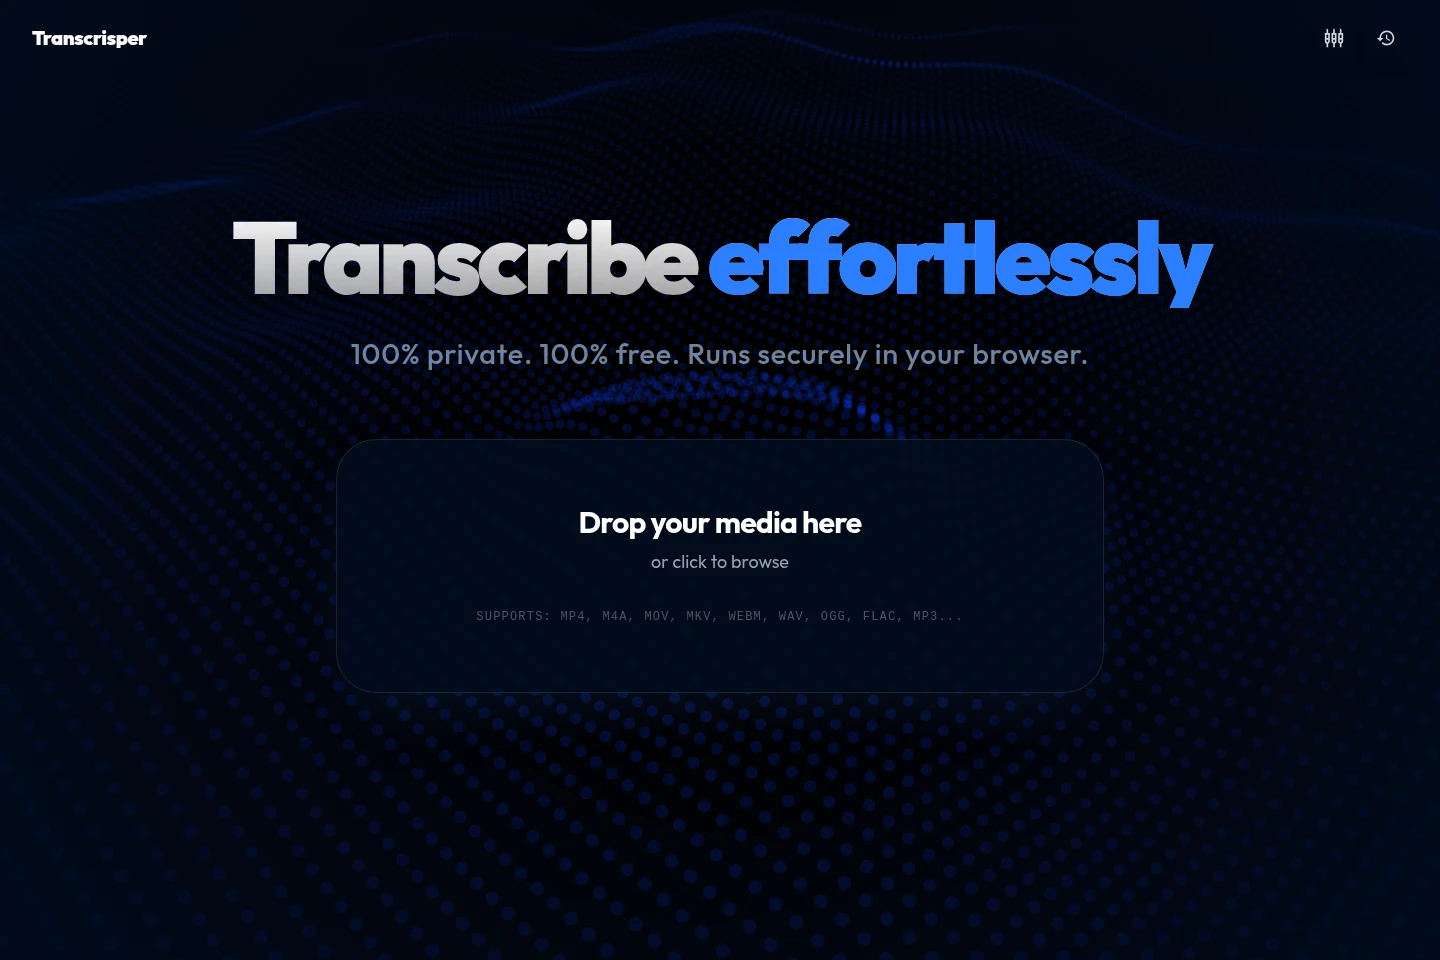
Transcrisper transcribe audio y video localmente en el navegador con el modelo de reconocimiento de voz Parakeet-TDT v3 y la diarización de hablantes Sortformer v2.1. Admite formatos como MP4, M4A, MOV, MKV, WEBM, WAV, OGG, FLAC y MP3. Después de descargar e inicializar los modelos, puedes transcribir sin conexión y sin subir el audio a un servidor.
- Audio con IA
- Transcripción
- Editor de audio
- transcripción privada en navegador
- transcripción de audio y video
- transcripción de IA sin conexión
Funciones
Transcripción local de audio y video
Transcribe archivos de audio y video en el navegador y genera texto a partir del habla. El usuario selecciona archivos multimedia compatibles y Parakeet-TDT v3 los procesa localmente después de descargar los datos del modelo.
Diarización de hablantes
Agrupa segmentos de audio en distintos grupos de hablantes durante la transcripción. Sortformer v2.1 analiza biometría de voz, admite diarización en streaming y se describe como capaz de manejar voces superpuestas.
Procesamiento de transcripción sin conexión
Permite transcribir sin conexión a Internet cuando los modelos ya se inicializaron y almacenaron en caché en el navegador. La configuración inicial requiere descargar casi 2 GB de datos por navegador.
Herramientas para subtítulos y audio
Ofrece herramientas en el navegador para convertir y ajustar archivos de subtítulos y audio. Incluye conversión de formatos de subtítulos, ajuste de tiempo, recorte de audio, conversión de audio y conversión de video a audio.
Precios
Transcrisper es gratis y no se muestran planes de pago. No hay niveles que comparar; la transcripción se ejecuta localmente en el navegador.
Casos de uso
Transcribir grabaciones localmente
Cuando se necesita transcribir una grabación sin enviar el archivo a un servidor de transcripción, el usuario puede seleccionar un archivo de audio o video compatible en el navegador. Transcrisper lo procesa localmente con Parakeet-TDT v3 y genera texto a partir del habla.
Agrupar segmentos de grabación por hablante
Si una grabación incluye varias personas o voces superpuestas, el usuario puede usar la diarización durante la transcripción. Sortformer v2.1 analiza la biometría de voz y agrupa los segmentos de audio en distintos grupos de hablantes.
Convertir y ajustar archivos de subtítulos
Cuando un archivo de subtítulos necesita otro formato o cambios de sincronización, el usuario puede elegir una herramienta como SRT to VTT, SRT to TXT o Subtitle Time Shifter. Las herramientas convierten o ajustan el archivo en el navegador.
Limitaciones
La primera configuración de cada navegador requiere descargar casi 2 GB de datos del modelo; para usarlo sin conexión después, los modelos deben estar en caché.
Para un rendimiento óptimo se recomiendan al menos 16 GB de RAM y una GPU dedicada; se puede usar solo CPU, pero el procesamiento será mucho más lento.
Para mayor estabilidad, se recomienda que los archivos duren menos de dos horas; el límite práctico de tamaño depende de la RAM de la computadora.
La navegación de incógnito o privada puede limitar el almacenamiento, impedir el caché de los modelos y exigir descargar de nuevo el motor de casi 2 GB en cada visita.
Firefox y Safari tienen soporte limitado para WebGPU, lo que puede reducir el rendimiento frente a navegadores basados en Chromium.
Para quién es
Personas que prefieren no subir sus grabaciones a servicios de transcripción en la nube
Periodistas y entrevistadores que transcriben conversaciones grabadas localmente
Profesionales de la salud que quieren procesar audio en su propio dispositivo
Preguntas frecuentes
¿Transcrisper sube el audio a un servidor?
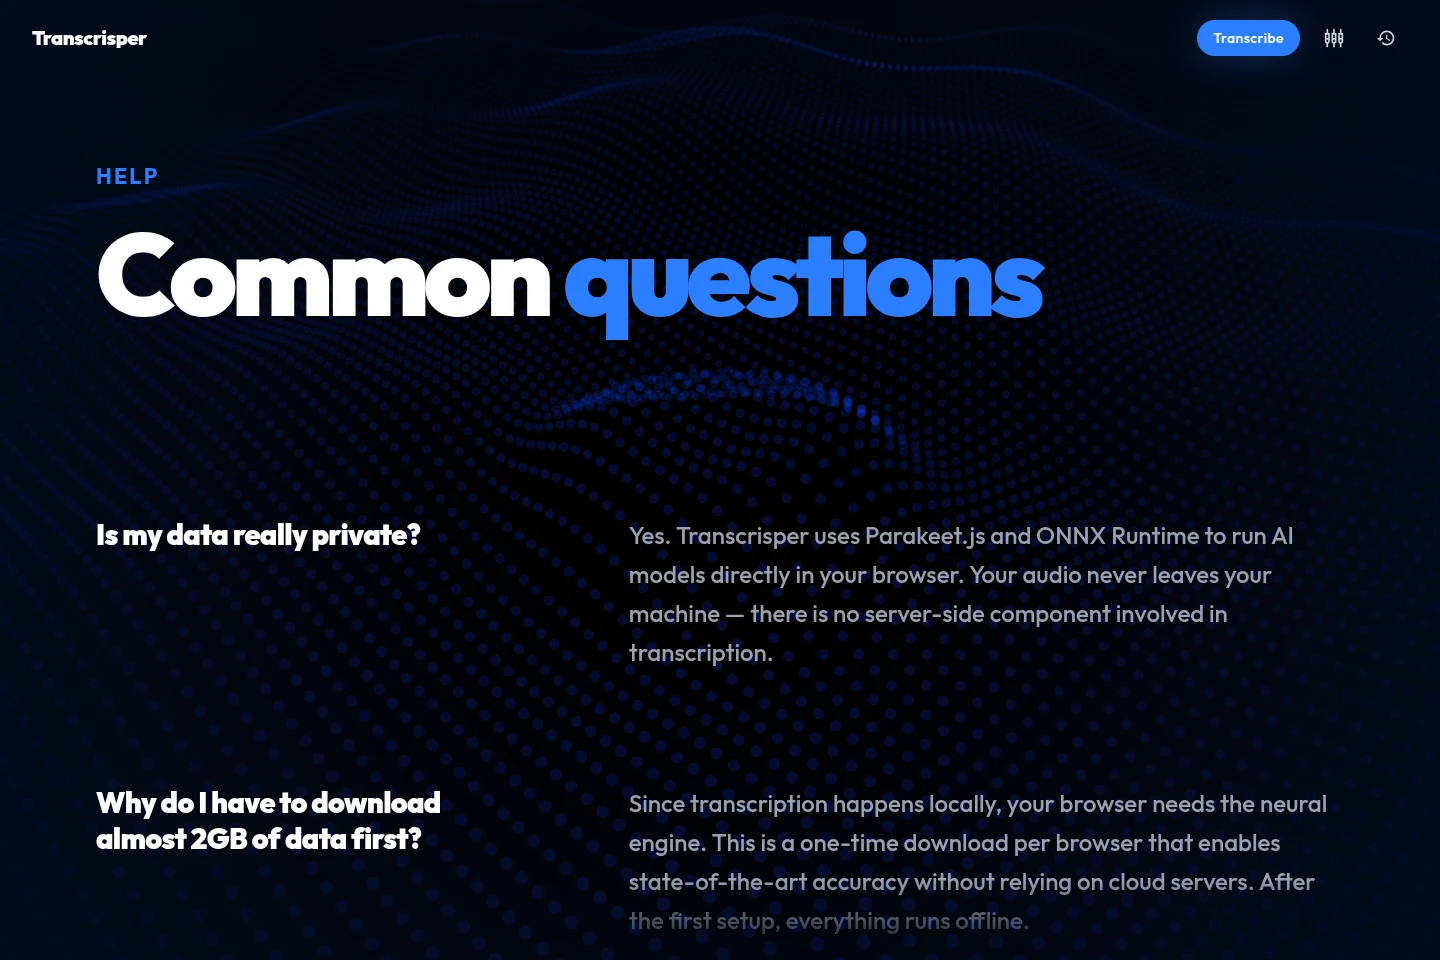
No. La transcripción se ejecuta en el navegador con Parakeet.js y ONNX Runtime, y el audio no sale del dispositivo del usuario.
¿Por qué se necesita descargar un modelo tan grande?
El navegador necesita el motor neuronal para transcribir localmente. La descarga inicial es de casi 2 GB por navegador; después de inicializar y almacenar en caché los modelos, la aplicación puede funcionar sin conexión.
¿Qué idiomas reconoce el modelo de transcripción?
Parakeet-TDT v3 admite inglés, francés, alemán, español, italiano, portugués, neerlandés, polaco, ruso, ucraniano, japonés, coreano y chino. La diarización de hablantes no depende del idioma.
¿Qué recursos de computadora se recomiendan?
Para un rendimiento óptimo se recomiendan al menos 16 GB de RAM y una GPU dedicada. El procesamiento solo con CPU es posible, pero mucho más lento.
¿Hay un límite fijo para el tamaño de archivo?
El límite depende de la RAM de la computadora. Los archivos de menos de dos horas ofrecen mayor estabilidad, aunque equipos más potentes pueden procesar grabaciones más largas.
Comentarios