
- Visitas mensuales
- 23.207
- 2026-09
- Crecimiento mensual +11,2 %
GPUHub - GPU dedicadas e infraestructura elástica para cargas de trabajo de IA
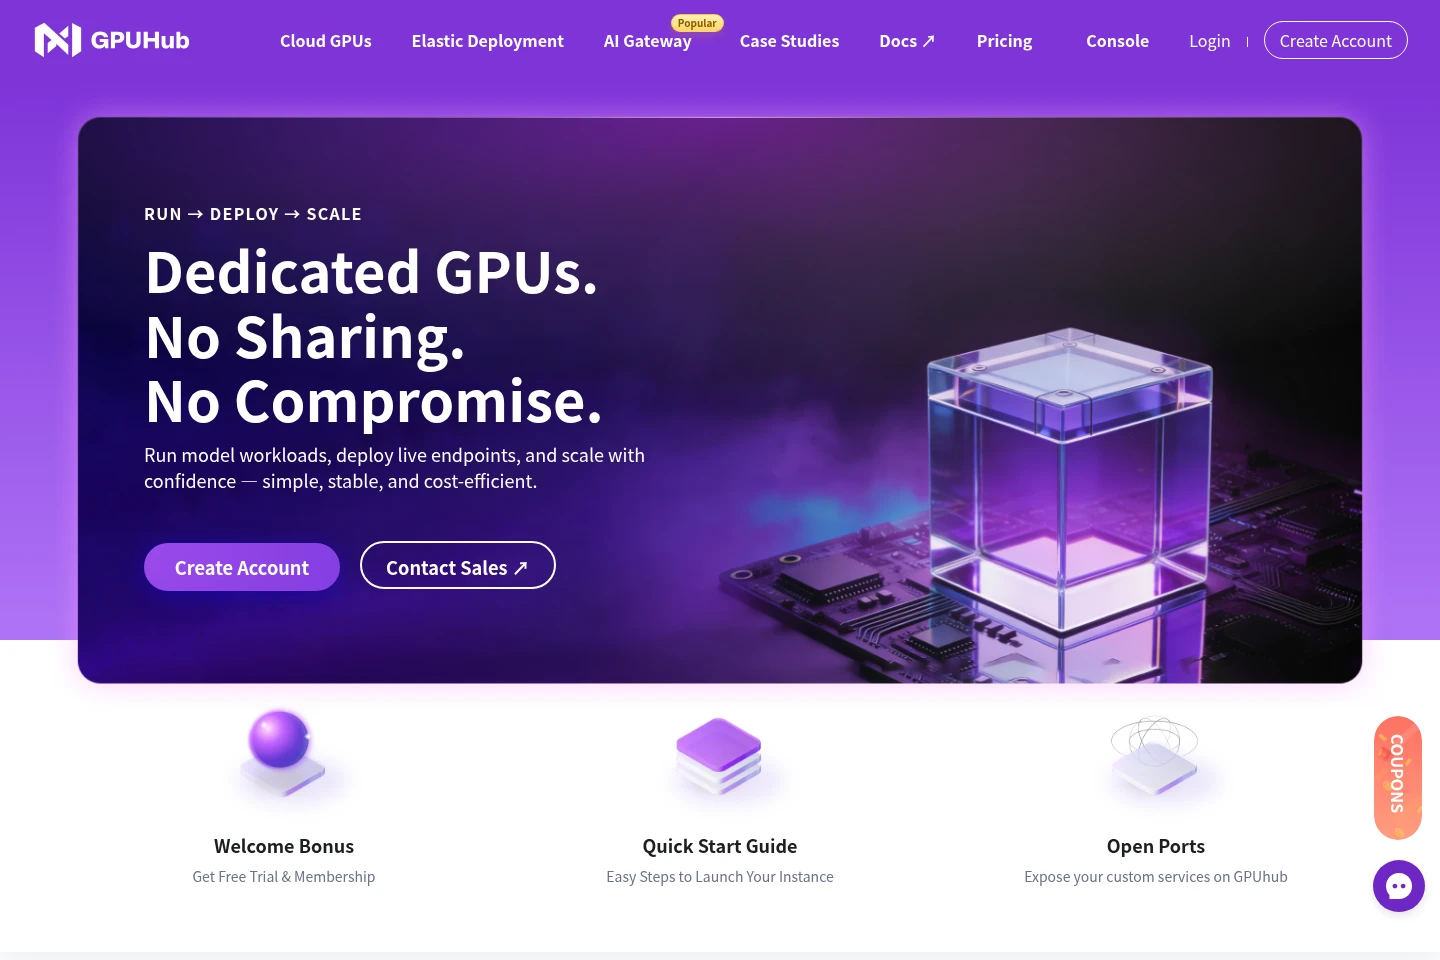
GPUHub ofrece GPU dedicadas bajo demanda para entrenar e inferir modelos, además de despliegue elástico basado en contenedores. AI Gateway permite acceder a Claude, GPT y DeepSeek mediante un endpoint compatible con OpenAI. Los usuarios pueden iniciar imágenes prediseñadas, ejecutar notebooks de JupyterLab y elegir facturación por hora o fija para el cómputo GPU. El precio depende del modelo; la página también menciona mejoras de membresía gratuitas para estudiantes.
- Desarrollo con LLM
- Nube GPU
- APIs de LLM
- nube de GPU dedicada
- API de inferencia de modelos de IA
- despliegue elástico de GPU
Funciones
Cómputo GPU bajo demanda
Inicia cómputo GPU dedicado para cargas de trabajo de modelos y proporciona una instancia en ejecución. Se eligen el modelo de GPU y la imagen prediseñada, y luego la facturación por consumo o fija; la página muestra precios por hora según el modelo y dice que apagar la instancia detiene el medidor.
Despliegue elástico
Despliega contenedores y ajusta las réplicas de GPU según cambie la demanda. El usuario despliega un contenedor y modifica la cantidad de réplicas; la página muestra tres, pero no especifica una cuota.
AI Gateway
Envía solicitudes a Claude, GPT y DeepSeek mediante un endpoint compatible con OpenAI. Los usuarios acceden a los modelos mencionados por medio del gateway; la página no indica cuotas de solicitudes ni un precio separado.
Notebooks de JupyterLab
Inicia una instancia de notebook JupyterLab configurada para programar sobre infraestructura GPU. La página dice que incluye CUDA y frameworks actuales y que inicia en menos de 10 segundos; las imágenes y condiciones dependen de la configuración elegida.
Precios
El cómputo GPU se factura por consumo o con una opción fija; los precios por hora publicados varían según el modelo. Para elegir, compara el precio del modelo y la modalidad de facturación; la página no publica precios ni condiciones de la opción fija.
| Plan | Precio | Funciones y límites |
|---|---|---|
| Standard User | Desde $0.30 por hora |
|
La página menciona mejoras gratuitas de membresía para estudiantes, pero no explica los requisitos ni la duración. Los precios publicados dependen del modelo; no se indican precios ni condiciones para la facturación fija.
Casos de uso
Ejecutar entrenamiento e inferencia de modelos
Cuando las cargas de trabajo de modelos necesitan cómputo GPU dedicado, el usuario elige un modelo de GPU y una imagen, y después inicia una instancia en GPUHub. Los precios por hora se muestran según el modelo; la página dice que se puede apagar la instancia para detener el medidor.
Escalar servicios de GPU en contenedores
Cuando cambia la demanda de un servicio en contenedores, el usuario despliega el contenedor y ajusta las réplicas de GPU con Elastic Deployment. Así puede cambiar la cantidad de réplicas según la carga; no se especifica una cuota fija.
Enviar solicitudes a los modelos de lenguaje disponibles
Cuando una aplicación necesita llamar a Claude, GPT o DeepSeek, el usuario envía solicitudes mediante AI Gateway y su endpoint compatible con OpenAI. La página identifica esos modelos, pero no especifica límites para cada uno.
Trabajar en un notebook JupyterLab con GPU
Cuando se necesita un entorno interactivo de programación en infraestructura GPU, el usuario inicia el notebook JupyterLab configurado. GPUHub indica que incluye CUDA y frameworks y que inicia en menos de 10 segundos; la disponibilidad depende de la configuración de cómputo elegida.
Limitaciones
El precio y el cómputo GPU disponible dependen del modelo elegido; la página muestra distintos precios por hora para cada modelo.
La página describe facturación por consumo y fija para instancias GPU, pero no especifica los precios ni las condiciones de la facturación fija.
La información disponible sobre AI Gateway menciona Claude, GPT y DeepSeek, pero no indica cuotas de solicitudes ni límites por modelo.
La página dice que los estudiantes pueden recibir una mejora gratuita de membresía, pero no indica requisitos de elegibilidad ni duración.
Para quién es
Desarrolladores de modelos de IA que necesitan cómputo GPU dedicado para entrenamiento o inferencia.
Operadores de servicios en contenedores que necesitan ajustar las réplicas GPU cuando cambia la demanda.
Desarrolladores de aplicaciones que necesitan un endpoint compatible con OpenAI para Claude, GPT y DeepSeek.
Investigadores y desarrolladores que necesitan un entorno JupyterLab configurado en infraestructura GPU.
Preguntas frecuentes
¿Qué modelos de GPU tienen precios por hora publicados?
La página publica precios por hora para RTX 5090, RTX 5090D, RTX 4090, PRO 6000, PRO 6000D, A800 y RTX 4080(S). El precio varía según el modelo y junto a los precios de membresía se muestra un descuento del 5 %.
¿Puedo detener el cobro de GPU cuando no uso una instancia?
Sí. La página dice que se puede apagar una instancia GPU bajo demanda en cualquier momento para detener el medidor. También describe la opción de elegir facturación por consumo o fija al iniciar la instancia.
¿Qué modelos puedo usar mediante AI Gateway?
La página menciona Claude, GPT y DeepSeek y dice que se pueden usar mediante un endpoint compatible con OpenAI. No especifica cuotas de solicitudes ni límites particulares para cada modelo.
¿Cuánto tarda en iniciar un notebook JupyterLab?
GPUHub indica que el JupyterLab configurado inicia en menos de 10 segundos. La página dice que incluye CUDA y frameworks; el inicio también depende de que haya una configuración GPU disponible.
¿GPUHub ofrece una mejora gratuita de membresía para estudiantes?
La página dice que los estudiantes pueden disfrutar de una mejora gratuita de membresía. No especifica los requisitos, la duración de la oferta ni otras condiciones.
Comentarios