
- Visitas mensuales
- 223
- 2026-10
- Crecimiento mensual +7333,3 %
daVinci-MagiHuman - Crea un video hablado con sincronización labial desde un retrato y texto o audio
daVinci-MagiHuman es un modelo de IA de código abierto con 15 mil millones de parámetros para generar videos de retratos parlantes. Recibe una foto de retrato y texto o audio, y genera voz y video sincronizados. El modelo se publica bajo la licencia Apache 2.0 para inferencia local y uso comercial conforme a sus términos. También ofrece un estudio en línea con suscripciones y opciones de créditos con precios separados.
- Vídeo con IA
- Avatares de IA
- generador de videos parlantes con IA
- modelo de sincronización labial de retratos
- IA de audio y video de código abierto
Funciones
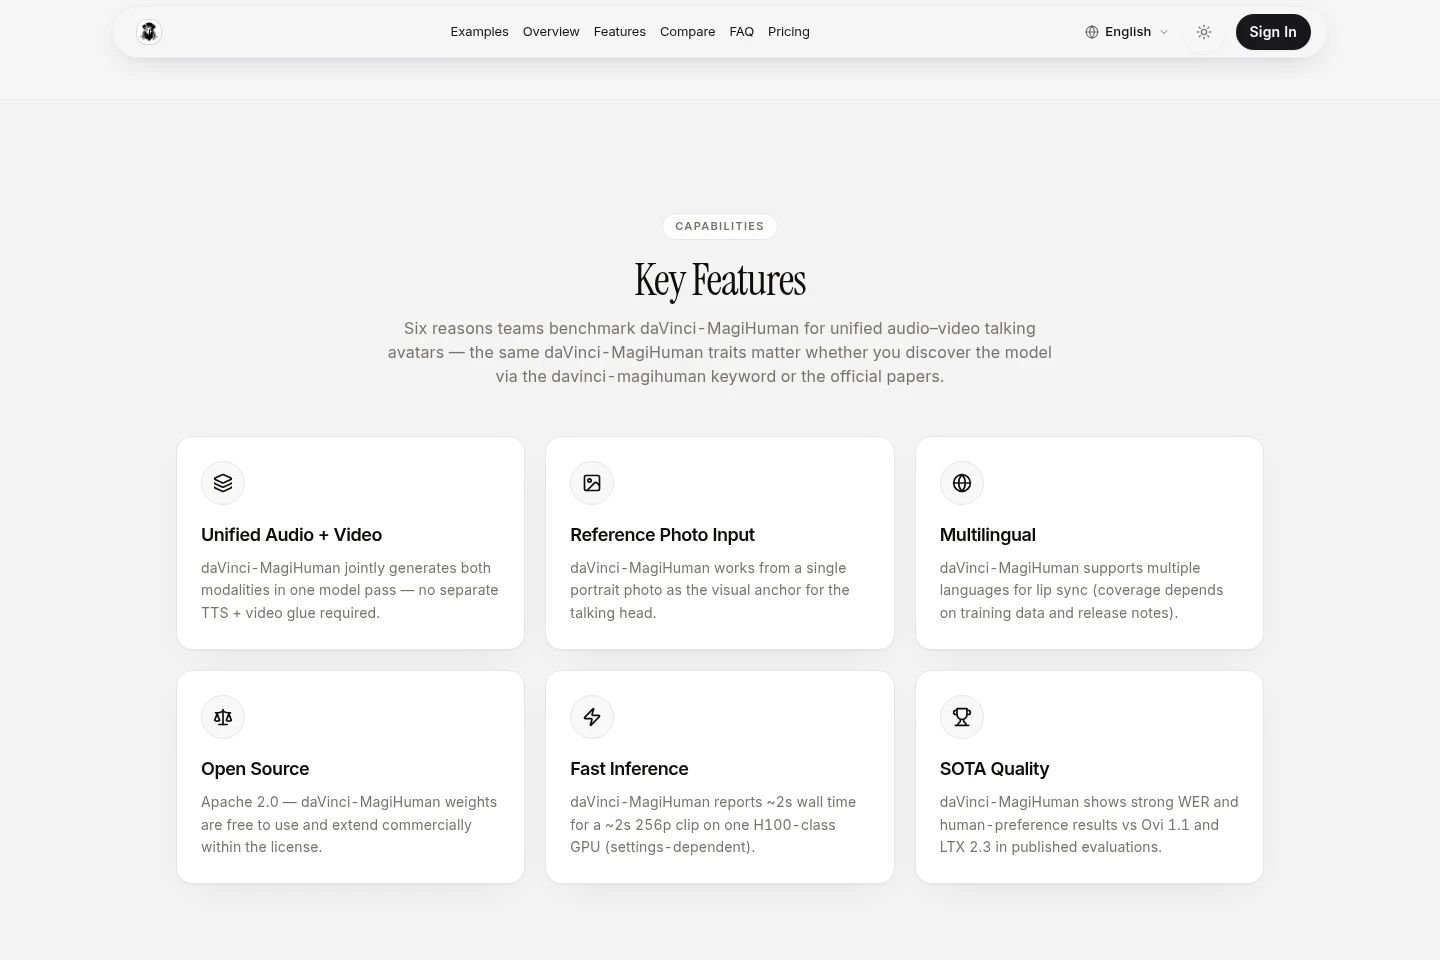
Generación de videos parlantes
Genera un video parlante con sincronización labial y audio correspondiente. Recibe un retrato y un guion de texto o audio; la resolución de salida y la velocidad de inferencia dependen de la configuración y del hardware disponible.
Generación conjunta de audio y video
Genera audio y video juntos en una sola ejecución del modelo. El Transformer de flujo único procesa simultáneamente los tokens de audio y video, sin requerir flujos separados de texto a voz y video.
Inferencia local del modelo
Ejecuta inferencias localmente con los pesos publicados. Descarga los checkpoints y sigue el README del proyecto para configurar el entorno, los scripts de inferencia y las opciones de línea de comandos; el hardware afecta el rendimiento.
Estudio de video en línea
Ofrece un flujo alojado para generar videos con IA. El estudio se usa en línea y la página de precios presenta suscripciones y créditos que se pueden comprar por separado.
Precios
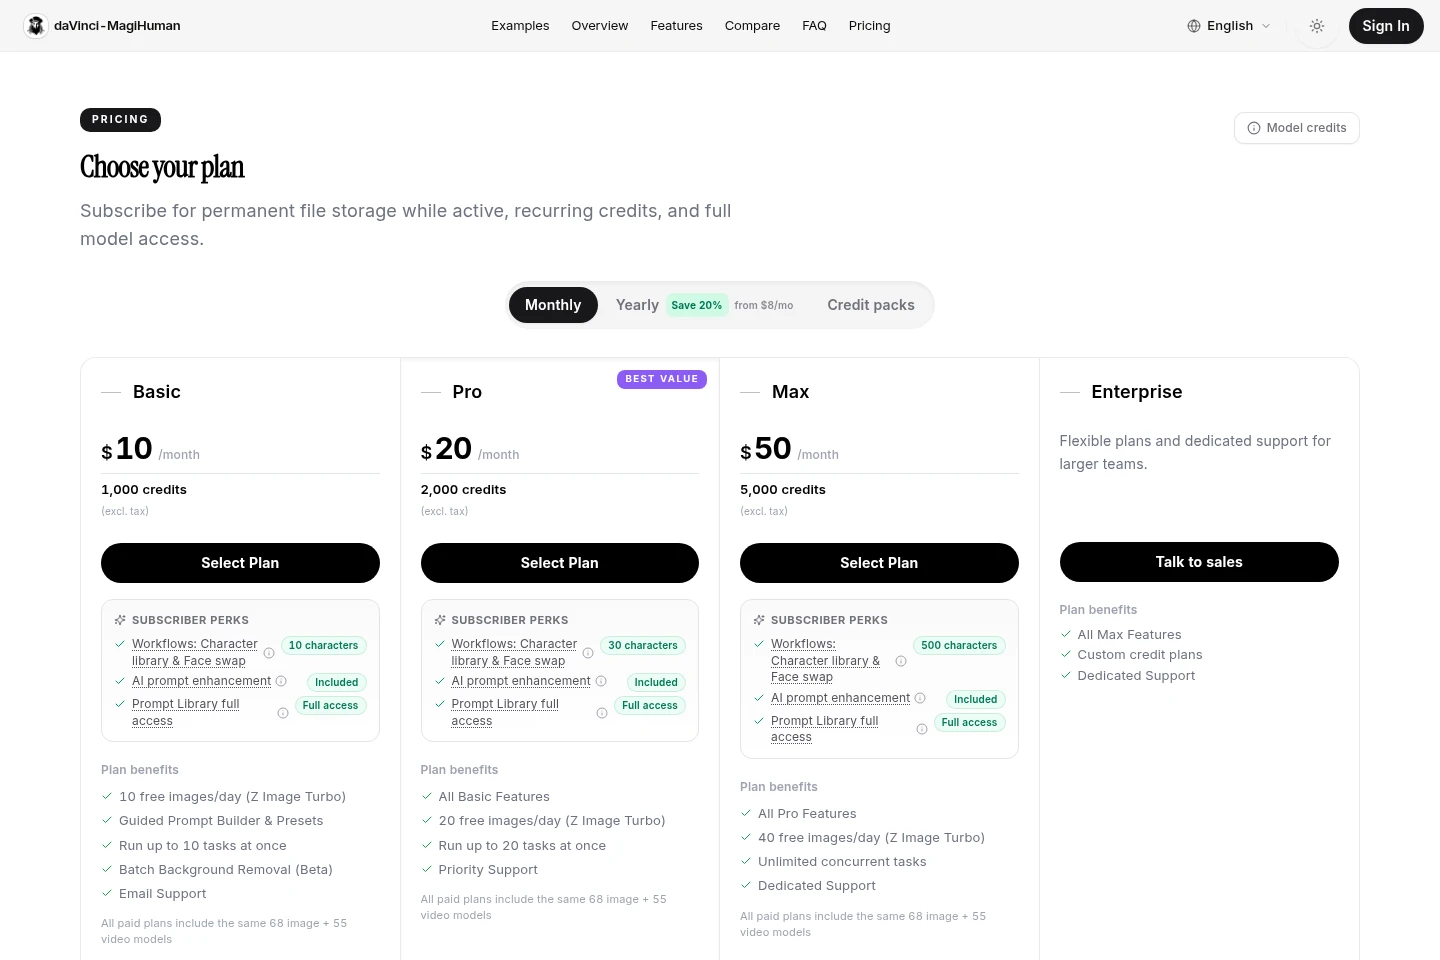
El estudio alojado ofrece acceso gratuito, suscripciones mensuales o anuales y compras únicas de créditos. Compara los créditos, las imágenes gratis diarias, las tareas simultáneas, los límites de personajes, el soporte y el acceso a modelos.
| Plan | Precio | Funciones y límites |
|---|---|---|
| Basic | $10 al mes |
|
| Pro | $20 al mes |
|
| Max | $50 al mes |
|
| Enterprise | Planes flexibles; contacta a ventas |
|
| Pay-as-you-go credits | Compra única; precio variable |
|
Las suscripciones anuales se cobran una vez por el año completo a una tarifa efectiva con descuento; la página anuncia un ahorro del 20%. Las suscripciones se renuevan automáticamente. Las nuevas suscripciones tienen un plazo de reembolso de siete días; los problemas con renovaciones deben reportarse dentro de 72 horas.
Casos de uso
Crear un clip de retrato con sincronización labial
Cuando se necesita que un retrato diga un guion o un audio proporcionado, ingresa la imagen y el texto o audio. El modelo genera un video hablado con el movimiento de labios alineado con el habla.
Ejecutar inferencia de video en hardware propio
Si desarrolladores o investigadores quieren ejecutar el modelo localmente o en un servidor, pueden obtener los checkpoints de Hugging Face y configurar la inferencia siguiendo el README del proyecto. La generación se ejecuta en el hardware elegido.
Generar videos en el estudio alojado
Cuando se busca generar en línea sin instalar el modelo, abre el estudio de video con IA y envía una tarea compatible. La página de precios describe las suscripciones, los créditos y el consumo de créditos según cada generación.
Limitaciones
En la suscripción alojada, las solicitudes se pausan cuando el saldo de créditos llega a cero; se pueden comprar créditos adicionales o cambiar de plan para reanudar la generación.
Los idiomas disponibles para sincronización labial dependen de los datos de entrenamiento y del modelo publicado; la lista actual está en el README oficial.
La velocidad de inferencia depende de la configuración y del hardware; la cifra aproximada de dos segundos corresponde a un clip 256p de unos dos segundos en una GPU de clase H100.
El uso comercial del modelo está sujeto a las condiciones de la licencia Apache 2.0, incluidos los avisos y requisitos de atribución aplicables.
Los créditos comprados como pago por uso no vencen; los créditos de suscripción se entregan en ciclos mensuales o anuales.
Para quién es
Desarrolladores que integran o ejecutan un modelo abierto de video hablado
Investigadores que evalúan modelos de generación de audio y video
Creadores que necesitan generar videos de retratos parlantes en línea
Preguntas frecuentes
¿Qué genera daVinci-MagiHuman?
Genera un video parlante con sincronización labial y audio correspondiente a partir de un retrato y texto o audio. El modelo genera el audio y el video en conjunto.
¿Se puede usar el modelo gratis?
Los pesos del modelo y el código publicados están disponibles bajo Apache 2.0. Las suscripciones y los créditos del estudio alojado tienen precios y condiciones separados.
¿Puedo usar daVinci-MagiHuman con fines comerciales?
Sí, siempre que se cumplan las condiciones de Apache 2.0. Revisa los requisitos de la licencia para tu uso, incluidos los avisos y la atribución.
¿Qué idiomas admite para la sincronización labial?
La cobertura depende del modelo publicado y sus datos de entrenamiento. Consulta el README oficial para conocer la lista vigente y las salvedades por región.
¿Cómo se cobran los créditos del estudio en línea?
El consumo depende de la duración de salida y de ajustes como la resolución y el modo. Las preguntas frecuentes de precios ofrecen ejemplos aproximados; el estudio muestra los totales actuales.
¿Vencen los créditos de pago por uso?
No. Los créditos comprados con la opción de pago único no vencen; los créditos de suscripción se entregan en ciclos mensuales o anuales.

Comentarios