
- Visitas mensuales
- 3505
- 2026-10
- Crecimiento mensual -57,8 %
crawler.sh - Rastreo local de sitios, extracción Markdown y análisis SEO
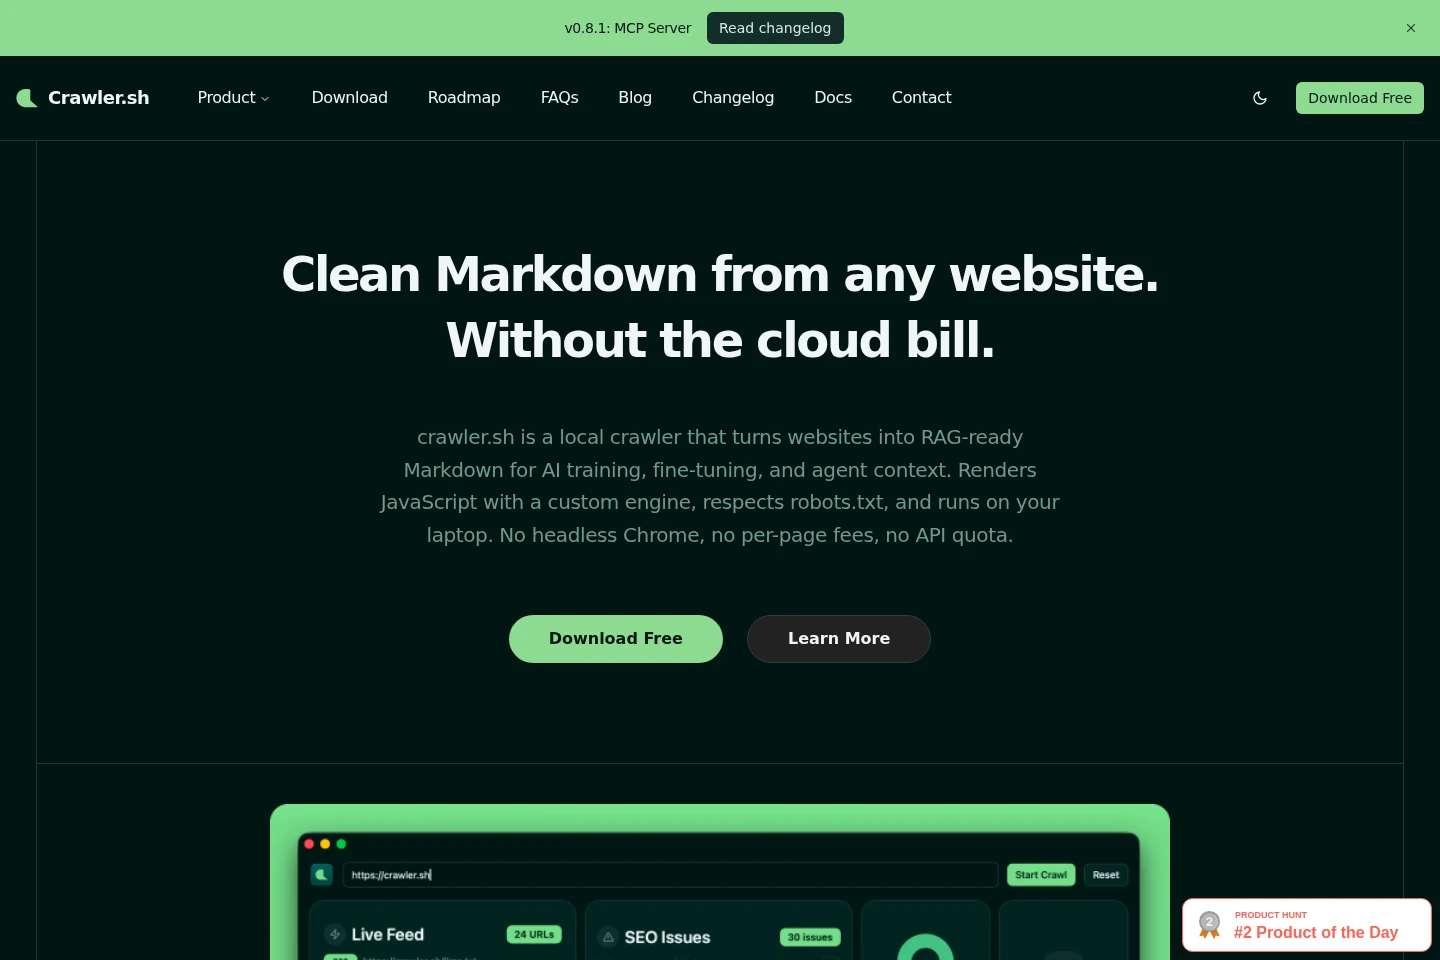
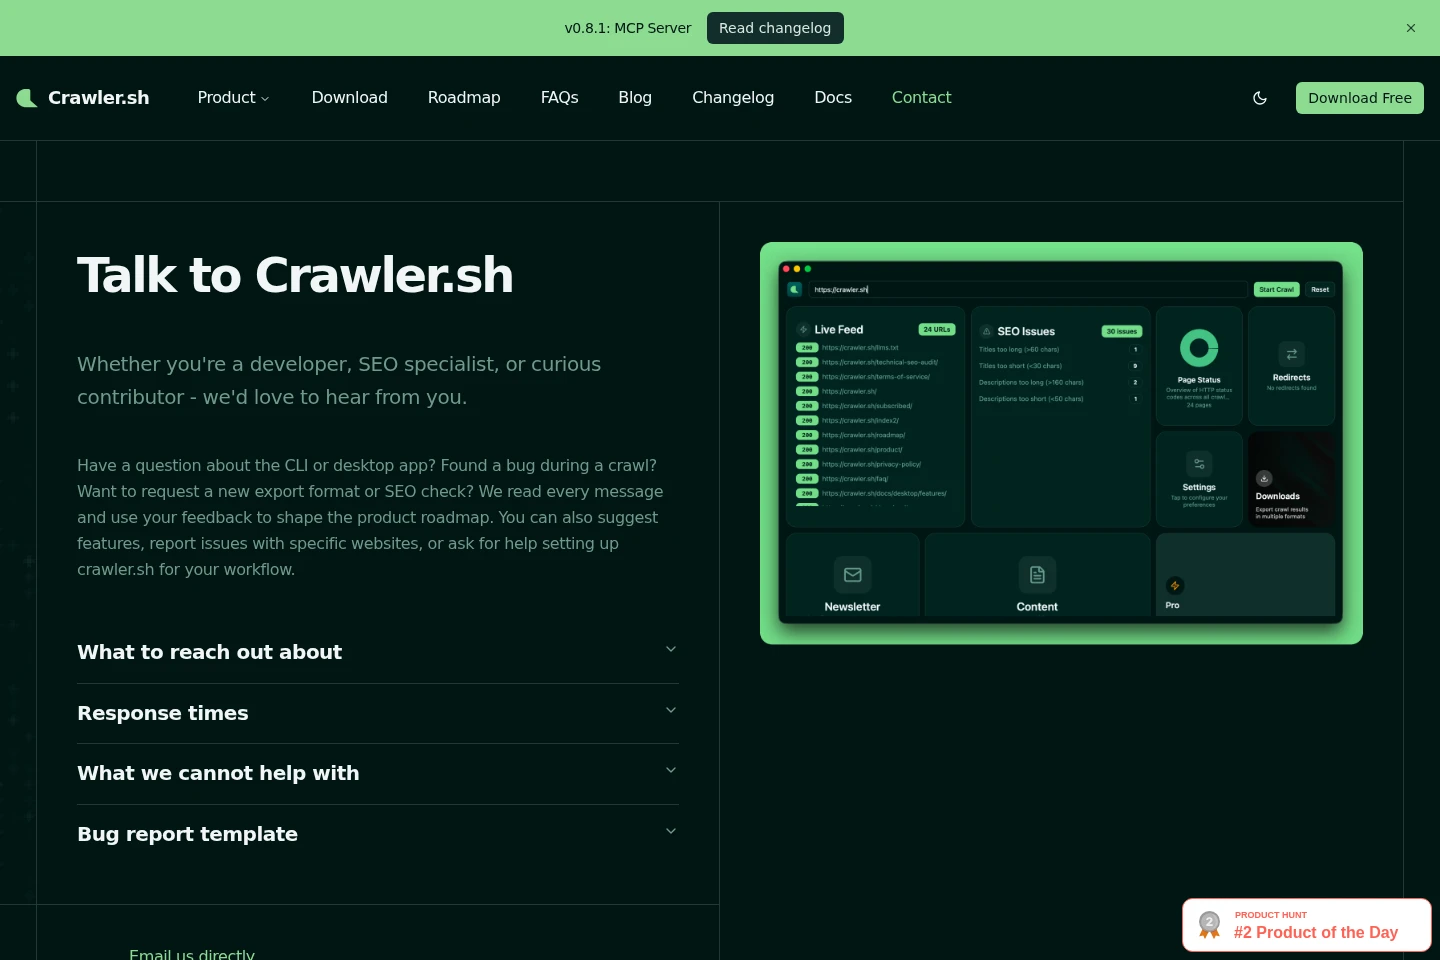
crawler.sh es un rastreador web local con CLI y aplicación de escritorio. Extrae artículos como Markdown, renderiza páginas que dependen de JavaScript y revisa las páginas rastreadas para detectar problemas de SEO. Respeta robots.txt, exporta resultados en varios formatos y funciona en el equipo del usuario. El uso gratuito permite hasta 50 páginas por sesión; CLI Pro permite hasta 10,000.
- Marketing con IA
- Herramientas SEO
- Web scraping
- rastreador web local
- extracción de contenido Markdown
- auditoría SEO
Funciones
Rastreo de sitios web
Rastrea sitios localmente y guarda los resultados de las páginas para revisarlos o exportarlos. Permite configurar concurrencia, reintentos y renderizado; respeta robots.txt y ajusta el ritmo tras respuestas 429 o 403.
Extracción a Markdown
Extrae el artículo principal de páginas HTML y genera Markdown limpio con cantidad de palabras, autor y extracto. La extracción está activada de forma predeterminada y se puede desactivar con --no-extract.
Renderizado de JavaScript
Renderiza páginas que dependen de JavaScript del lado del cliente mediante un motor integrado. Auto detecta si hace falta; también se puede forzar con --render o desactivar con --no-render.
Análisis SEO
Revisa las páginas rastreadas para detectar problemas de SEO y exporta resultados agrupados como CSV o TXT. El análisis abarca 24 categorías y solo procesa páginas HTML con respuesta 2xx.
Exportación del rastreo y del sitio
Exporta datos de rastreo como NDJSON, JSON o Sitemap XML conforme a W3C; los resultados SEO están disponibles en CSV o TXT. Pro Content Archive guarda cada página extraída como un archivo Markdown dentro de un ZIP.
Precios
Hay un plan gratuito y los planes Pro pagados funcionan mediante suscripción. Para elegir, compara límites por sesión, interfaz, análisis y formatos de exportación. Free cuesta $0 y CLI Pro se cobra anualmente; las páginas no indican el precio de Desktop Pro.
| Plan | Precio | Funciones y límites |
|---|---|---|
| Free | $0 |
|
| CLI Pro | $99 al año |
|
| Desktop Pro | Precio no indicado |
|
Una suscripción cubre tanto la CLI como la aplicación de escritorio. La página del producto indica que iniciar sesión eleva el límite a 400 páginas por rastreo, pero no especifica el precio ni las condiciones de facturación del plan correspondiente.
Casos de uso
Preparar contenido web para flujos de IA
Cuando se necesitan páginas web para RAG, ajuste fino o contexto de agentes, se puede rastrear el sitio y extraer el texto principal. crawler.sh guarda localmente Markdown limpio y metadatos de las páginas para usarlos en procesos posteriores.
Revisar problemas SEO de un sitio
Para revisar un sitio antes de publicarlo o durante su mantenimiento, se rastrean las páginas y se ejecuta el análisis SEO. Los problemas agrupados se exportan como CSV o TXT para investigar las URL afectadas.
Crear un archivo Markdown del contenido web
Cuando se necesita respaldar contenido o trasladarlo a otro flujo de trabajo, se rastrean las páginas y se exporta el contenido extraído. Pro Content Archive crea un ZIP con un archivo Markdown por cada página extraída.
Generar un mapa del sitio desde un rastreo
Cuando el mapa del sitio debe reflejar las páginas rastreadas, se ejecuta el rastreo y se exporta Sitemap XML conforme a W3C. El archivo generado se puede usar como mapa del sitio web.
Limitaciones
El uso anónimo permite hasta 50 páginas por sesión; iniciar sesión eleva el límite a 400 páginas por rastreo y CLI Pro permite hasta 10,000 por sesión.
El análisis SEO procesa únicamente páginas HTML que responden con estado 2xx.
La FAQ indica que Windows está en la hoja de ruta; actualmente enumera macOS y Linux para CLI y escritorio.
El soporte se ofrece en inglés; el equipo afirma que intentará comprender y responder mensajes en otros idiomas.
El equipo no rastrea sitios por encargo, no crea paneles personalizados ni redacta informes SEO a medida como servicio pagado.
No se ofrece soporte telefónico, SLA de tickets ni un gerente de cuenta dedicado, tampoco en Pro.
Para quién es
Desarrolladores que necesitan rastreo local en scripts, tareas programadas o pipelines de CI
Especialistas SEO que necesitan revisar problemas técnicos del sitio y exportar informes
Personas que preparan texto web en Markdown para RAG, ajuste fino o contexto de agentes
Responsables de sitios que necesitan archivar contenido, generar mapas o vigilar cambios
Preguntas frecuentes
¿Qué sistemas operativos admite crawler.sh?
La CLI y la aplicación de escritorio están disponibles para macOS y Linux. La FAQ especifica Apple Silicon e Intel en macOS y x86_64 en Linux; Windows está en la hoja de ruta.
¿Necesito una cuenta para rastrear un sitio?
No. La CLI y la aplicación de escritorio funcionan sin cuenta, con un límite de 50 páginas por rastreo; al iniciar sesión, el límite aumenta a 400.
¿crawler.sh puede renderizar páginas JavaScript?
Sí. El motor integrado detecta frameworks de JavaScript del lado del cliente en modo Auto. Usa --render para forzarlo o --no-render para desactivarlo.
¿Qué formatos puede exportar crawler.sh?
Los datos del rastreo se exportan como NDJSON, JSON o Sitemap XML; los informes SEO, como CSV o TXT. Pro Content Archive también guarda las páginas extraídas como archivos Markdown en un ZIP.
¿Cómo funciona la extracción de contenido?
Cuando está activada, crawler.sh extrae el artículo principal de páginas HTML a Markdown e incluye cantidad de palabras, autor y extracto. Está activada por defecto y se puede deshabilitar con --no-extract.
¿Qué páginas incluye el análisis SEO?
Solo se analizan páginas HTML con respuestas 2xx. El comando SEO revisa 24 categorías, incluidos metadatos, encabezados, enlaces, URL canónicas y señales de actualidad del contenido.
Comentarios