

DeepInfer - 面向DeepSeek-V4.1-Flash的开源大模型推理框架
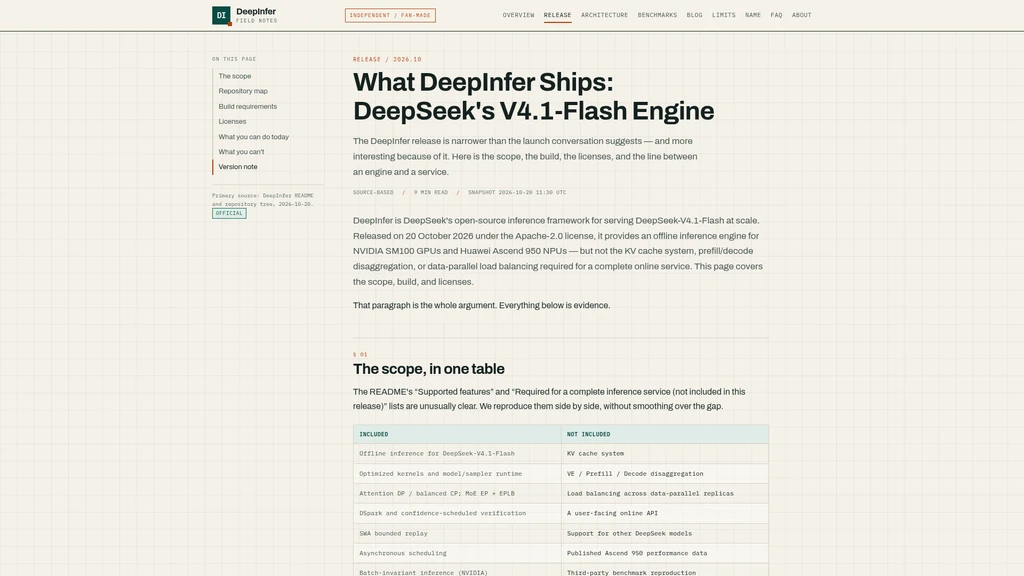
上线于 2026年10月20日DeepInfer是深度求索推出的采用Apache 2.0许可的离线推理引擎,用于大规模部署DeepSeek-V4.1-Flash。它在Linux系统上支持NVIDIA SM100与华为昇腾950硬件,内置优化内核、专家并行、投机解码与确定性采样功能。该工具面向使用DeepSeek-V4.1-Flash的开发者、推理引擎研究人员以及搭建自定义大模型服务基础设施的工程师,并非完整的服务栈、面向终端用户的API或适配其他模型的通用推理引擎。
相关内容

Copy.ai Review 2026: AI Copywriting Made Easy
Our honest Copy.ai review for 2026. We test Content Agents, AI Workflows, pricing ($29-$249/mo), and compare it to Jasper and Writesonic. Find out if it's worth it for your marketing team.

Rytr Review 2026: Is This Budget AI Writer Worth It?
Our hands-on Rytr review for 2026. We test features, pricing, content quality, and compare it to Jasper & ChatGPT. Find out if Rytr is the best budget AI writing tool.

Word Changer - Free AI tool to rewrite and improve your writing instantly
Writing always using repetitive words or need to avoid plagiarism? Word Changer is a free AI writing assistant that instantly rewrites any text with richer vocabulary and appropriate tone. Get multiple versions with one click, adjust formality level, check readability - all for free!

Unite - AI-powered platform for romantic fantasies and dream couple moments
Explore romantic fantasies and create special moments for your dream couple. This AI-powered platform lets you generate personalized romantic content and experience exclusive AI-created romantic experiences.
评论