
- 月访问量
- 223
- 2026-10
- 月流量增速 +7,333.3%
daVinci-MagiHuman - 用一张人像照片和文本或音频生成口型同步的说话视频
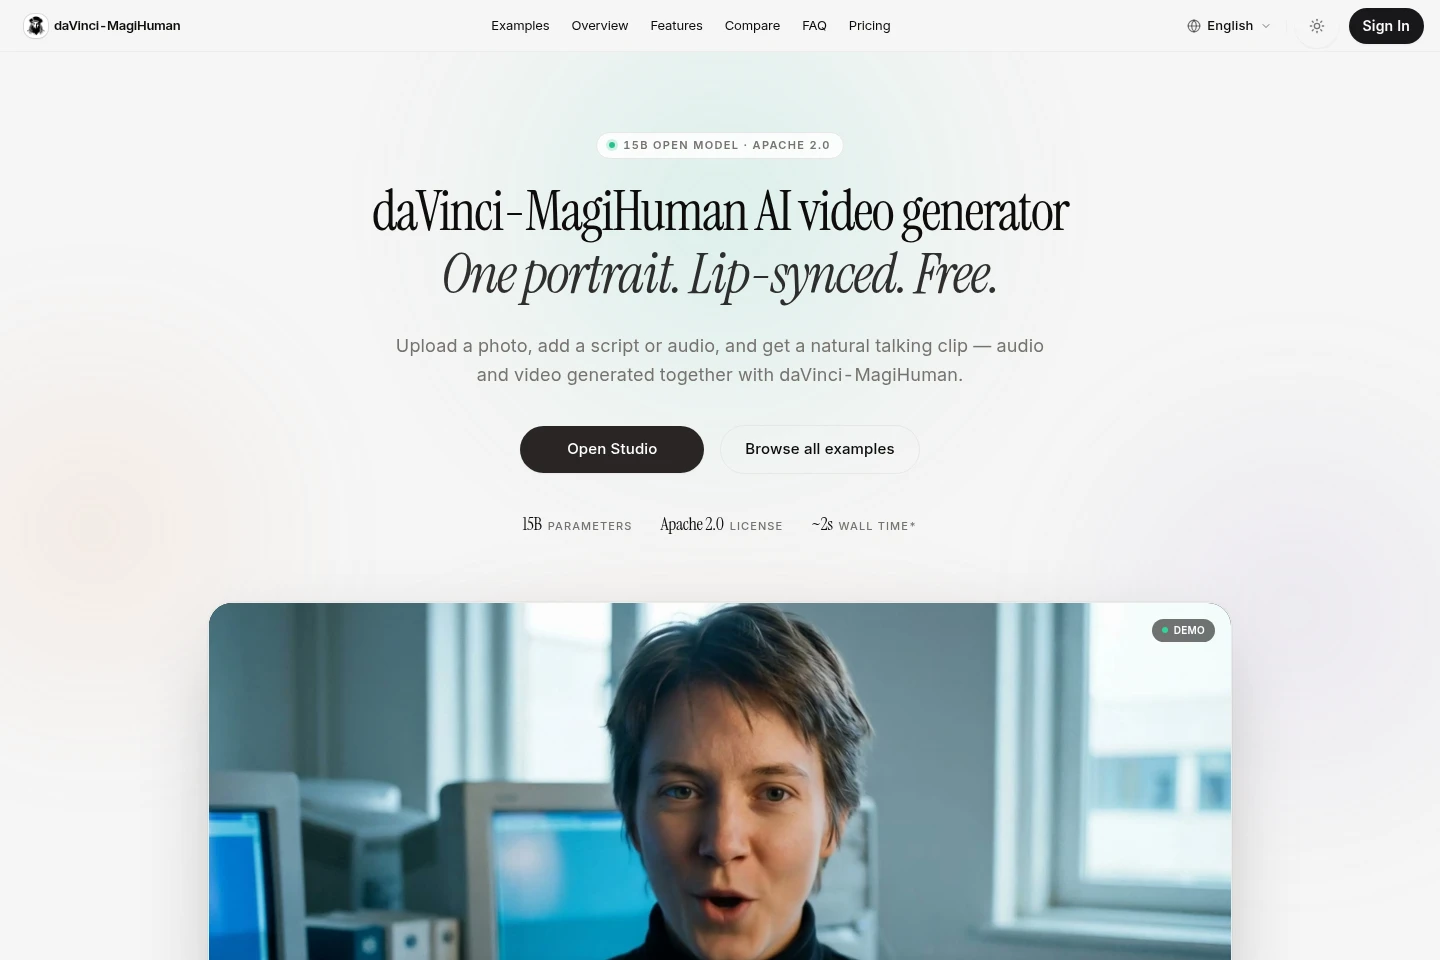
daVinci-MagiHuman 是一款拥有 150 亿参数的开源 AI 模型,用于生成说话头像视频。它接收人像照片以及文本或音频,并生成同步的语音与视频。模型依据 Apache 2.0 许可发布,可按许可条款在本地推理并用于商业用途。另提供在线工作室,其订阅和积分选项另行定价。
核心能力
说话视频生成
生成带有匹配音频的口型同步说话视频。输入人脸人像以及文本脚本或音频;输出分辨率和推理速度取决于设置与可用硬件。
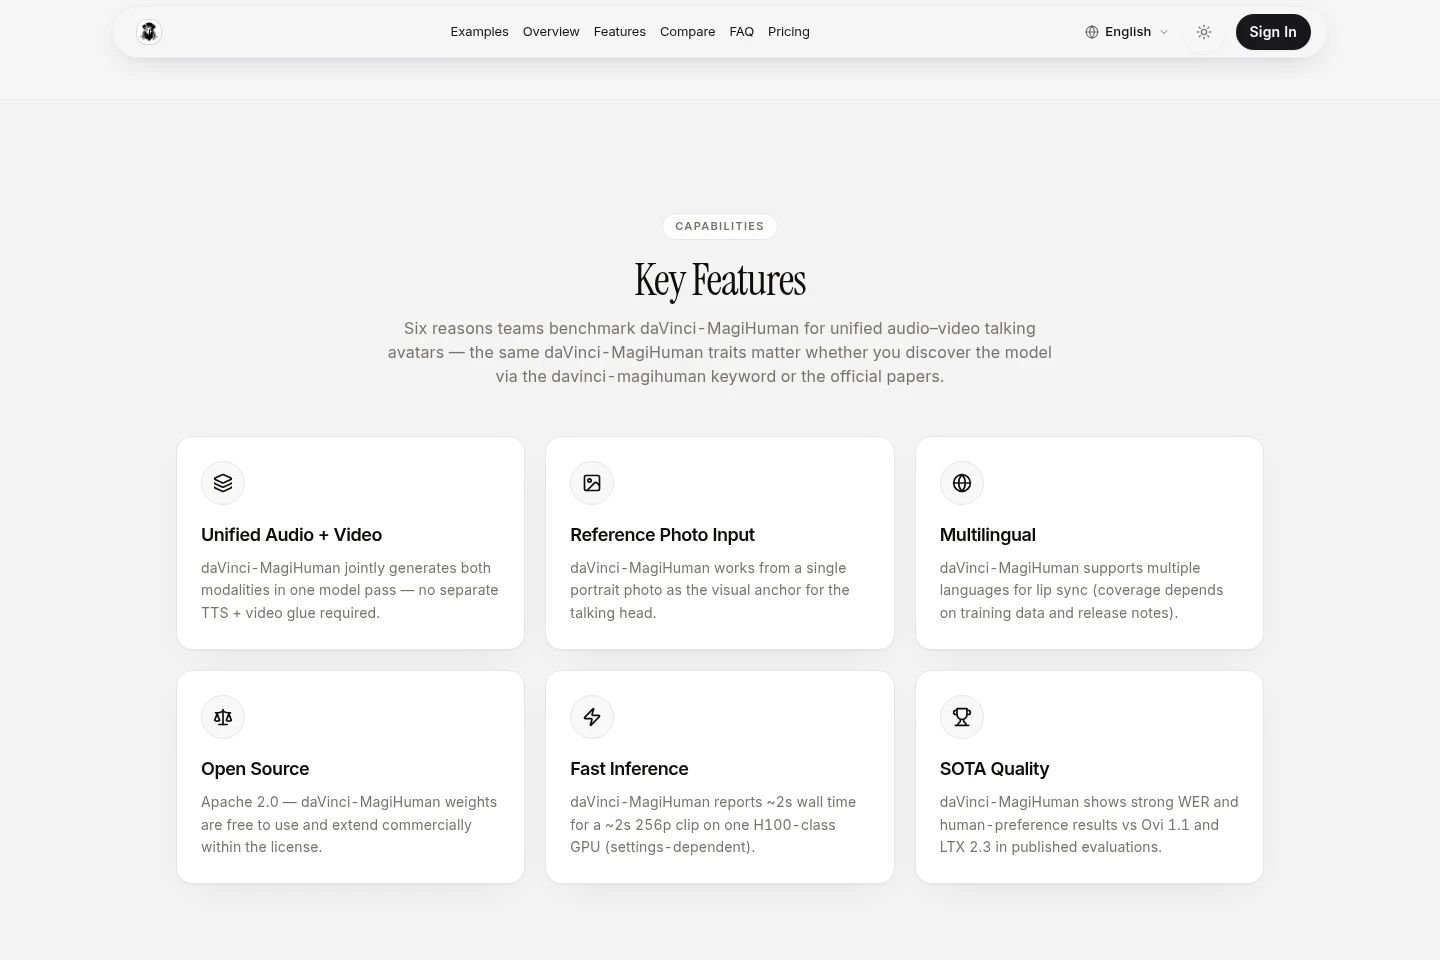
音视频联合生成
在一次模型处理中同时生成音频和视频。单流 Transformer 联合处理音视频 token,无需依赖彼此分离的文本转语音与视频流程。
本地模型推理
使用已发布的模型权重在本地运行推理。下载检查点并依照上游 README 配置环境、推理脚本和命令行选项;硬件会影响处理速度。
在线视频工作室
提供托管的 AI 视频生成工作流。用户可在线使用工作室,定价页另列订阅方案和可单独购买的积分。
定价
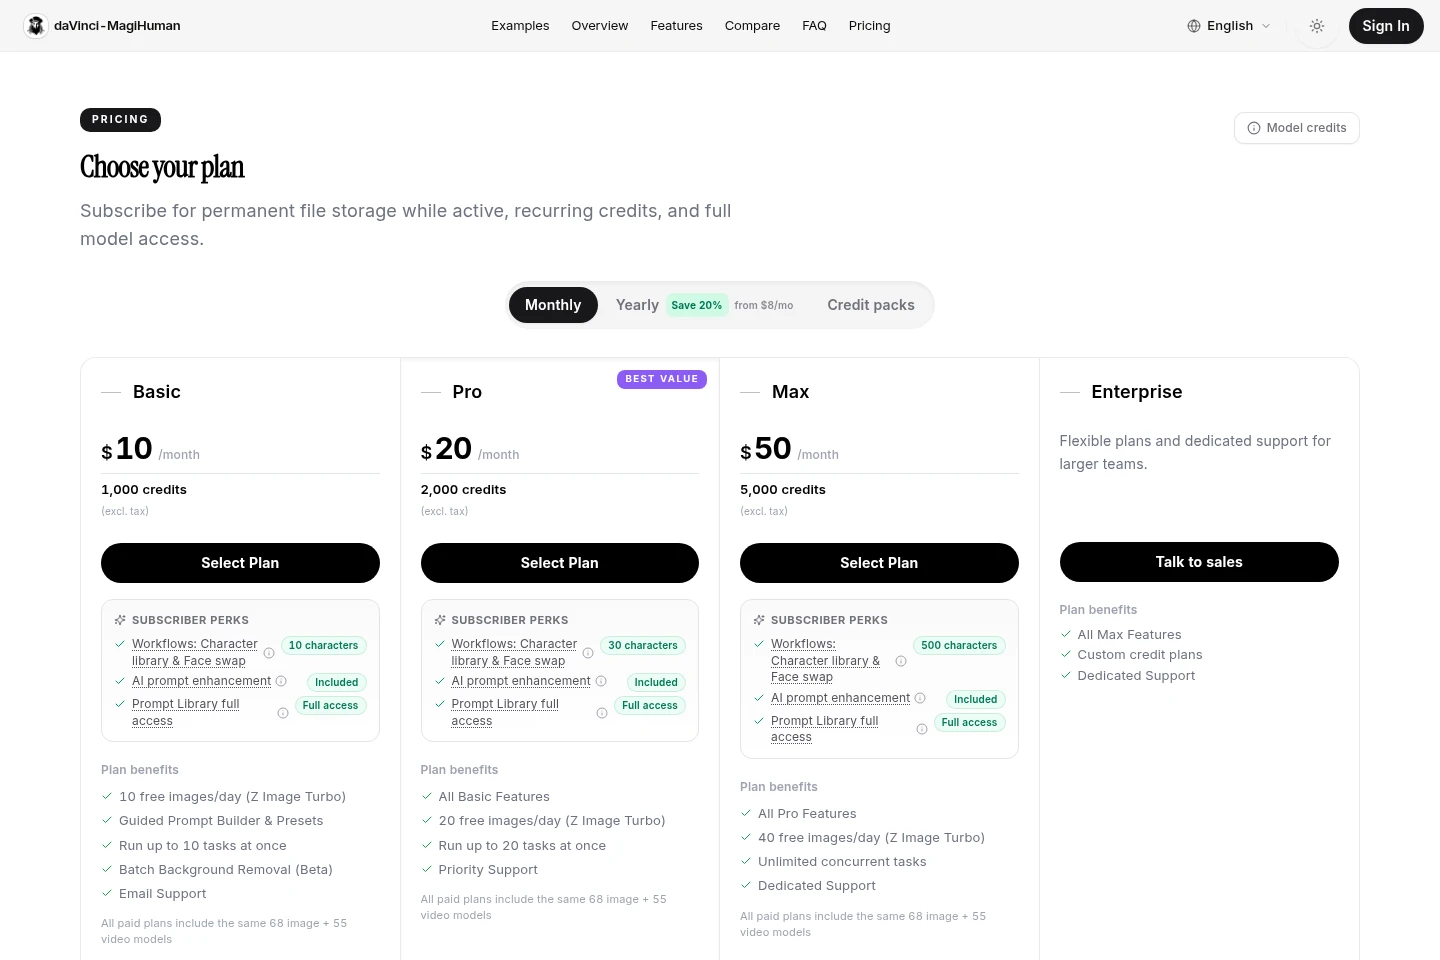
托管工作室提供免费使用、按月或按年续订的订阅,以及一次性购买积分。选择方案时可比较积分数量、每日免费图片、并发任务、角色数量上限、支持服务和模型访问权限。
| 套餐 | 价格 | 包含内容与使用额度 |
|---|---|---|
| Basic | 每月 $10 |
|
| Pro | 每月 $20 |
|
| Max | 每月 $50 |
|
| Enterprise | 方案灵活;联系销售 |
|
| Pay-as-you-go credits | 一次性购买;价格因数量而异 |
|
年订阅按年一次性收费,折算后享有优惠;页面标示节省 20%。订阅会自动续订。新订阅有七天退款期;续订扣款问题须在 72 小时内提出。
使用场景
制作口型同步的说话头像短片
需要让人像讲述脚本或所提供的音频时,输入人像以及文本或音频。模型会生成口型与语音对齐的说话视频。
在自有硬件上运行说话视频推理
开发者或研究人员想在本地或服务器运行模型时,可从 Hugging Face 获取检查点,并依照项目 README 配置推理。生成任务随后在所选硬件上运行。
在托管工作室生成视频
用户希望在线生成而不安装模型时,可打开 AI 视频工作室并提交受支持的生成任务。定价页说明订阅、积分以及按生成使用积分的方式。
使用限制
托管订阅的积分余额降至零时,请求会暂停;用户可购买按量积分或升级方案以恢复生成。
模型支持的口型同步语言取决于训练数据和已发布模型;当前语言列表请查阅官方 README。
推理速度取决于设置和硬件;约两秒的指标对应 H100 级 GPU 上生成约两秒的 256p 视频。
模型的商业用途受 Apache 2.0 许可条件约束,包括适用的声明和署名要求。
按量购买的积分不会过期;订阅积分则按月或按年发放。
适用人群
需要集成或运行开源说话视频模型的开发者
评估音视频生成模型与推理的研究人员
需要在线制作人像说话视频的创作者
常见问题
daVinci-MagiHuman 会生成什么?
它根据人像以及文本或音频生成带有匹配音频的口型同步说话视频。模型会联合生成音频和视频。
这个模型可以免费使用吗?
已发布的模型权重和代码采用 Apache 2.0 许可。托管工作室订阅和积分另有价格与条款。
可以将 daVinci-MagiHuman 用于商业用途吗?
可以,但须遵守 Apache 2.0 许可条件。请针对具体用途查看许可要求,包括声明和署名。
它支持哪些口型同步语言?
语言覆盖取决于已发布模型及其训练数据。请查阅官方 README,了解当前支持语言和地区注意事项。
在线工作室如何扣除积分?
生成所需积分取决于输出时长、分辨率和模式等设置。定价常见问题提供估算示例,并建议在工作室查看实时用量。
按量购买的积分会过期吗?
不会。一次性购买的积分不会过期;订阅积分则按月或按年发放。

评论