
- 月访问量
- 3,505
- 2026-10
- 月流量增速 -57.8%
crawler.sh - 本地抓取网站、提取 Markdown 并分析 SEO
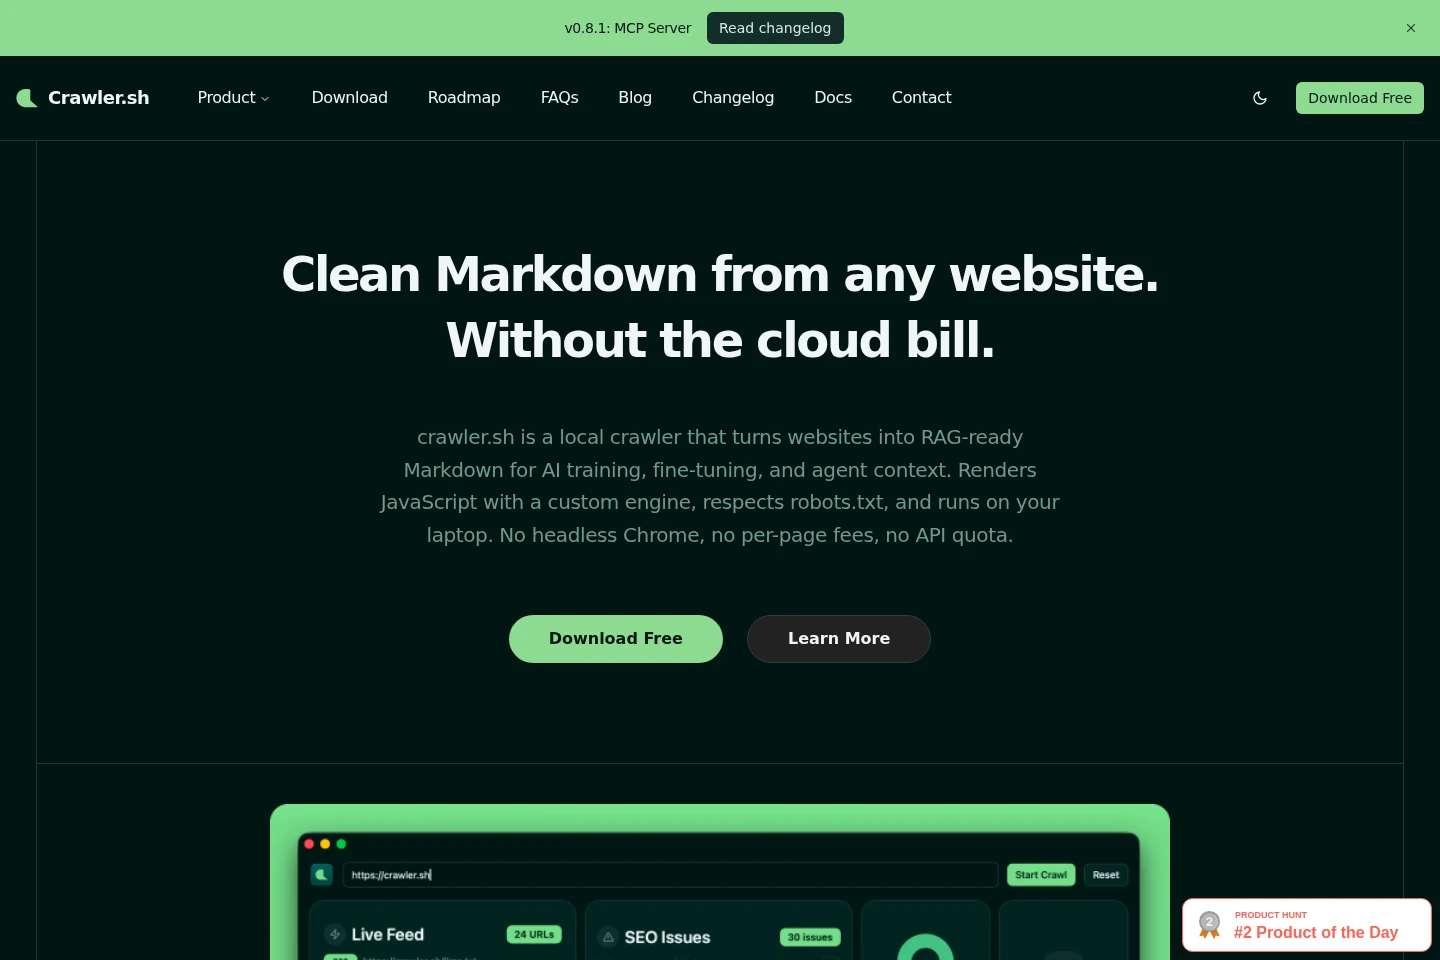
crawler.sh 是一款本地运行的 CLI 和桌面网页抓取工具,可将文章内容提取为 Markdown、渲染依赖 JavaScript 的页面,并检查抓取页面中的 SEO 问题。它遵循 robots.txt,以多种格式导出抓取和分析结果,并在用户自己的设备上运行。免费使用每次会话最多抓取 50 页;付费 CLI Pro 每次会话最多可抓取 10,000 页。
核心能力
网站抓取
在本地抓取网站,并保存页面结果以供检查或导出。可配置并发、重试和渲染;抓取会遵循 robots.txt 指令,并在收到 429 或 403 响应后调整访问节奏。
Markdown 提取
从 HTML 页面提取主要文章内容,并输出附带字数、作者署名和摘要的整洁 Markdown。默认启用提取,也可使用 --no-extract 关闭。
JavaScript 渲染
使用内置引擎渲染依赖客户端 JavaScript 的页面。Auto 模式会检测是否需要渲染;用户也可用 --render 强制启用或用 --no-render 关闭。
SEO 分析
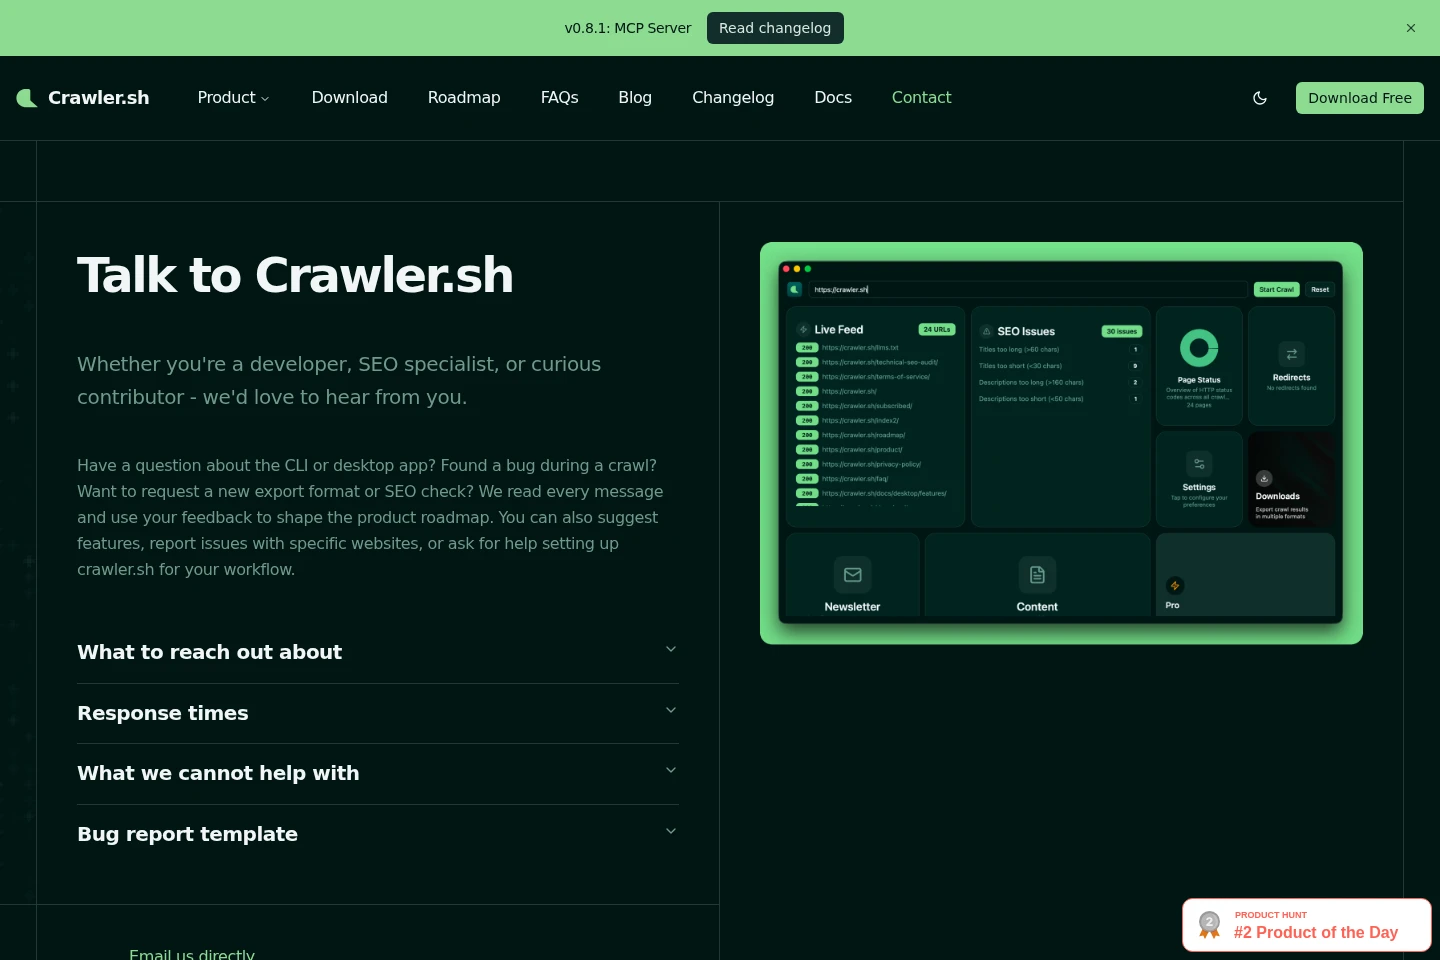
检查抓取页面中的 SEO 问题,并将分类结果导出为 CSV 或 TXT。分析覆盖 24 个类别,且只分析返回 2xx 状态码的 HTML 页面。
抓取与网站导出
将抓取数据导出为 NDJSON、JSON 或符合 W3C 规范的 Sitemap XML,SEO 结果可导出为 CSV 或 TXT。Pro 的 Content Archive 会将提取的页面分别写入 ZIP 中的 Markdown 文件。
定价
提供免费方案,付费 Pro 方案采用订阅制;选择时可比较每次会话的页面上限、使用界面、分析能力和导出格式。Free 为 $0,CLI Pro 按年收费;所提供页面未说明 Desktop Pro 价格。
| 套餐 | 价格 | 包含内容与使用额度 |
|---|---|---|
| Free | $0 |
|
| CLI Pro | 每年 $99 |
|
| Desktop Pro | 未列出价格 |
|
一个订阅同时适用于 CLI 和桌面应用。产品页面称登录可将每次抓取上限提高到 400 页,但没有说明对应方案价格或计费条件。
使用场景
为 AI 流程准备网站内容
当 RAG、微调或智能体上下文需要网站页面时,可抓取网站并提取主要文章文本。crawler.sh 会在本地保存整洁的 Markdown 和页面元数据,供后续工作流使用。
检查网站 SEO 问题
在上线前或维护期间检查网站时,可抓取页面并运行 SEO 分析。查看分类问题,导出 CSV 或 TXT,再据此调查受影响的网址。
创建 Markdown 内容归档
需要备份网站内容或将其迁移到其他工作流时,可抓取页面并导出提取内容。Pro 的 Content Archive 会生成 ZIP,其中每个提取页面各有一个 Markdown 文件。
从实时抓取生成站点地图
需要让站点地图反映已抓取页面时,可运行抓取并导出符合 W3C 规范的 Sitemap XML。生成的文件可用作网站站点地图。
使用限制
匿名使用每次会话最多抓取 50 页;登录后每次抓取上限为 400 页,CLI Pro 每次会话最多 10,000 页。
SEO 分析只处理响应状态为 2xx 的 HTML 页面。
FAQ 将 Windows 支持列为路线图项目;当前列出的 CLI 和桌面版平台为 macOS 与 Linux。
支持服务仅以英语提供;团队表示会尽力理解并回复其他语言的邮件。
团队不代用户抓取网站、不制作定制仪表板,也不提供付费定制 SEO 报告。
包括 Pro 在内,均不提供电话支持、工单服务等级协议或专属客户经理。
适用人群
需要在脚本、定时任务或 CI 流程中执行本地抓取的开发者
需要检查全站技术问题并导出报告的 SEO 专业人员
需要将网站文本整理为 RAG、微调或智能体上下文输入的人
需要归档内容、生成站点地图或监控页面变化的网站所有者
常见问题
crawler.sh 支持哪些操作系统?
CLI 和桌面应用可用于 macOS 与 Linux。FAQ 指明 macOS 支持 Apple Silicon 和 Intel,Linux 支持 x86_64;Windows 支持仍在路线图中。
抓取网站需要创建账户吗?
不需要。CLI 和桌面应用无需账户即可使用,每次抓取最多 50 页;登录后上限提高到 400 页。
crawler.sh 能渲染 JavaScript 页面吗?
可以。内置渲染器可在 Auto 模式下检测客户端 JavaScript 框架。使用 --render 可强制渲染,使用 --no-render 可关闭渲染。
crawler.sh 可以导出哪些格式?
抓取数据可导出为 NDJSON、JSON 或 Sitemap XML,SEO 报告可导出为 CSV 或 TXT。Pro 的 Content Archive 还可将提取页面作为 Markdown 文件打包到 ZIP 中。
内容提取如何工作?
启用后,crawler.sh 会将 HTML 页面的主要文章内容提取为 Markdown,并附上字数、作者署名和摘要。默认开启,也可用 --no-extract 关闭。
SEO 分析会检查哪些页面?
只分析响应为 2xx 的 HTML 页面。SEO 命令检查 24 个类别,包括元数据、标题、链接、规范网址和内容时效性。
评论