
- Monatliche Besuche
- 293
- 2026-09
- Monatliches Wachstum -41,6 %
Pier - KI-Modellanfragen über eine API weiterleiten
Pier verbindet Anwendungen über eine einzelne API mit mehr als 250 KI-Modellen. Unterstützt werden Modell-Fallbacks, Load Balancing, Wiederholungen, Caching und Canary-Tests. Die Plattform bietet außerdem Deployment, Nutzungsmetriken, Protokolle, Nutzerverwaltung und Kostenübersicht. Die Website nennt einen kostenlosen Trial-Plan und einen Enterprise-Plan mit Preis auf Anfrage.
- LLM-Entwicklertools
- LLM-APIs
- GPU-Cloud
- LLM-Observability
- KI-Modell-Routing
- LLM-API-Verwaltung
- KI-Modell-Observability
Funktionen
Einheitliche Modell-API
Verbindet Anwendungen über eine einzelne API mit mehr als 250 KI-Modellen. Mit einem API-Schlüssel lassen sich Modelle aufrufen und Fallbacks, Load Balancing, Wiederholungen, Caching sowie Canary-Tests konfigurieren.
Modell-Deployment und Skalierung
Stellt mehrere Modelle für eine Anwendung bereit und verwaltet die Skalierung über Pier. Die Seite beschreibt die Bereitstellung von Agenten mit einem Klick und gibt an, dass Pier Deployment und Skalierung übernimmt.
Nutzungsübersicht
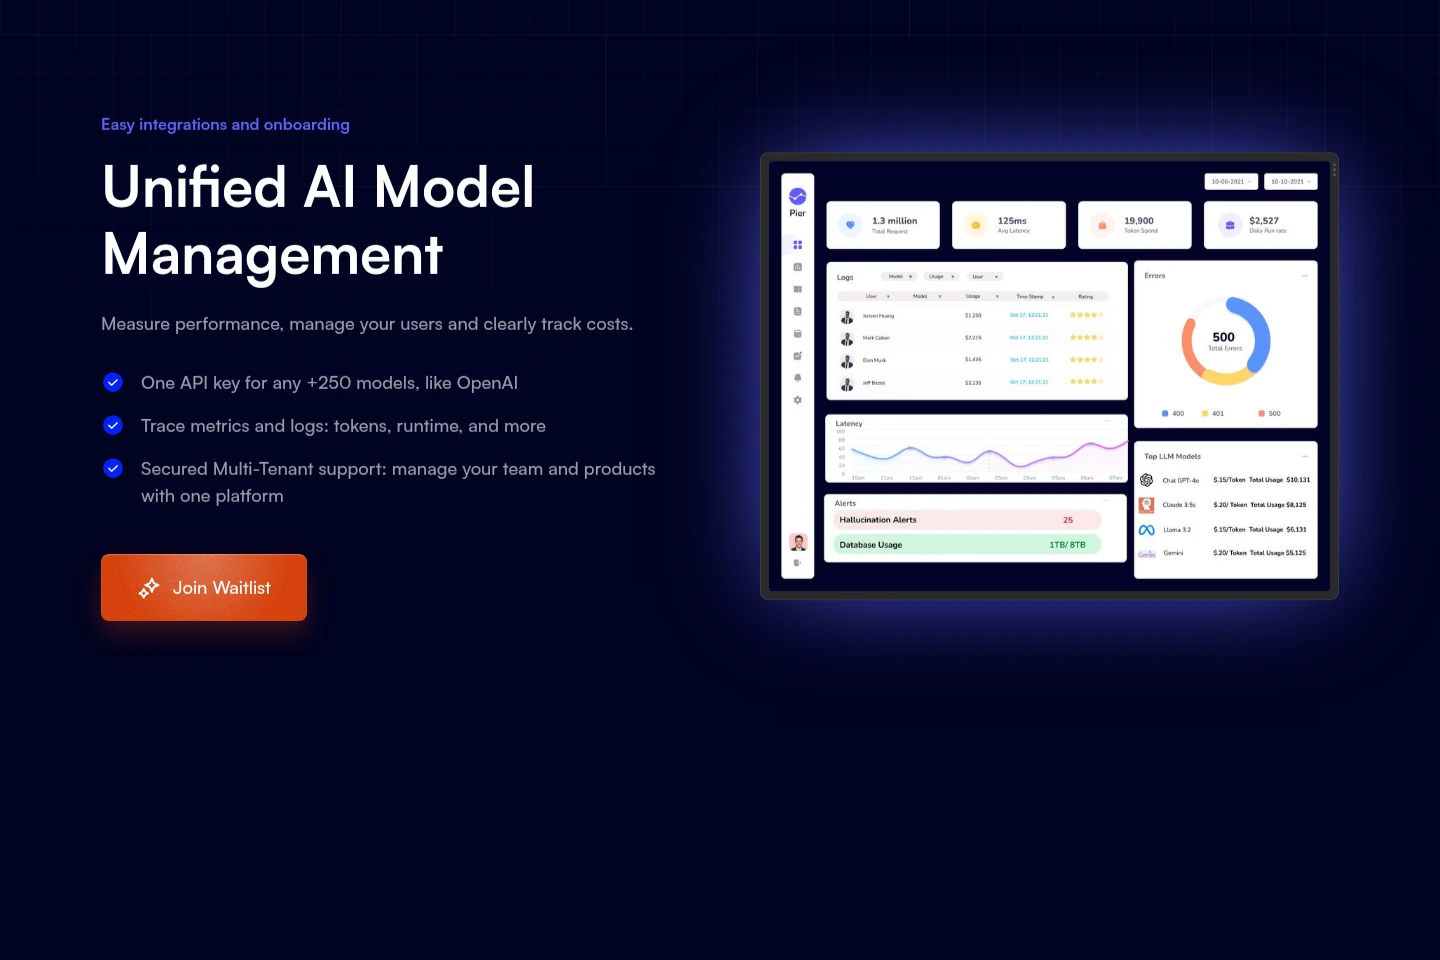
Zeigt Nutzungsmetriken und Protokolle, darunter Token und Laufzeit, und ermöglicht die Verwaltung von Nutzern und Kosten. Die Trial-Plan-Angabe umfasst Protokolle und Metriken für 30 Tage.
Mandantenverwaltung
Verwaltet Teams und Produkte mit Multi-Tenant-Unterstützung auf einer Plattform. Die Seite bezeichnet diese Unterstützung als sicher, nennt jedoch keine konkreten Sicherheitskontrollen.
Preise
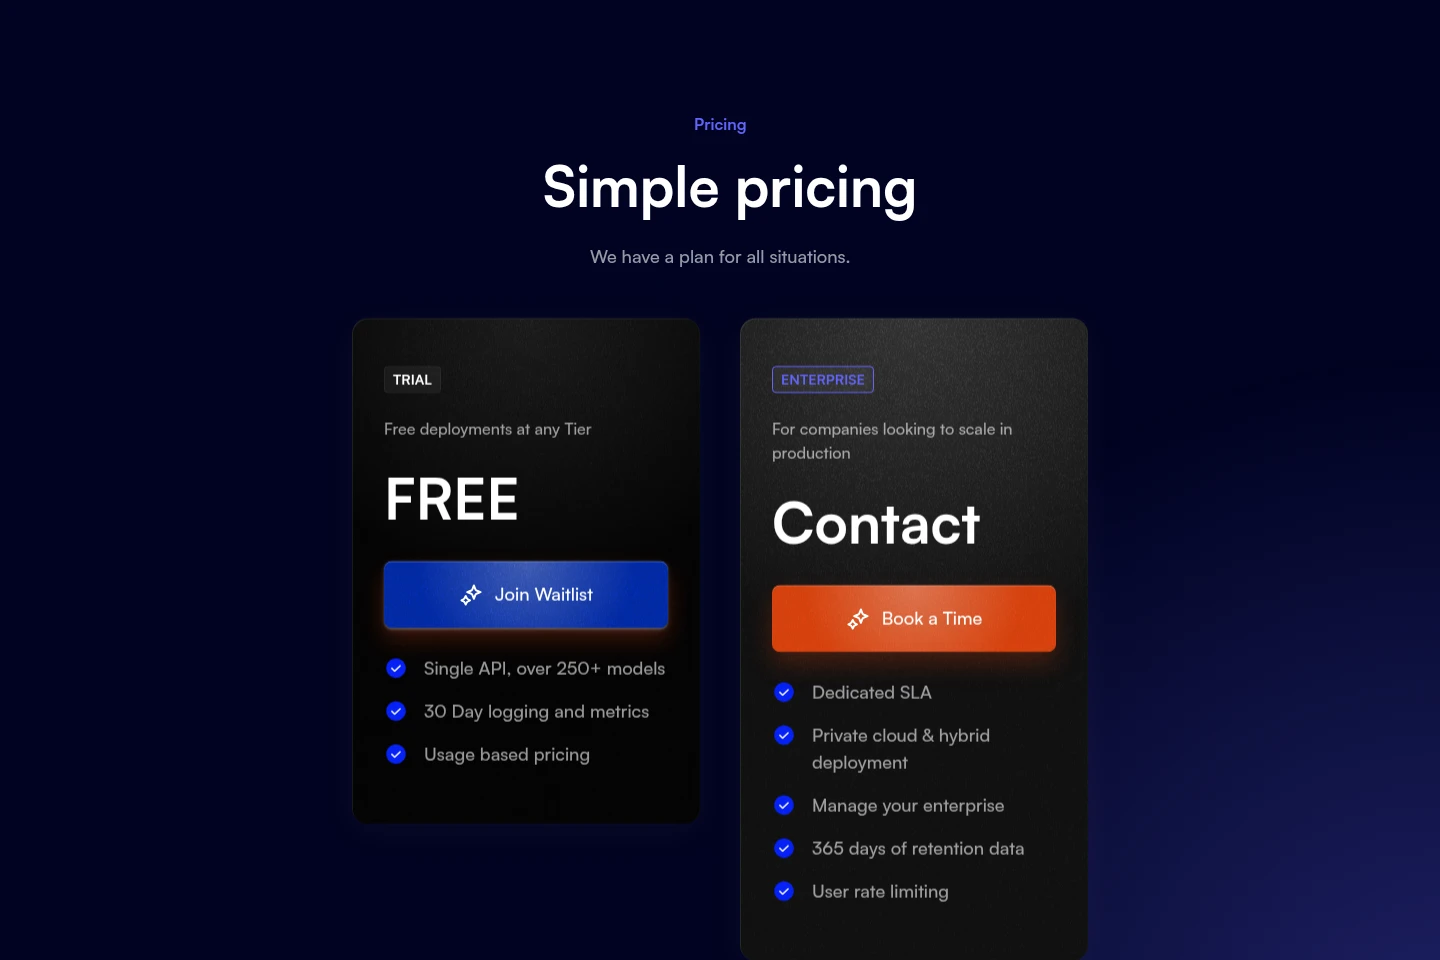
Pier bietet einen kostenlosen Trial-Plan und einen Enterprise-Plan mit Preis auf Anfrage. Vergleichen Sie beim Plan die Modellzugriffe, Protokollaufbewahrung, Deployment-Optionen und Enterprise-Kontrollen.
| Tarif | Preis | Leistungen und Limits |
|---|---|---|
| Trial | Kostenlos |
|
| Enterprise | Preis auf Anfrage |
|
Anwendungsfälle
Eine Anwendung mit KI-Modellen verbinden
Wenn eine Anwendung verschiedene KI-Modelle aufrufen muss, können Pier-API und ein API-Schlüssel für den Zugriff auf mehr als 250 Modelle genutzt werden. Die Integration unterstützt Fallbacks, Load Balancing, Wiederholungen und Caching.
Modelle für eine Anwendung bereitstellen und skalieren
Bei der Bereitstellung von Modellen oder Agenten für ein Produkt lassen sich Deployment und Skalierung über Pier verwalten. Der Enterprise-Plan nennt außerdem Private-Cloud- und Hybrid-Deployment.
Modellnutzung und Anwendungskosten prüfen
Wenn Teams Einblick in Modellaktivitäten benötigen, können sie verfügbare Nutzungsmetriken und Protokolle, darunter Token und Laufzeit, prüfen und Kosten verfolgen. Trial nennt 30 Tage; Enterprise nennt 365 Tage Datenaufbewahrung.
Einschränkungen
Der Trial-Plan nennt 30 Tage für Protokolle und Metriken; beim Enterprise-Plan sind 365 Tage Datenaufbewahrung angegeben.
Der Enterprise-Preis ist mit Contact angegeben; statt eines veröffentlichten Preises gibt es einen Buchungslink.
Die Website fordert Besucher auf, sich für eine Warteliste anzumelden; eine sofortige Selbstregistrierung wird nicht beschrieben.
Zielgruppen
Teams, die Anwendungen mit mehreren KI-Modellen entwickeln
Unternehmen, die Agenten bereitstellen und mehrere Produkte oder Teams verwalten
Organisationen mit Bedarf an Nutzungsüberwachung und Deployment-Optionen für KI im Produktivbetrieb
Häufige Fragen
Wie verbindet Pier Anwendungen mit KI-Modellen?
Pier bietet eine API und einen API-Schlüssel für mehr als 250 Modelle. Anwendungen können Modell-Fallbacks, Load Balancing, Wiederholungen, Caching und Canary-Tests nutzen.
Welche Nutzungsdaten können Teams einsehen?
Beschrieben werden Metriken und Protokolle wie Token und Laufzeit sowie die Verwaltung von Nutzern und Kosten. Der Trial-Plan nennt Protokolle und Metriken für 30 Tage.
Was umfasst der Trial-Plan?
Der Trial-Plan nennt kostenlose Deployments auf jeder Stufe, eine API für mehr als 250 Modelle, Protokolle und Metriken für 30 Tage sowie nutzungsabhängige Preise.
Wie wird Enterprise berechnet?
Der Enterprise-Preis ist mit Contact angegeben. Die Seite bietet einen Buchungslink und nennt eine dedizierte SLA, Private-Cloud- und Hybrid-Deployment, 365 Tage Datenaufbewahrung sowie Nutzer-Ratenbegrenzung.
Kommentare