Was ist der GPT-2 Output Detector
Die rasant fortschreitende Entwicklung großer Sprachmodelle hat eine fundamentale Herausforderung geschaffen: Die Fähigkeit, KI-generierte Texte von menschlich verfassten Inhalten zu unterscheiden, ist für Akademiker, Content-Ersteller und Plattformbetreiber gleichermaßen kritisch geworden. Ob bei der Überprüfung akademischer Arbeiten, der Validierung von Content-Originalität oder der Bekämpfung von KI-generierten Falschmeldungen – die Notwendigkeit einer zuverlässigen Erkennung ist offensichtlich.
Der GPT-2 Output Detector ist ein von OpenAI entwickeltes Werkzeug zur Echtzeiterkennung von KI-generierten Texten. Als technische Lösung nutzt dieses Tool einen auf RoBERTa basierenden Deep-Learning-Classifier, der speziell für die Identifikation von GPT-2-Ausgaben trainiert wurde. Die Software ist auf Hugging Face Spaces gehostet und weltweit zugänglich, wobei das zugehörige GitHub-Repository bereits über 2.000 Sterne verzeichnet.
Die technische Grundlage bildet ein binäres Klassifikationssystem, das Texteingaben analysiert und deren Wahrscheinlichkeit als „echt" (menschlich verfasst) oder „gefälscht" (KI-generiert) ausgibt. Der Detector unterscheidet zwischen zwei Modellvarianten: einer basis-Version mit 478 MB für schnelle Analysen und einer Large-Version mit 1,5 GB für Szenarien, die höhere Präzision erfordern.
核心要点
RoBERTa-basierter Deep-Learning-Classifier für binäre Klassifikation
Echtzeit-Visualisierung der Real- vs. Fake-Wahrscheinlichkeiten
Zwei Modellvarianten: detector-base (478 MB) und detector-large (1,5 GB)
Vollständig quelloffen mit Unterstützung für lokale Bereitstellung
Kernfunktionen des GPT-2 Output Detector
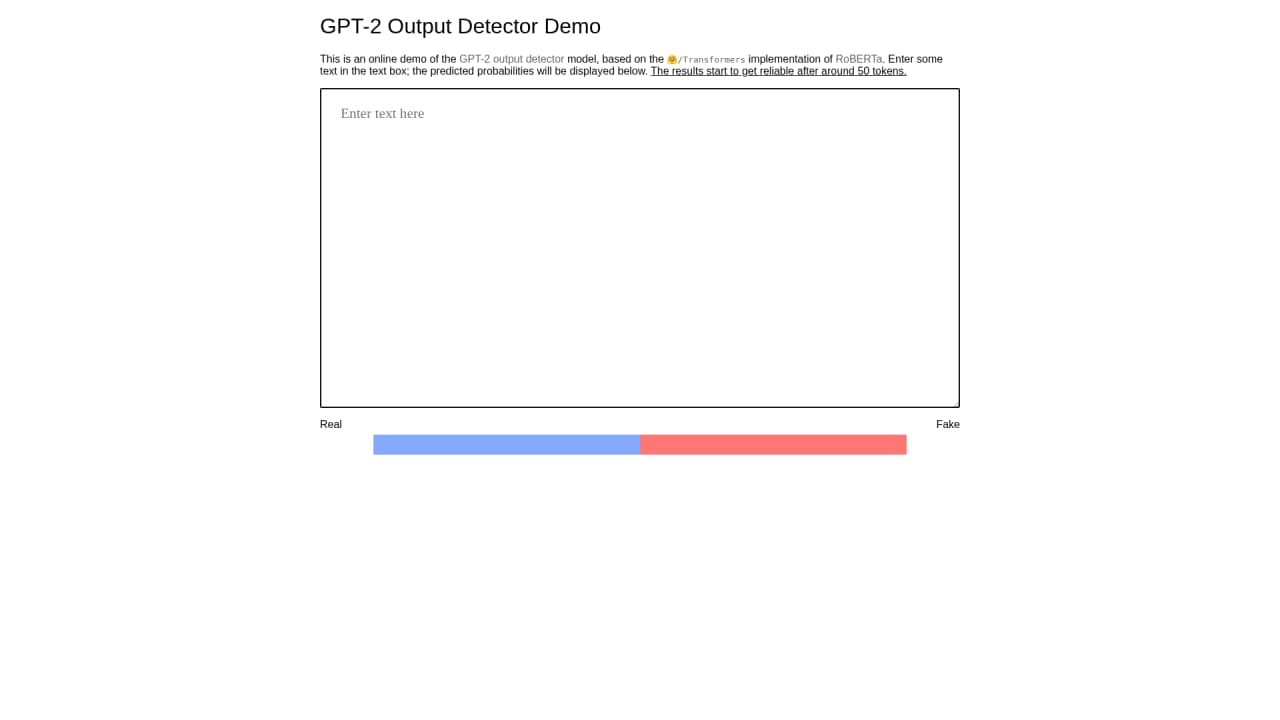
Der Detector bietet eine umfassende Palette an Funktionen, die sowohl für technische als auch für nicht-technische Anwender zugänglich sind. Die Kernfunktionalität besteht in der Echtzeit-Textanalyse, bei der Benutzer Text eingeben und sofort eine Klassifikation erhalten. Das System zeigt sowohl die Wahrscheinlichkeit für menschliche Verfassung („Real") als auch die Wahrscheinlichkeit für KI-Generierung („Fake") an.
Die Wahrscheinlichkeitsvisualisierung erfolgt über eine intuitive Slider-Darstellung, die die Verteilung zwischen Real und Fake prozentual abbildet. Diese visuelle Komponente ermöglicht eine schnelle Einschätzung ohne tiefgreifendes technisches Verständnis der zugrundeliegenden Modelle.
Technisch basiert der Detector auf Facebook AI's RoBERTa-Architektur, die durch Feintuning auf die Erkennung von GPT-2-Ausgaben spezialisiert wurde. Das Training verwendete eine Mischung aus Temperature-1 und Nucleus-Sampling-Ausgaben des GPT-2 1.5B-Modells, was die Generalisierungsfähigkeit des Modells verbessert.
Für Entwickler und Organisationen mit spezifischen Anforderungen bietet der Detector Open-Source-Deployments. Die vollständigen Trainings- und Inferenzcodes sind auf GitHub verfügbar, sodass Benutzer das Modell selbst hosten, anpassen oder auf eigenen Datensätzen neu trainieren können.
Kostenlos und quelloffen: Vollständiger Zugriff auf Trainingscode und Modellgewichte ohne Lizenzgebühren
Offizielle OpenAI-Unterstützung: Entwicklung und Wartung durch das OpenAI-Team gewährleistet Zuverlässigkeit
Flexible Bereitstellungsoptionen: Online-Demo für schnellen Einstieg, lokale Installation für Datenschutzanforderungen
Zwei Modellvarianten für Geschwindigkeit, large für Präzision – passend zum Anwendungsfall wählbar
Modellspezifische Begrenzung: Speziell auf GPT-2 trainiert; Erkennung von GPT-3/4-Ausgaben zeigt eingeschränkte Genauigkeit
Kurztext-Limitierung: Bei Eingaben unter 50 Tokens sinkt die Zuverlässigkeit der Klassifikation deutlich
Keine Beweiskraft: Ergebnisse dienen als Referenz, nicht als juristischer Nachweis
Anwendungsbereiche und Zielgruppen
Der GPT-2 Output Detector adressiert eine Vielzahl von Anwendungsfällen in unterschiedlichen Branchen. Das Verständnis dieser Einsatzgebiete hilft potenziellen Benutzern einzuschätzen, ob das Tool für ihre spezifischen Anforderungen geeignet ist.
Akademische Integritätsprüfung stellt einen der wichtigsten Anwendungsbereiche dar. Bildungsinstitutionen stehen vor der Herausforderung, dass Studierende zunehmend KI-Tools für Hausarbeiten und Abschlussarbeiten nutzen. Der Detector ermöglicht Lehrkräften und Prüfern eine schnelle Einschätzung, ob eingereichte Texte wahrscheinlich KI-generiert sind, und unterstützt damit akademische Integritätsprozesse.
Content-Originalitätsvalidierung betrifft Content-Ersteller, Redakteure und Verlage. Bei der Veröffentlichung von Texten ist die Kenntnis über die Herkunft des Inhalts wichtig – besonders wenn Aussagen über die Originalität gemacht werden. Der Detector hilft, KI-unterstützte Beiträge zu identifizieren und die Genauigkeit von Originalitätsansprüchen zu verifizieren.
News-Fact-Checking ist für Journalisten und Nachrichtenorganisationen relevant. Die Verbreitung KI-generierter Falschinformationen erfordert Werkzeuge zur Erkennung maschinell erstellter Artikel. Der Detector bietet eine erste Analyseebene zur Unterstützung der journalistischen Überprüfungsprozesse.
Plattform-Content-Moderation adressiert Entwickler und Betreiber digitaler Plattformen. Automatisierte Systeme können den Detector integrieren, um KI-generierte Beiträge zu identifizieren und die Content-Qualität auf ihren Plattformen zu maintainen.
KI-Sicherheitsforschung nutzen Wissenschaftler und Forscher, die standardisierte Erkennungswerkzeuge für ihre AI-Safety-Arbeiten benötigen. Der Detector dient als Benchmark und Evaluationswerkzeug in der Forschungsgemeinschaft.
💡 Versionsauswahl nach Anwendungsfall
Für schnelle Erstüberprüfungen und ressourcenbeschränkte Umgebungen empfiehlt sich detector-base. Für kritische Anwendungen mit höheren Genauigkeitsanforderungen – etwa akademische Prüfungen oder journalistische Fact-Checks – ist detector-large vorzuziehen. Beide Versionen erfordern längere Eingabetexte (mindestens 50 Tokens) für zuverlässige Ergebnisse.
Schnellstart-Anleitung
Der Einstieg in den GPT-2 Output Detector erfolgt am einfachsten über die Online-Demo. Benutzer können direkt die Adresse https://openai-openai-detector.hf.space aufrufen und erhalten sofortigen Zugang zur Anwendung ohne Installation oder Konfiguration.
Der typische Workflow beginnt mit der Texteingabe im bereitgestellten Eingabefeld. Es wird empfohlen, mindestens 50 Tokens (zirka 30-40 Wörter) einzugeben, da kürzere Texte die Zuverlässigkeit der Klassifikation signifikant reduzieren. Nach der Eingabe zeigt das System sofort die Ergebnisse an, aufgeschlüsselt nach „Real"- und „Fake"-Wahrscheinlichkeiten.
Die Ergebnisinterpretation erfordert Verständnis für die statistische Natur der Klassifikation. Ein Wert von 99% „Fake" bedeutet nicht absolute Sicherheit, sondern eine hohe Wahrscheinlichkeit basierend auf den trainierten Mustern. Benutzer sollten die Ergebnisse als Referenzinformation betrachten und nicht als definitive Urteile.
Für lokale Bereitstellung bietet OpenAI Downloads der Modellgewichte an: detector-base mit 478 MB und detector-large mit 1,5 GB. Die lokale Ausführung erfordert eine GPU-Beschleunigung für akzeptable Inferenzgeschwindigkeiten. Die vollständigen Anweisungen und der Code sind im GitHub-Repository verfügbar.
💡 Best Practice für Einsteiger
Beginnen Sie mit der Online-Demo, um ein Gefühl für die Ergebnisqualität zu entwickeln. Testen Sie verschiedene Textarten – sowohl bekanntermaßen menschliche als auch KI-generierte Texte – um die Stärken und Grenzen des Detectors intuitiv zu verstehen, bevor Sie ihn in produktive Workflows integrieren.
Technische Spezifikationen
Die technische Architektur des GPT-2 Output Detector basiert auf etablierten Deep-Learning-Prinzipien und modernen Transfer-Learning-Ansätzen. Das Fundament bildet das RoBERTa-Modell (Robustly Optimized BERT Pretraining Approach), entwickelt von Facebook AI, das durch sein robustes Pretraining bekannt geworden ist.
Das Modelltraining verwendete spezifische Strategien zur Optimierung der Erkennungsleistung. Als Trainingsdaten dienten Ausgaben des GPT-2 1.5B-Modells, wobei sowohl Temperature-1-Sampling als auch Nucleus-Sampling zum Einsatz kamen. Diese Kombination erhöht die Variabilität der Trainingsdaten und verbessert die Fähigkeit des Detectors, verschiedene Generierungsstile zu erkennen.
Die Architektur implementiert einen binären Klassifikator, der die Eingabetoken analysiert und eine Wahrscheinlichkeitsverteilung über die zwei Klassen „menschlich" und „KI-generiert" ausgibt. Die Repräsentation des RoBERTa-Modells ermöglicht die Erfassung kontextueller Muster, die für die Unterscheidung relevant sind.
Hinsichtlich Leistungsparametern zeigt der Detector bei ausreichend langen Eingaben (über 50 Tokens) eine zuverlässige Erkennungsrate. Die Genauigkeit variiert je nach Textart und -komplexität. Für optimale Ergebnisse empfiehlt sich die Verwendung des Large-Modells in Kombination mit längeren Texteingaben.
Die Transparenz des Projekts zeigt sich in der vollständigen Verfügbarkeit von Trainingscode, Modellgewichten und technischer Dokumentation. Der zugehörige technische Report (verfügbar unter https://d4mucfpksywv.cloudfront.net/papers/GPT_2_Report.pdf) erläutert die Methodik detailliert. Das GitHub-Repository unter openai/gpt-2-output-dataset bietet zusätzliche Ressourcen für Entwickler.
Technische Parameter
Modellarchitektur: RoBERTa-base (124M Parameter) / RoBERTa-large (355M Parameter)
Trainingsdaten: GPT-2 1.5B Ausgaben mit Temperature-1 und Nucleus Sampling
Modellgrößen: detector-base 478 MB, detector-large 1,5 GB
Zuverlässigkeitsschwelle: ≥50 Tokens Eingabelänge
Inferenz: GPU-beschleunigt empfohlen für lokale Bereitstellung
Häufig gestellte Fragen
Wie zuverlässig sind die Erkennungsergebnisse?
Die Zuverlässigkeit der Ergebnisse hängt maßgeblich von der Eingabelänge ab. Bei Texten mit mindestens 50 Tokens zeigt der Detector akzeptable Genauigkeitswerte. Kürzere Texte führen zu deutlich geringerer Zuverlässigkeit, da dem Modell weniger Kontext für die Analyse zur Verfügung steht. Es wird empfohlen, längere Absätze oder vollständige Dokumente für die Klassifikation zu verwenden.
Kann der Detector auch GPT-3 oder GPT-4 Ausgaben erkennen?
Der Detector wurde spezifisch auf GPT-2 1.5B-Ausgaben trainiert und optimiert. Die Erkennung von Texten, die mit neueren Modellen wie GPT-3 oder GPT-4 generiert wurden, kann daher weniger zuverlässig sein. Neuere Modelle verwenden unterschiedliche Trainingsmethoden und Generierungsstrategien, die vom Detector möglicherweise nicht effektiv identifiziert werden. Für diese Modelle existieren spezialisierte Detektoren.
Wie kann ich die Erkennungsgenauigkeit verbessern?
Zwei Hauptfaktoren beeinflussen die Genauigkeit positiv: Erstens sollte das detector-large-Modell verwendet werden, das mehr Parameter und damit höhere Kapazität besitzt. Zweitens erhöht eine längere Eingabe (mehrere Absätze statt einzelner Sätze) die Zuverlässigkeit signifikant. Die Kombination beider Faktoren liefert die besten Ergebnisse für kritische Anwendungsfälle.
Ist eine lokale Ausführung möglich?
Ja, der Detector kann lokal部署 werden. OpenAI stellt die Modellgewichte zum Download bereit (detector-base.pt und detector-large.pt). Für den Betrieb ist eine GPU mit CUDA-Unterstützung empfehlenswert, da die Inferenz auf CPUs erheblich langsamer ist. Die vollständigen Anweisungen für lokale Installation und Ausführung sind im GitHub-Repository dokumentiert.
Können die Erkennungsergebnisse als juristischer Beweis verwendet werden?
Nein, die Ergebnisse des GPT-2 Output Detector können nicht als juristischer Beweis oder in offiziellen Verfahren verwendet werden. Der Detector liefert Wahrscheinlichkeitsaussagen und keine definitiven Urteile. Die Möglichkeit falsch-positiver und falsch-negativer Ergebnisse bleibt bestehen. Die Verwendung sollte ausschließlich als Referenz und Unterstützung erfolgen, nicht als alleinige Entscheidungsgrundlage.



Kommentare