Mistral Large 4
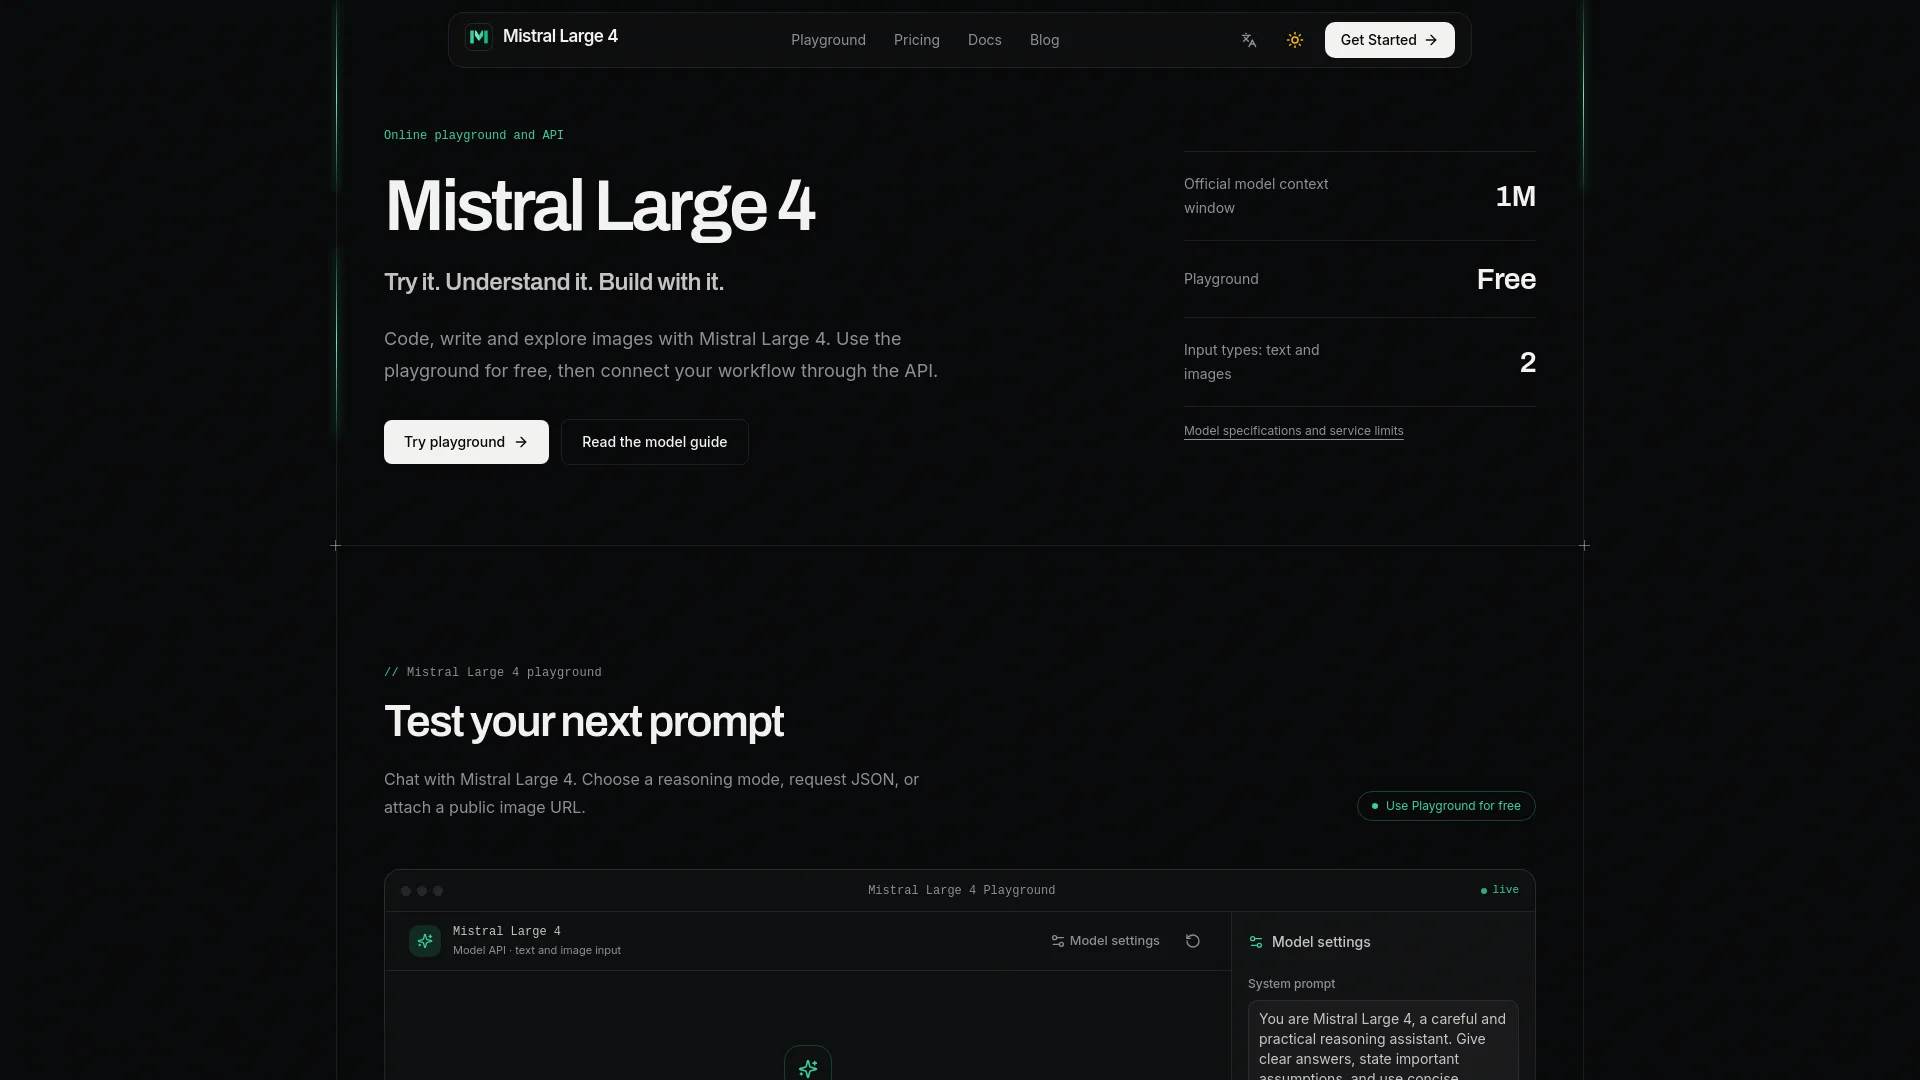
Mistral Large 4 ist ein allgemein einsetzbares multimodales KI-Modell, das über einen kostenlosen browserbasierten Playground und eine OpenAI-kompatible REST-API verfügbar ist. Es wurde entwickelt, um gängige KI-Aufgaben zu unterstützen – darunter Codierung, Dokumentenanalyse, Bildinterpretation, Textverfassung und Generierung strukturierter Daten. Das Modell verfügt über ein offizielles Kontextfenster von 1 Million Tokens, mit einstellbaren Steuerelementen, um das Ausgabeverhalten für unterschiedliche Anwendungsfälle zu optimieren.
Kernfunktionen
Mistral Large 4 unterstützt sowohl Text- als auch Bildeingaben, um eine breite Palette praktischer Aufgaben direkt out of the box zu bearbeiten. Nutzer können Code-Snippets zur Überprüfung einreichen, Dokumentauszüge einfügen, um gezielte Fragen zu stellen, oder öffentliche Bild-URLs teilen, um Screenshots, Diagramme und visuelle Daten zu interpretieren.
Für API-basierte Arbeitsabläufe unterstützt das Modell benutzerdefinierte Funktionsaufrufe, um Tool-Integrationen wie externe Suchvorgänge oder interne Datenabfragen zu ermöglichen – wobei die vollständige Kontrolle über die Ausführungslogik auf Seiten des Nutzers verbleibt. Das Modell kann nativ strukturierte JSON-Ausgaben für Anwendungsfälle wie Inhaltsklassifizierung, Datenextraktion und Arbeitsablaufplanung generieren, sodass zusätzliche Parsing-Schritte für nachgeschaltete Systeme entfallen, die vorhersehbar formatierte Daten erwarten.
Integrierte konfigurierbare Steuerelemente ermöglichen es Nutzern, das Verhalten pro Anfrage anzupassen: Sie können benutzerdefinierte System-Prompts festlegen, um die Standardrolle und den Ausgabestil des Assistenten zu definieren, die Temperatur anpassen, um die Zufälligkeit der Ausgabe zu steuern, und den Reasoning-Aufwand zwischen direkten Antworten mit geringem Aufwand und tiefergehenden, aufwändigeren Überlegungen für komplexe Problemlösungen umschalten.
Der kostenlose Online-Playground erfordert keine Programmierkenntnisse, um Prompts zu testen, während die API native Streaming-Unterstützung für die Echtzeit-Auslieferung von Antworten in integrierten Anwendungen bietet.
Unterstützte Arbeitsabläufe
Der No-Code-Playground-Arbeitsablauf ist für schnelles, reibungsarmes Testen ausgelegt:
Melden Sie sich an, um auf die kostenlose Playground-Oberfläche zuzugreifen
Fügen Sie Text oder Code direkt in das Eingabefeld ein, oder fügen Sie eine öffentliche Bild-URL neben Ihrem Prompt hinzu, und passen Sie die Modelleinstellungen – einschließlich Reasoning-Aufwand, Temperatur und maximaler Ausgabetokens – nach Bedarf an
Überprüfen Sie die Antwort des Modells, verfeinern Sie Ihre Abfrage mit Folge-Prompts und validieren Sie die Ausgaben anhand Ihres Ausgangsmaterials, bevor Sie auf umfassendere Integrationen skalieren. Für PDF-Inhalte extrahieren Sie zunächst relevante Textauszüge, um diese über die Texteingabe einzureichen.
Für Entwickler-API-Integrationen nutzt der Arbeitsablauf standardisierte OpenAI-kompatible Tools:
Generieren Sie einen serverseitigen API-Schlüssel in Ihren Kontoeinstellungen und konfigurieren Sie Ihren OpenAI-Client so, dass er auf die Basis-URL der Mistral Large 4 API verweist
Senden Sie Anfragen mit Ihrem Text, Bild-URLs, benutzerdefinierten System-Prompts und allen definierten Tool-Funktionen, wobei Sie Ihren gewünschten Reasoning-Aufwand und das Ausgabeformat angeben
Validieren Sie alle zurückgegebenen Tool-Aufrufanfragen in Ihrer eigenen Anwendungslogik, bevor Sie genehmigte Funktionen ausführen, und übergeben Sie die Ergebnisse zurück an das Modell, um den Arbeitsablauf fortzusetzen. Sie können Streaming aktivieren, um Endnutzern inkrementelle Antworten bereitzustellen, sobald diese generiert werden.
Zielgruppen
Mistral Large 4 wurde für vier primäre Nutzergruppen entwickelt:
Entwickler, die benutzerdefinierte KI-Anwendungen und Agenten erstellen und einen flexiblen, OpenAI-kompatiblen Endpunkt benötigen, um multimodale Fähigkeiten mit Funktionsaufrufen zu integrieren – ohne eigenes Modell-Hosting betreiben zu müssen
Gelegenheitsnutzer und Prompt-Ingenieure, die KI-Prompts testen, iterieren und verfeinern müssen, ohne Code schreiben oder Infrastruktur verwalten zu müssen
Funktionsübergreifende Teams, die an Projekten zur Code-Überprüfung, Dokumentenanalyse und Bildinterpretation arbeiten und eine gemeinsame Umgebung benötigen, um Ausgaben zu testen, bevor Arbeitsabläufe im großen Maßstab eingeführt werden
Organisationen, die allgemein einsetzbare multimodale KI-Fähigkeiten in ihre bestehenden internen Arbeitsabläufe integrieren möchten – mit konfigurierbarer Nutzungsabrechnung, die sich an variable Nachfrage anpasst.
Preise und Nutzungsbedingungen
Mistral Large 4 wird nach einem Freemium-Modell betrieben. Der Online-Playground steht nach der Anmeldung kostenlos zur Verfügung, wobei die gesamte Nutzung über die kostenlose Freigrenze hinaus über ein Kreditsystem berechnet wird: Credits werden als tatsächliche Modellkosten in USD multipliziert mit 12.000 berechnet und auf die nächste ganze Zahl aufgerundet. Alle Anfragen, die zur Generierung zugelassen werden, zählen zur Nutzung – selbst wenn sie später abgebrochen werden oder nicht abgeschlossen werden können.
Einmalige Kreditpakete sind für Nutzer mit gelegentlicher oder projektbezogener Nutzung verfügbar: Diese Pakete laufen nie ab und werden nicht automatisch verlängert. Verfügbare einmalige Pakete umfassen 80.000 Credits für 10 USD, 1.000.000 Credits für 100 USD und 11.000.000 Credits für 1000 USD.
Monatliche Abonnementpläne gewähren eine festgelegte Anzahl von Credits pro Abrechnungszeitraum, wobei jede Credit-Zuweisung ab dem Datum der Hinzufügung zum Konto 90 Tage gültig ist. Alle Pläne umfassen den Zugriff auf den vollständigen Funktionsumfang des Playgrounds, anpassbare Modellsteuerelemente, API-Zugriff und E-Mail-Support.
Aktuelle Einschränkungen
Stand 7. Oktober 2026 gelten folgende Diensteinschränkungen:
Der kostenlose Playground unterstützt keine PDF-Uploads, Audio-Eingaben oder Video-Eingaben. Er akzeptiert nur eingefügten Text und öffentliche Bild-URLs.
Die Eingabegrenzen des Playgrounds sind auf insgesamt 24 Nachrichten pro Konversation, 24.000 Zeichen pro einzelner Nachricht, 96 KiB pro vollständiger Anfrage und maximal 16.384 Ausgabetokens festgelegt. Das offizielle 1-Million-Token-Kontextfenster des Modells ist nicht die aktive Eingabefreigrenze für die Playground-Oberfläche.
Die öffentliche API-Integration ist auf eine Kontextgrenze von 524.288 Tokens ausgelegt, die unter der angegebenen maximalen Kapazität von 1 Million Tokens des Modells liegt.
Die Modellgewichte sind derzeit noch nicht für Self-Hosting verfügbar, eine öffentliche Veröffentlichung ist für Ende Oktober 2026 geplant. Vor dieser Veröffentlichung sind keine Bedingungen für selbst gehostete Bereitstellungen oder kommerzielle Lizenzen bestätigt.
Der gehostete Playground ist keine private Bereitstellung. Vertrauliche Unternehmensdokumente oder sensible regulierte Daten sollten nicht an den Playground übermittelt werden. Nutzern wird empfohlen, die Datenschutzrichtlinie der Plattform zu Details zur Datenverarbeitung, Aufbewahrung und geografischen Hosting-Regionen zu prüfen, bevor sie sensible Inhalte über die API verarbeiten.




Kommentare