

- Monatliche Besuche
- 2.444
- 2026-09
LLMPrice - LLM-API-Preise mit workloadbasierten Kostenschätzungen vergleichen
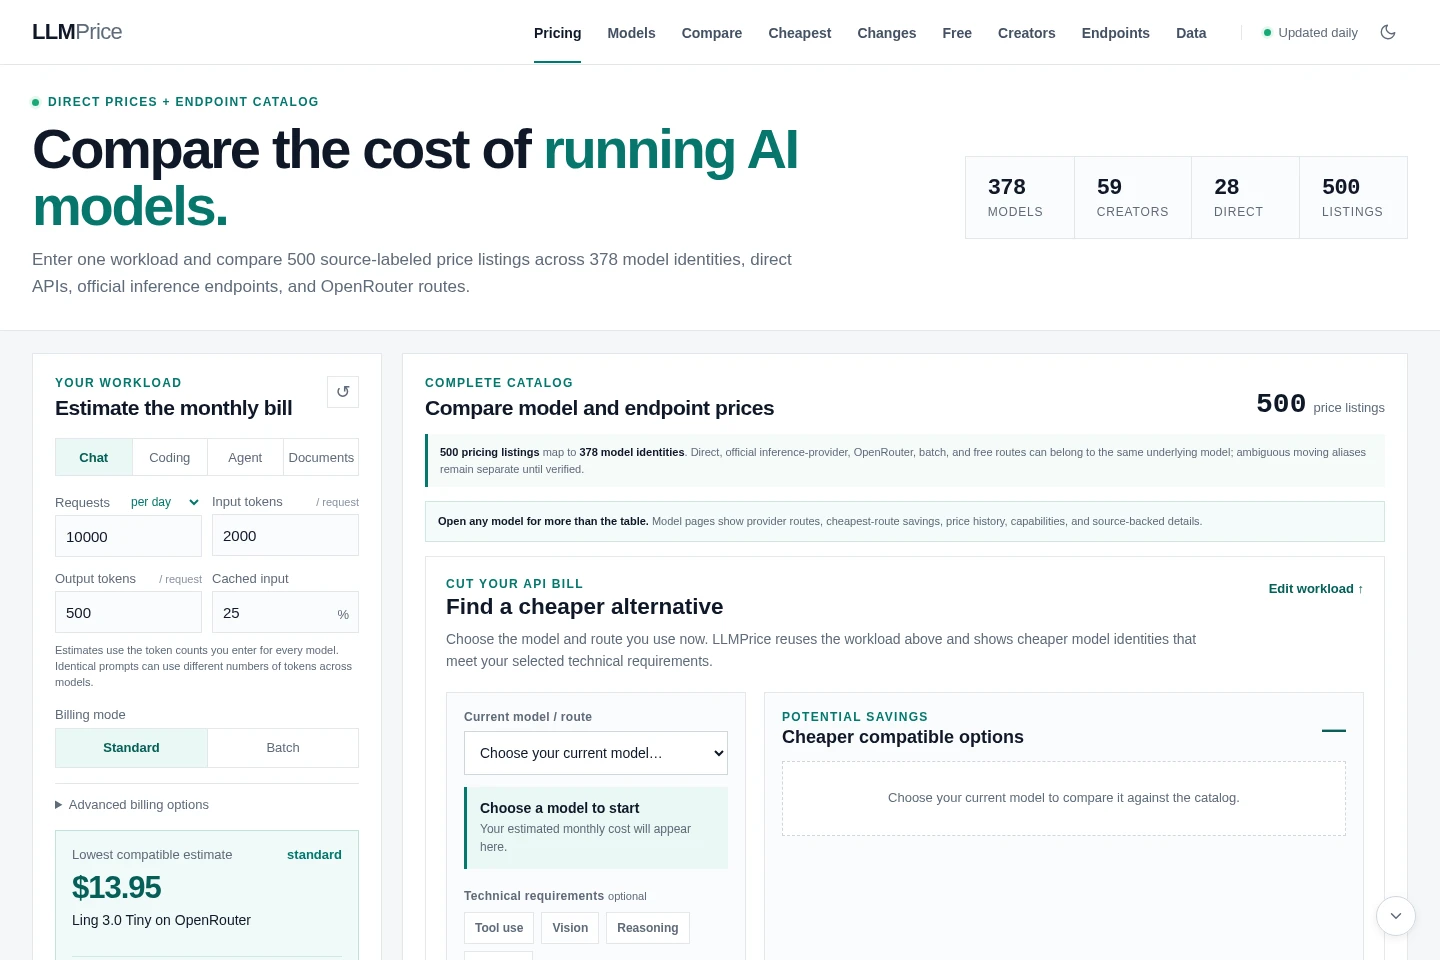
LLMPrice ist ein Katalog und Rechner zum Vergleich von Preisen für Sprachmodell-APIs bei direkten APIs, Inferenzanbietern und OpenRouter. Nutzer geben Anfragen und Tokenmengen ein und passen Cache, Batch-Modus, aktive Tage, Wiederholungen und Reasoning-Tokens an, um Monatskosten zu schätzen. Außerdem lassen sich Modellrouten durchsuchen, nach Endpunkt und Fähigkeiten filtern und Alternativen anhand eines ausgewählten Modells und Workloads vergleichen.
- LLM-Entwicklertools
- LLM-APIs
- Datenanalyse
- LLM-API-Preisvergleich
- KI-Modell-Kostenrechner
- Token-Preiskatalog
Funktionen
Workload-Kostenschätzung
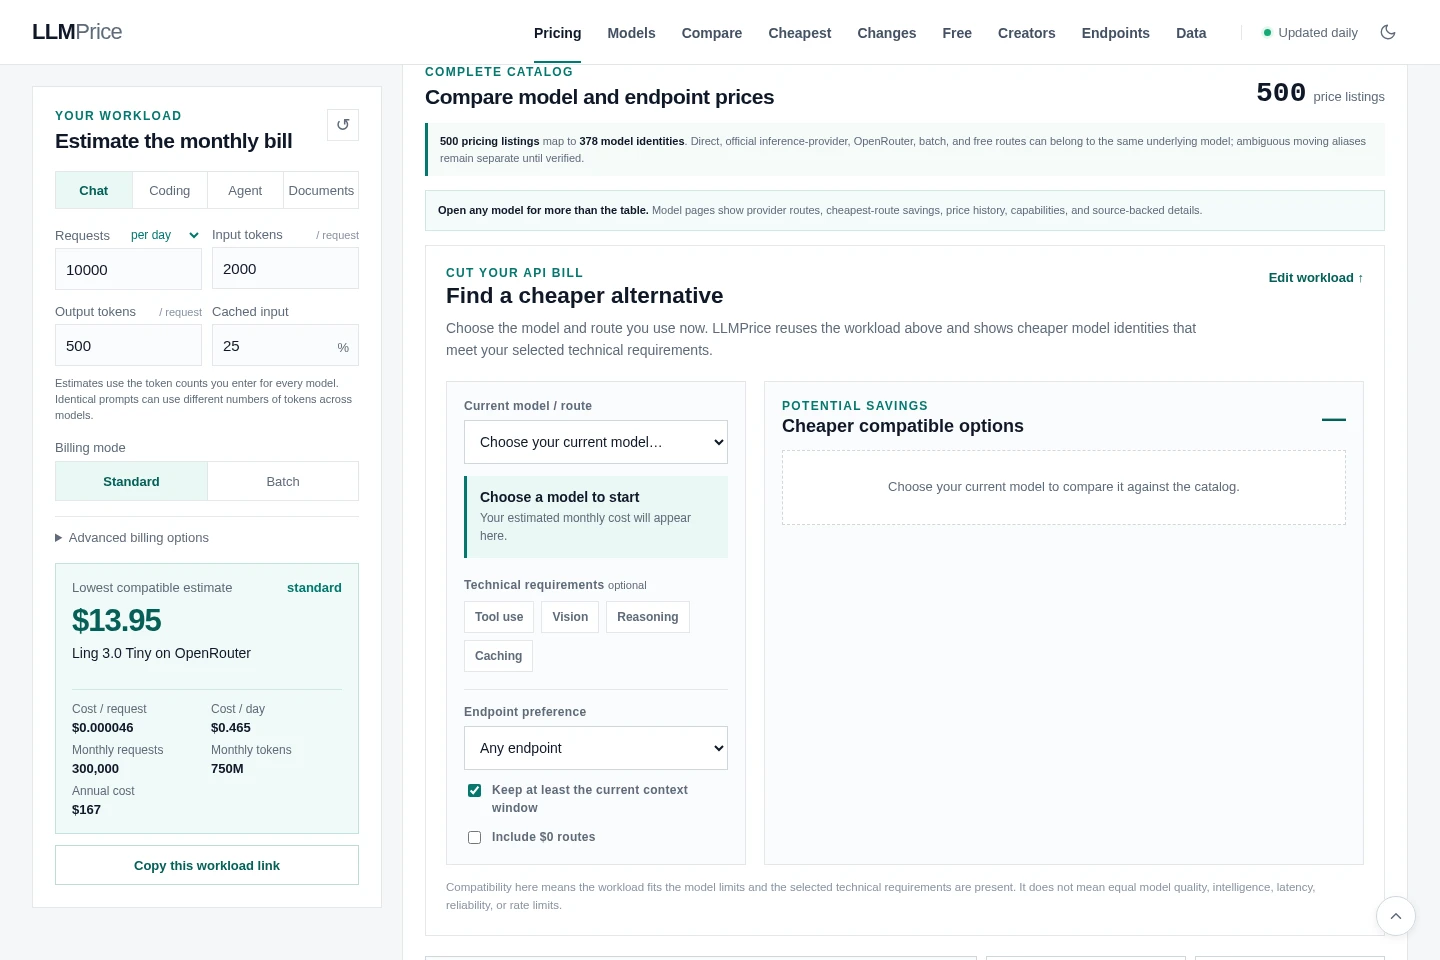
Schätzt Modellkosten für einen Workload und gibt Kosten pro Anfrage sowie Tages-, Monats- und Jahreswerte aus. Nutzer geben Anfragen und Ein-/Ausgabe-Tokens ein und passen Cache-Eingaben, aktive Tage, Wiederholungen, Cache-Schreibvorgänge, Reasoning-Tokens und Abrechnungsmodus an.
Modellpreiskatalog
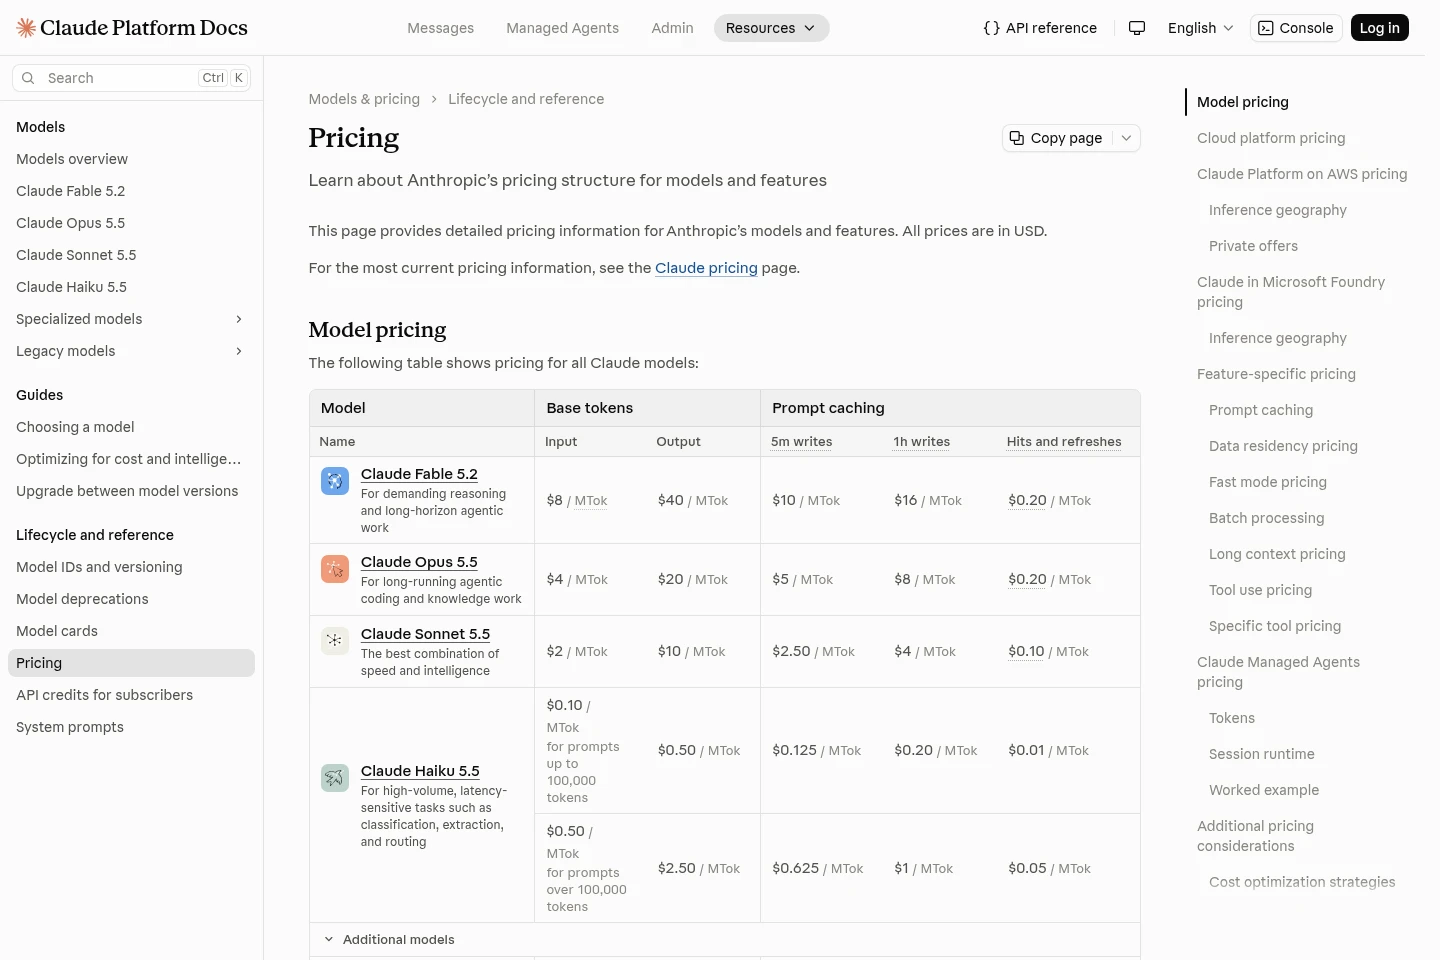
Zeigt quellengekennzeichnete Modell- und Endpunktpreise sowie vergleichbare Preis- und Kontextdaten. Nutzer durchsuchen oder filtern Einträge nach Modell, Anbieter, Endpunkt, kostenpflichtigem oder kostenlosem Status und aufgeführten Fähigkeiten.
Vergleich alternativer Modelle
Findet günstigere Modellidentitäten, die ausgewählte technische Anforderungen erfüllen, und gibt geschätzte Alternativkosten aus. Nutzer wählen ein aktuelles Modell und eine Route, übernehmen den Workload und können Tool-Nutzung, Vision, Reasoning, Caching oder ein Mindest-Kontextfenster voraussetzen.
Modell- und Routendetails
Zeigt zu Modelleinstellungen Anbieterrouten, Preisverlauf, Fähigkeiten und quellenbasierte Details. Nutzer öffnen einen Modelleindruck, um die verfügbaren Eintragsinformationen aufzurufen.
Preise
LLMPrice listet keine Produktpläne oder Abonnements; der Preiskatalog und Rechner sind kostenlos durchsuchbar. Verglichen werden die in den Einträgen angezeigten Modell- und Endpunkttarife, also Anbieterpreise und keine LLMPrice-Planpreise.
Anwendungsfälle
API-Kosten eines Workloads schätzen
Bei der Planung von API-Nutzung für Chat, Coding, Agents oder Dokumente geben Nutzer Anfrage- und Tokenmengen ein, um Kosten über Modelle hinweg zu berechnen. Einstellungen für Abrechnung und Workload ändern die geschätzten Kosten pro Anfrage sowie Tages-, Monats- und Jahreswerte.
Modellpreise über Endpunkte vergleichen
Bei der Wahl einer API-Modellroute können Nutzer Einträge für direkte APIs, Inferenzanbieter und OpenRouter durchsuchen. Sie vergleichen Eingabe, Cache-Eingabe, Ausgabe, Kontext und geschätzte Monatskosten; die Quellen sind an den Einträgen angegeben.
Günstigere kompatible Modelle finden
Wenn das aktuelle Modell und die Route feststehen, wählen Nutzer beide aus und vergleichen anhand desselben Workloads günstigere Modellidentitäten. Optionale technische Anforderungen filtern Kandidaten; Kompatibilität belegt jedoch keine gleiche Qualität, Latenz, Zuverlässigkeit oder Rate-Limits.
Einschränkungen
Kostenschätzungen beruhen auf den für jedes Modell eingegebenen Tokenzahlen; identische Prompts können je nach Modell unterschiedlich viele Tokens benötigen.
Der Kompatibilitätsvergleich prüft Modellgrenzen und ausgewählte technische Anforderungen, nicht gleiche Qualität, Intelligenz, Latenz, Zuverlässigkeit oder Rate-Limits.
Kostenlose Routen werden separat aufgeführt, da ihre Rate-Limits und Verfügbarkeit variieren.
Zielgruppen
Entwickler und Betreiber, die Ausgaben für Sprachmodell-APIs schätzen
Nutzer, die vor der Modellwahl Anbieter und API-Routen vergleichen
Entwickler, die Modelle für Chat-, Coding-, Agent- oder Dokument-Workloads prüfen
Häufige Fragen
Wie schätzt LLMPrice die Kosten eines Workloads?
Die eingegebenen Tokenzahlen und Workload-Einstellungen werden auf die Modellpreise angewendet. Anfragezahl, Ein- und Ausgabetokens, Cache-Eingabe, Abrechnungsmodus, aktive Tage, Wiederholungen, Cache-Schreibvorgänge und Reasoning-Tokens können die Schätzung beeinflussen.
Ist eine kompatible Alternative genauso leistungsfähig wie mein Modell?
Nicht unbedingt. Kompatibilität bedeutet, dass der Workload in die Modellgrenzen passt und ausgewählte technische Anforderungen erfüllt sind. Gleiche Modellqualität, Intelligenz, Latenz, Zuverlässigkeit oder Rate-Limits sind damit nicht zugesichert.
Warum werden kostenlose Modellrouten separat angezeigt?
Bei kostenlosen Routen variieren Rate-Limits und Verfügbarkeit. Deshalb werden sie separat aufgeführt; der Katalog unterscheidet außerdem kostenpflichtige und kostenlose Einträge.
Welche Preisinformationen lassen sich vergleichen?
Die Einträge zeigen quellengekennzeichnete Modell- und Endpunktpreise für Eingabe, Cache-Eingabe, Ausgabe, Kontext und geschätzte Monatskosten. Modellseiten enthalten außerdem Anbieterrouten, Preisverlauf, Fähigkeiten und quellenbasierte Details.
Kommentare