
- Monatliche Besuche
- 250.617
- 2026-09
- Monatliches Wachstum +24,1 %
Featherless - Offene Modelle über eine Inference-API ausführen
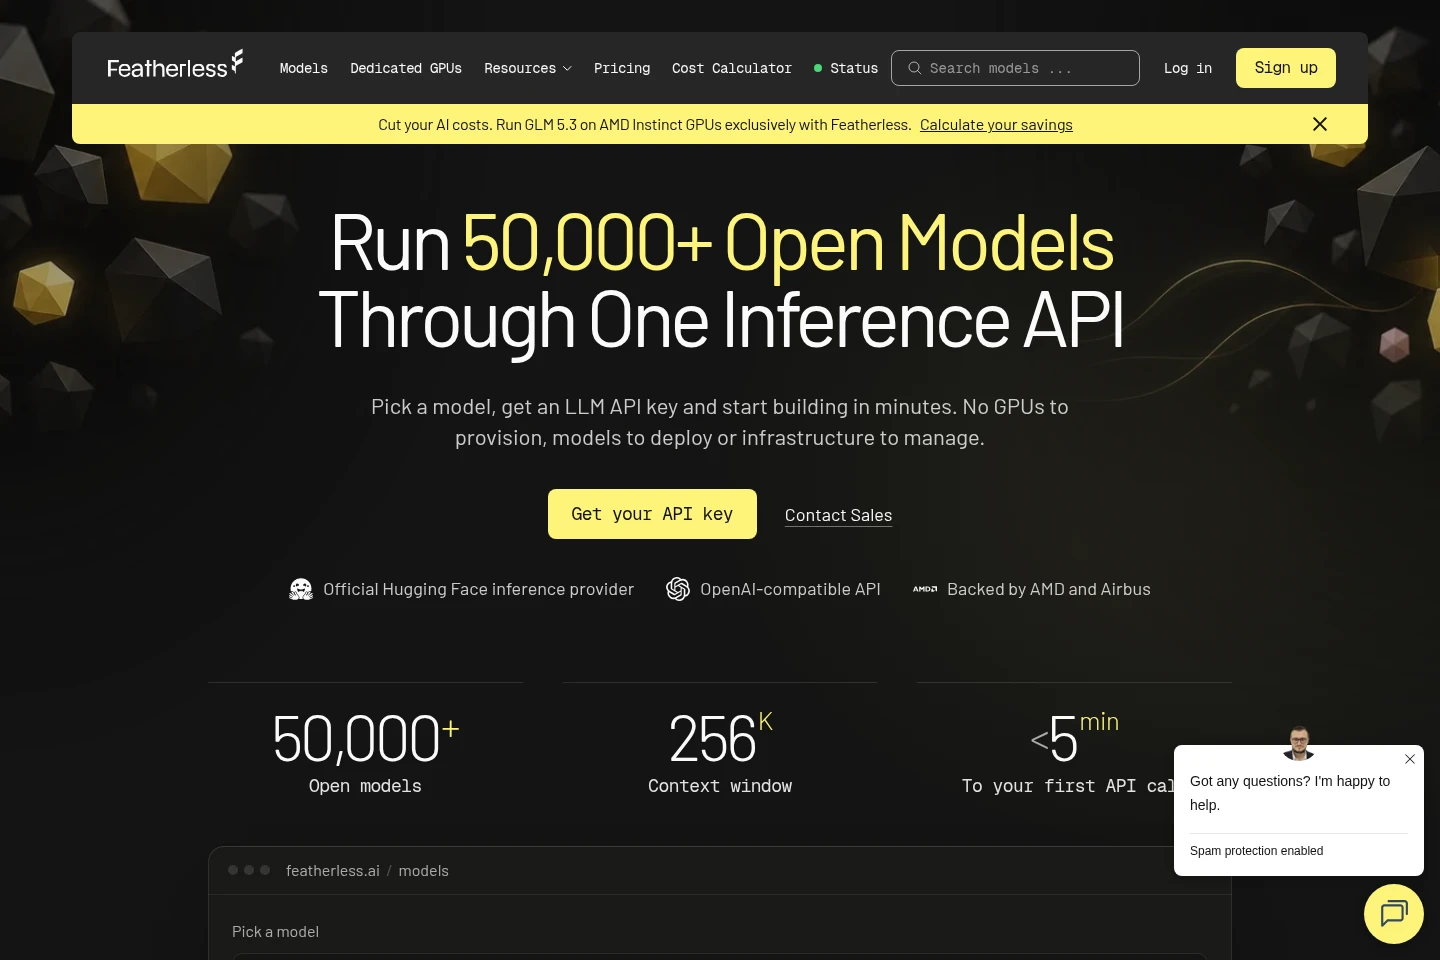
Featherless bietet gehostete Inference für offene Modelle über eine OpenAI-kompatible API. Nutzer wählen aus einem Katalog mit mehr als 40.000 Modellen, erstellen einen API-Schlüssel und senden Anfragen, ohne GPUs bereitzustellen. Chat, Developer und Business unterscheiden sich nach Nutzung, Kontext, Parallelität und Abrechnung.
- LLM-Entwicklertools
- LLM-APIs
- GPU-Cloud
- Inference-API für offene Modelle
- serverloses LLM-Hosting
- OpenAI-kompatible Modell-API
Funktionen
Serverlose Modell-Inference
Führt offene Modelle über eine gehostete Inference-API aus und gibt Modellantworten zurück. Nutzer wählen ein Modell und senden Anfragen mit einem API-Schlüssel; Featherless betreibt die GPU-Infrastruktur, sodass Kunden keine GPUs bereitstellen oder Modellgewichte deployen müssen.
Katalog offener Modelle
Durchsucht einen Katalog mit mehr als 40.000 offenen Modellen, darunter Modellfamilien, Fine-Tunes und Community-Varianten. Ein Modellwechsel erfolgt, indem die Modell-ID in der API-Anfrage geändert wird.
OpenAI-kompatible API
Sendet Modellanfragen über einen OpenAI-kompatiblen API-Endpunkt und liefert Inference-Antworten. Endpunkt und API-Schlüssel werden im OpenAI SDK konfiguriert; Developer und Business unterstützen API-Nutzung in Produktionsumgebungen.
Inference auf dedizierten GPUs
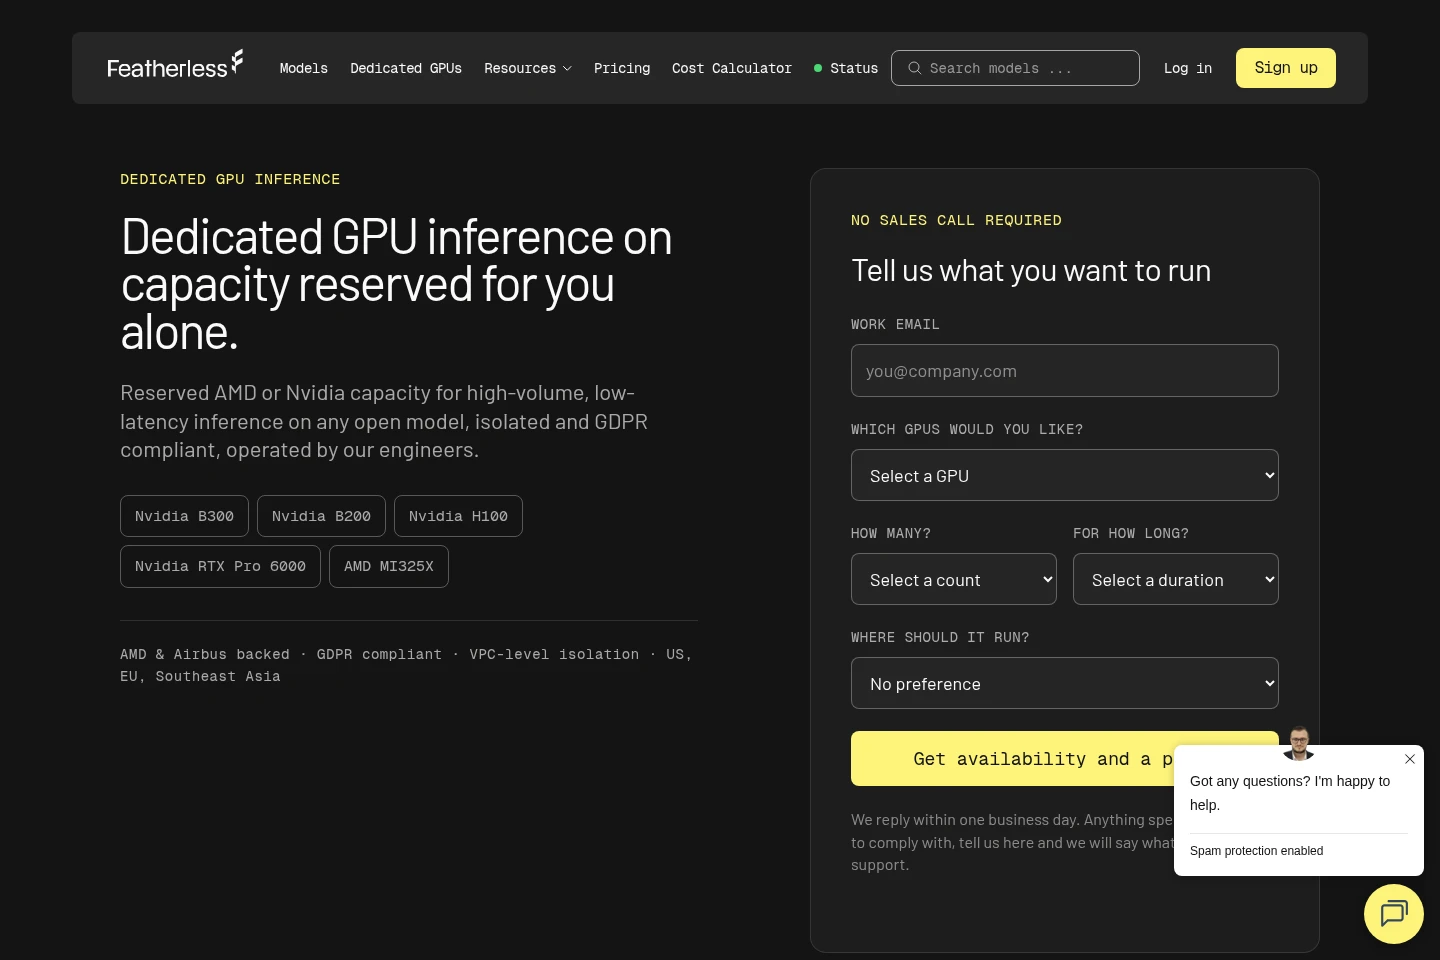
Führt Inference auf reservierter GPU-Kapazität über einen dedizierten Endpunkt aus. Verfügbare Nvidia- oder AMD-Beschleuniger können gewählt werden; Featherless-Ingenieure übernehmen das Tuning. VPC-Isolierung und GDPR-Konformität sind enthalten.
Preise
Featherless bietet ein monatliches Chat-Abo, Developer mit monatlichem Guthaben und tokenbasierter Abrechnung sowie individuelle Business-Verträge. Vergleichen Sie Nutzung, Kontextfenster, Parallelität und die Abrechnung als Pauschale, pro Token oder Vertrag.
| Tarif | Preis | Leistungen und Limits |
|---|---|---|
| Chat | $25/Monat; monatliche Abrechnung |
|
| Developer | $50 Guthaben pro Monat |
|
| Business | Individuell; Jahresverträge |
|
Chat-Abos verlängern sich monatlich und können jederzeit gekündigt werden. Developer-Guthaben lässt sich durch einmalige Zahlungen aufstocken; bei aufgebrauchtem Guthaben werden Aufrufe pausiert. Die Laufzeit des Business-Vertrags wird individuell vereinbart.
Anwendungsfälle
Ein offenes Modell in eine Anwendung integrieren
Benötigt eine Anwendung gehostete LLM-Inference, wird ein Modell gewählt, ein API-Schlüssel erstellt und der OpenAI-kompatible Endpunkt im SDK konfiguriert. Anfragen verwenden das gewählte Modell, ohne dass der Betreiber GPUs bereitstellen oder Modellgewichte hosten muss.
Modelle mit Coding-Agenten verbinden
Benötigen Coding-Agenten Modellzugriff, können sie die Developer-Plan-API mit Tools wie Cline, Pi Agent, Kilo Code, OpenCode, OpenHands und n8n verwenden. Anfragen werden vom Monatsguthaben abgezogen; erfolgreiche Aufrufe werden pro Token berechnet.
Interaktive Modellgespräche führen
Für manuell eingegebene Chats oder Rollenspiele des Käufers eignet sich der Chat-Plan mit kompatiblen Frontends wie SillyTavern, RisuAI oder Wyvern. Er umfasst unbegrenzte Tokens, 32K Kontext und vier parallele Einheiten, gilt aber nur für menschlich gesteuerte Nutzung.
Dedizierte Inference-Kapazität reservieren
Wenn ein Workload reservierte GPU-Kapazität benötigt, werden Modelle oder Beschleuniger, Anzahl, Laufzeit und Region angegeben. Featherless dimensioniert eine dedizierte Konfiguration und betreibt sie für Inference; die konkrete Konfiguration hängt vom Workload ab.
Einschränkungen
Der Chat-Plan ist auf interaktive, menschlich gesteuerte Nutzung durch den Käufer beschränkt; App- oder API-Verkehr, Weiterverkauf, Hintergrundautomatisierung und Benchmarking sind ausgeschlossen.
Chat bietet 32K Kontext und vier parallele Einheiten; für Developer sind bis zu 256K Kontext und 100 parallele Einheiten angegeben.
Developer-API-Anfragen werden bei aufgebrauchtem Guthaben angehalten und erst nach dem Hinzufügen von Guthaben fortgesetzt.
Business hat individuelle Preise, Jahresverträge und Mengenpreise; Kapazität und Parallelität richten sich nach den ausgewählten GPUs.
Zielgruppen
Anwendungsentwickler, die gehostete Inference für offene Modelle per API benötigen
Entwickler, die Coding-Agenten oder Produktionsanwendungen mit API-Verkehr betreiben
Nutzer, die menschlich gesteuerten Modell-Chat über kompatible Frontends benötigen
Teams mit Bedarf an reservierten GPUs, privaten Fine-Tunes oder einem Vertrag mit Festkosten
Häufige Fragen
Müssen Kunden für Featherless eigene GPUs hosten?
Nein. Die serverlose Inference-API führt Modelle auf von Featherless betriebener Infrastruktur aus. Kunden wählen ein Modell und verwenden einen API-Schlüssel, statt GPUs bereitzustellen oder Modellgewichte zu laden.
Wie werden Developer-API-Anfragen berechnet?
Erfolgreiche Anfragen werden anhand der Input- und Output-Token-Preise des gewählten Modells berechnet. Fehlgeschlagene Anfragen kosten nichts, ungenutztes Guthaben verfällt nicht und bei leerem Guthaben werden Aufrufe pausiert.
Darf Chat für App- oder API-Verkehr verwendet werden?
Nein. Chat ist für interaktive, menschlich gesteuerte Nutzung durch den Käufer vorgesehen. App- oder API-Verkehr, Weiterverkauf, Hintergrundautomatisierung und Benchmarking sind ausgeschlossen.
Was passiert, wenn ein Modell vorübergehend ausgelastet ist?
Ein ausgelastetes Modell kann HTTP 503 zurückgeben; der fehlgeschlagene Versuch wird nicht berechnet. Wiederholen Sie die Anfrage oder wechseln Sie das Modell. Bei anhaltenden Problemen empfiehlt die Pricing-FAQ, den Support zu kontaktieren.
Können Chat-Nutzer für mehr Kontext zu Developer wechseln?
Ja. Der Wechsel von Chat zu Developer gilt sofort, schreibt aber die bereits bezahlte Restlaufzeit von Chat nicht gut und erstattet sie nicht. Ein Wechsel zum Verlängerungszeitpunkt vermeidet den Verlust dieser vorausbezahlten Zeit.
Was umfasst der Business-Plan?
Business ist ein individueller Vertrag für Teams, die garantierte Latenz und feste Kosten benötigen. Aufgeführt sind dedizierte GPUs, keine gemeinsam genutzten Rate-Limits, private Fine-Tunes, feste Ansprechpartner aus dem Engineering und ein SLA; die Verträge laufen jährlich und haben Mengenpreise.
Kommentare