DeepInfer
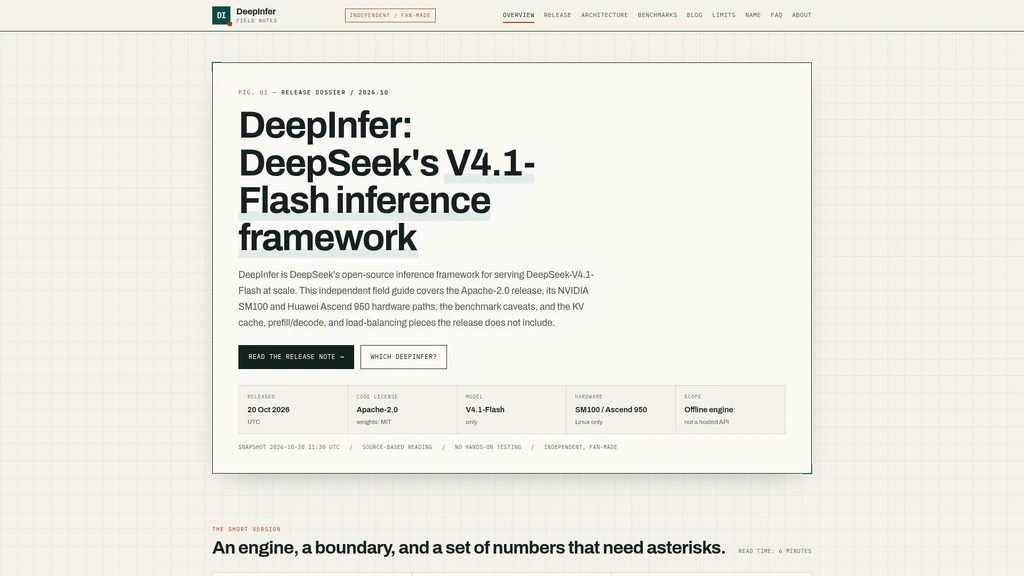
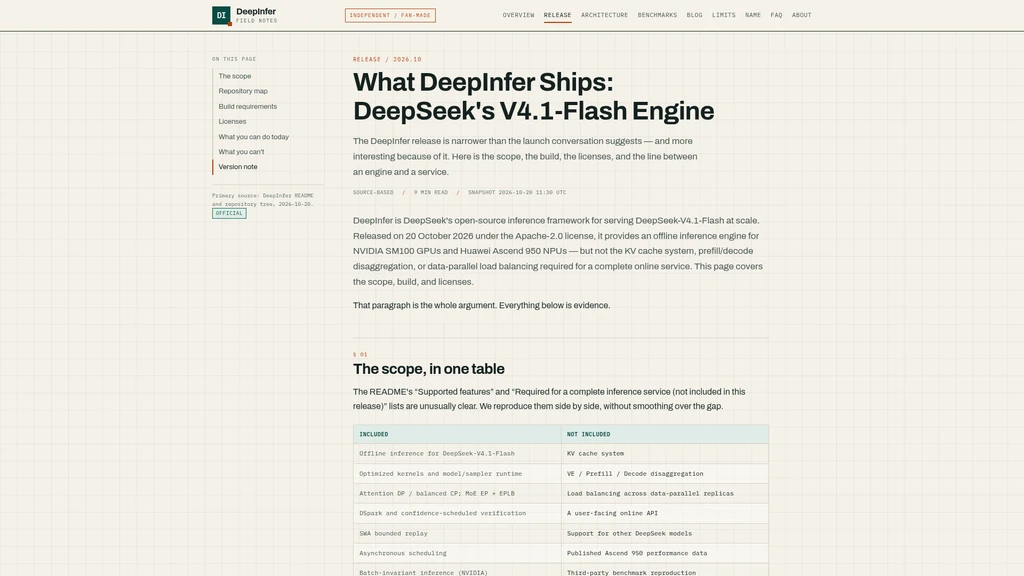
DeepInfer ist DeepSeeks quelloffenes Offline-Inferenz-Framework unter Apache-2.0-Lizenz, das für den skalierbaren Betrieb von DeepSeek-V4.1-Flash entwickelt wurde. Es unterstützt NVIDIA SM100- und Huawei Ascend 950-Hardware unter Linux und wird über eine unabhängige, von der Community erstellte Referenzseite dokumentiert, die Veröffentlichungsdetails, Architektur, Einschränkungen bei Benchmarks und nicht enthaltene Komponenten abdeckt. Das Tool ist keine gehostete API, keine benutzerorientierte Online-Dienstleistung und kein vollständiges End-to-End-Serving-Stack.
Kernfunktionen
DeepInfer wird mit einem vorintegrierten Stapel optimierter Komponenten ausgeliefert, die speziell für DeepSeek-V4.1-Flash entwickelt wurden:
Ein vollständiger benutzerdefinierter Kernel-Satz einschließlich FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect und benutzerdefinierter TileLang-Kernel, der aus zuvor veröffentlichten DeepSeek-Kernel-Komponenten zu einem einzigen einheitlichen Motor zusammengestellt wurde.
Eine Parallelitätskonfiguration, die Expert-Parallelismus (EP) für MoE-Schichten, Attention-Datenparallelismus (DP) und ausgewogenen Kontextparallelismus (CP) kombiniert. Sie ist dafür ausgelegt, Experten in Produktivumgebungen auf 64–128 GPUs zu verteilen, mit redundanten Kopien zum Neuausgleich überlasteter Experten.
DSpark-Spekulatives Dekodieren mit variabler Überprüfung, das einen Confidence-Head verwendet, um zu ermitteln, welche Entwurfstoken eine vollständige Modellvalidierung erfordern. Dies liefert einen angegebenen Durchsatzgewinn von 4–7 % bei standardmäßigen Produktivbetriebspunkten.
Begrenztes Wiedergeben von Sliding-Window-Attention (SWA), das die Rekalkulationskosten begrenzt, indem nur der aktuelle Endteil des Caches wiedergegeben wird, anstatt den vollständigen Sliding-Window-Cache in jeder Schicht neu aufzubauen – für vorhersehbare, begrenzte Rechenaufwände.
Asynchrone Planung, die CPU-Batch-Vorbereitungsarbeiten parallel zur aktiven GPU-Ausführung ausführt und Leerlücken zwischen aufeinanderfolgenden Dekodierungsschritten beseitigt.
Batch-invariante Inferenz und deterministische Sampling-Modi, die exklusiv auf NVIDIA-Hardware verfügbar sind, für nachvollziehbare Benchmarks und konsistentes Verhalten von Agentenläufen.
Native Unterstützung für strukturierte Ausgaben für Regex-Regeln, JSON-Schema-Definitionen und EBNF-Grammatikeinschränkungen.
Die zugehörige Bibliothek deepseek-recipe, ein separates Repository unter MIT-Lizenz, das API-Protokollkonvertierung und Tokenisierungshilfsprogramme bereitstellt.
Vollständige Offline-Inferenzausführung für das Modell DeepSeek-V4.1-Flash.
Zielgruppen
DeepInfer wurde für drei primäre Benutzergruppen entwickelt:
Entwickler, die direkt mit dem Modell DeepSeek-V4.1-Flash arbeiten und eine niedrigstufige Kontrolle über die Inferenzausführung benötigen.
Forscher im Bereich Inferenz-Engines, die produktionsreife Optimierungsmuster für LLMs untersuchen – einschließlich breitem Expert-Parallelismus, vertrauensgeführtem spekulativen Dekodieren und begrenztem Cache-Wiedergabe.
Ingenieure, die eine benutzerdefinierte LLM-Serving-Infrastruktur aufbauen und die aus DeepSeeks Produktivbetrieb abgeleiteten Inferenzoptimierungen für ihre eigenen Bereitstellungen anpassen möchten.
Unterstützte Arbeitsabläufe
Das Framework ist für Offline-Inferenz-Workloads ausgelegt, die sich auf DeepSeek-V4.1-Flash konzentrieren, und enthält keine vorgefertigte benutzerorientierte Serving-Schicht. Typische Nutzungsmuster umfassen:
Integration des voroptimierten Kernel-Stapels und der Parallelitätskonfiguration in benutzerdefinierte interne Inferenzpipelines für DeepSeek-V4.1-Flash.
Testen und Überprüfen des deterministischen Inferenzverhaltens für Benchmarks oder Agent-Workloads auf NVIDIA-Hardware.
Implementieren von Einschränkungen für strukturierte Ausgaben für DeepSeek-V4.1-Flash-Workloads ohne zusätzliche Middleware von Drittanbietern.
Erweitern des Basismotors, um benutzerdefinierte Serving-Komponenten für spezifische interne Infrastrukturanforderungen zu erstellen.
Erforschen und Modifizieren modernster LLM-Inferenzoptimierungen, einschließlich spekulativen Dekodierens und MoE-Lastausgleichs.
Einschränkungen und explizit nicht enthaltene Funktionen
DeepInfer hat einen eng definierten Geltungsbereich und wird nicht mit Komponenten ausgeliefert, die für einen vollständigen produktiven Online-Serving-Stack erforderlich sind:
Es enthält kein persistentes KV-Cache-System, das separate Anfragen oder mehrere Maschinen überdauern kann.
Es implementiert keine Prefill/Decode-Disaggregation, um Workloads auf separate dedizierte Hardwarepools aufzuteilen.
Es enthält keinen datenparallelen Lastausgleich über mehrere Inferenz-Replikate hinweg.
Es ist keine benutzerorientierte Online-API und wird nicht mit einem OpenAI-kompatiblen Server, Authentifizierung, Quotenverwaltung, Abrechnungs- oder Observability-Tooling ausgeliefert.
Es ist kein Allzweck-Inferenzmotor und unterstützt ausschließlich das Modell DeepSeek-V4.1-Flash, ohne offizielle Unterstützung für andere DeepSeek-Modelle oder LLMs von Drittanbietern.
Zum Zeitpunkt der Veröffentlichung liegen keine veröffentlichten Leistungsdaten für Huawei Ascend 950-Hardware vor.
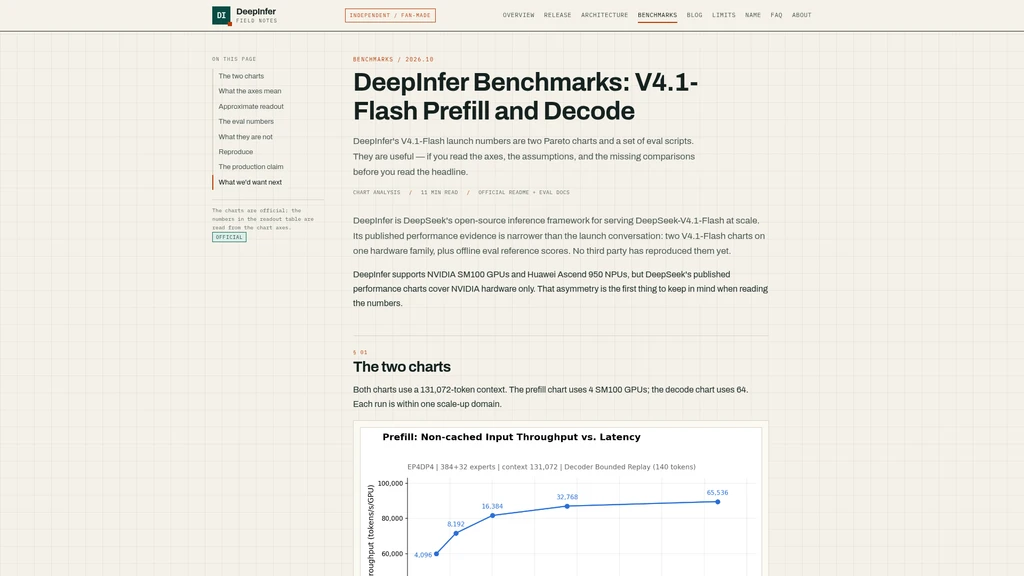
Zum Veröffentlichungszeitpunkt vom 20. Oktober 2026 liegen keine unabhängigen Reproduktionen der offiziellen Benchmark-Diagramme durch Dritte vor.
Alle offiziellen Benchmark-Daten werden mit einer Kontextlänge von 131.072 Token gemessen, nicht mit dem vollen maximalen Kontext von 1 Million Token, der von DeepSeek-V4.1-Flash unterstützt wird. Die veröffentlichten Dekodierungsleistungswerte gehen von einer Akzeptanzrate von 75 % für Entwurfstoken aus, die je nach Komplexität des Eingabetexts variiert.
Das Framework unterstützt keine Hardware außer NVIDIA SM100 und Huawei Ascend 950 unter Linux, ohne offizielle Unterstützung für andere NVIDIA-Generationen oder Ascend-Chips.
Lizenzierung und Zugriff
DeepInfer wird unter der permissiven Apache-2.0-Lizenz veröffentlicht und steht zum kostenlosen Download, zur Modifikation und zum Selbsthosting ohne direkte Kosten zur Verfügung. Die zugehörige Bibliothek deepseek-recipe wird unter der MIT-Lizenz veröffentlicht. Die unabhängige, von der Community erstellte Referenzseite zum Projekt ist nicht mit DeepSeek, NVIDIA oder Huawei verbunden, und alle Produktangaben auf der Referenzseite werden direkt öffentlichen offiziellen Quellen zugeordnet.




Kommentare