
- Monatliche Besuche
- 223
- 2026-10
- Monatliches Wachstum +7.333,3 %
daVinci-MagiHuman - Aus Porträt und Text oder Audio ein lippensynchrones Sprechvideo erstellen
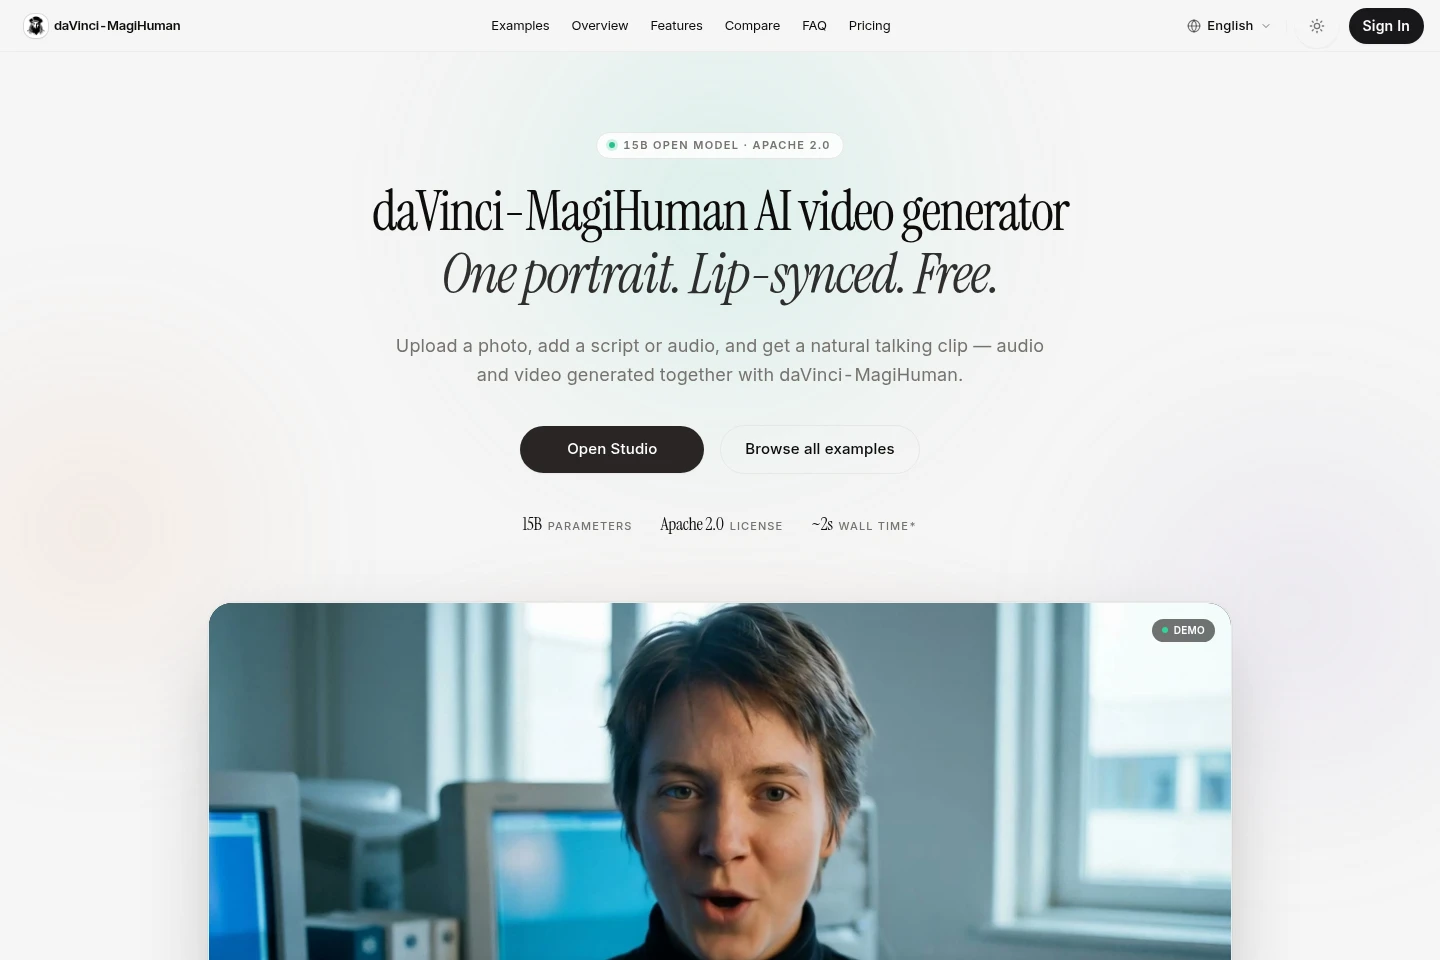
daVinci-MagiHuman ist ein quelloffenes KI-Modell mit 15 Milliarden Parametern zur Erzeugung sprechender Porträtvideos. Es verarbeitet ein Porträtfoto und Text oder Audio und erzeugt synchronisierte Sprache und Video. Das Modell steht unter der Apache-2.0-Lizenz für lokale Inferenz und kommerzielle Nutzung gemäß den Lizenzbedingungen bereit. Zusätzlich gibt es ein Online-Studio mit separat bepreisten Abonnements und Credits.
- KI-Video
- KI-Avatare
- KI-Sprechvideogenerator
- Lippensynchronisation für Porträts
- Open-Source-Audio-Video-KI
Funktionen
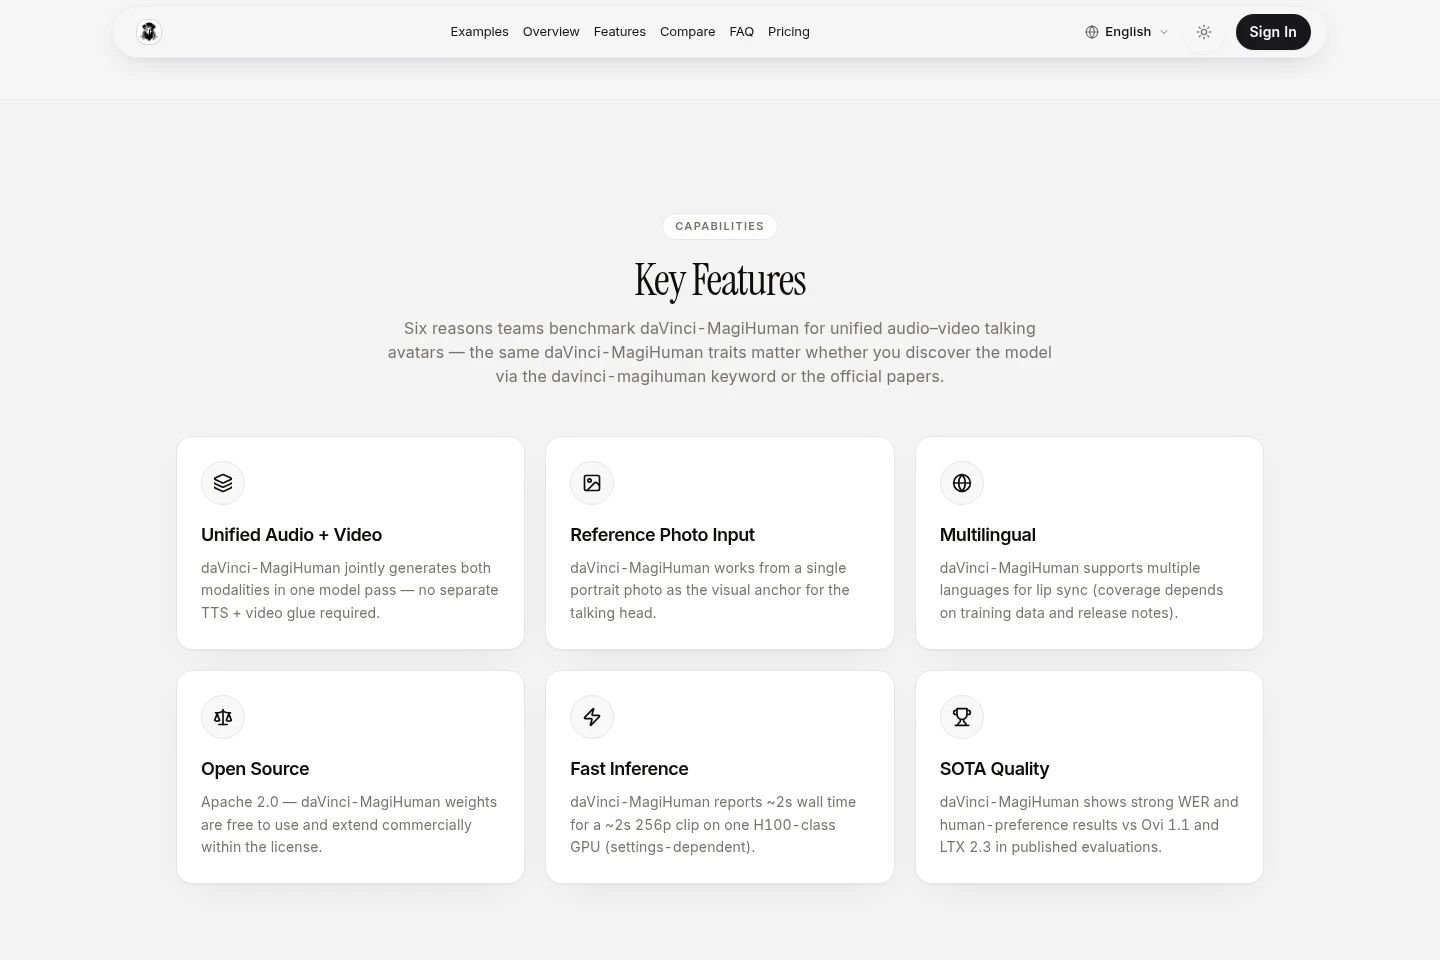
Sprechvideo-Generierung
Erzeugt ein lippensynchrones Sprechvideo mit passendem Audio. Eingabe sind ein Porträt und ein Textskript oder Audio; Ausgabeauflösung und Inferenzgeschwindigkeit hängen von Einstellungen und verfügbarer Hardware ab.
Gemeinsame Audio-Video-Generierung
Erzeugt Audio und Video gemeinsam in einem Modelldurchlauf. Der Single-Stream-Transformer verarbeitet Audio- und Videotoken zusammen, statt getrennte Text-to-Speech- und Videopipelines zu benötigen.
Lokale Modellinferenz
Führt Inferenz lokal mit den veröffentlichten Modellgewichten aus. Laden Sie die Checkpoints herunter und folgen Sie dem Upstream-README für Einrichtung, Inferenzskripte und Befehlszeilenoptionen; die Hardware beeinflusst den Durchsatz.
Online-Videostudio
Bietet einen gehosteten Workflow zur KI-Videogenerierung. Das Studio ist online verfügbar; Abonnements und separat kaufbare Credits werden auf der Preisseite aufgeführt.
Preise
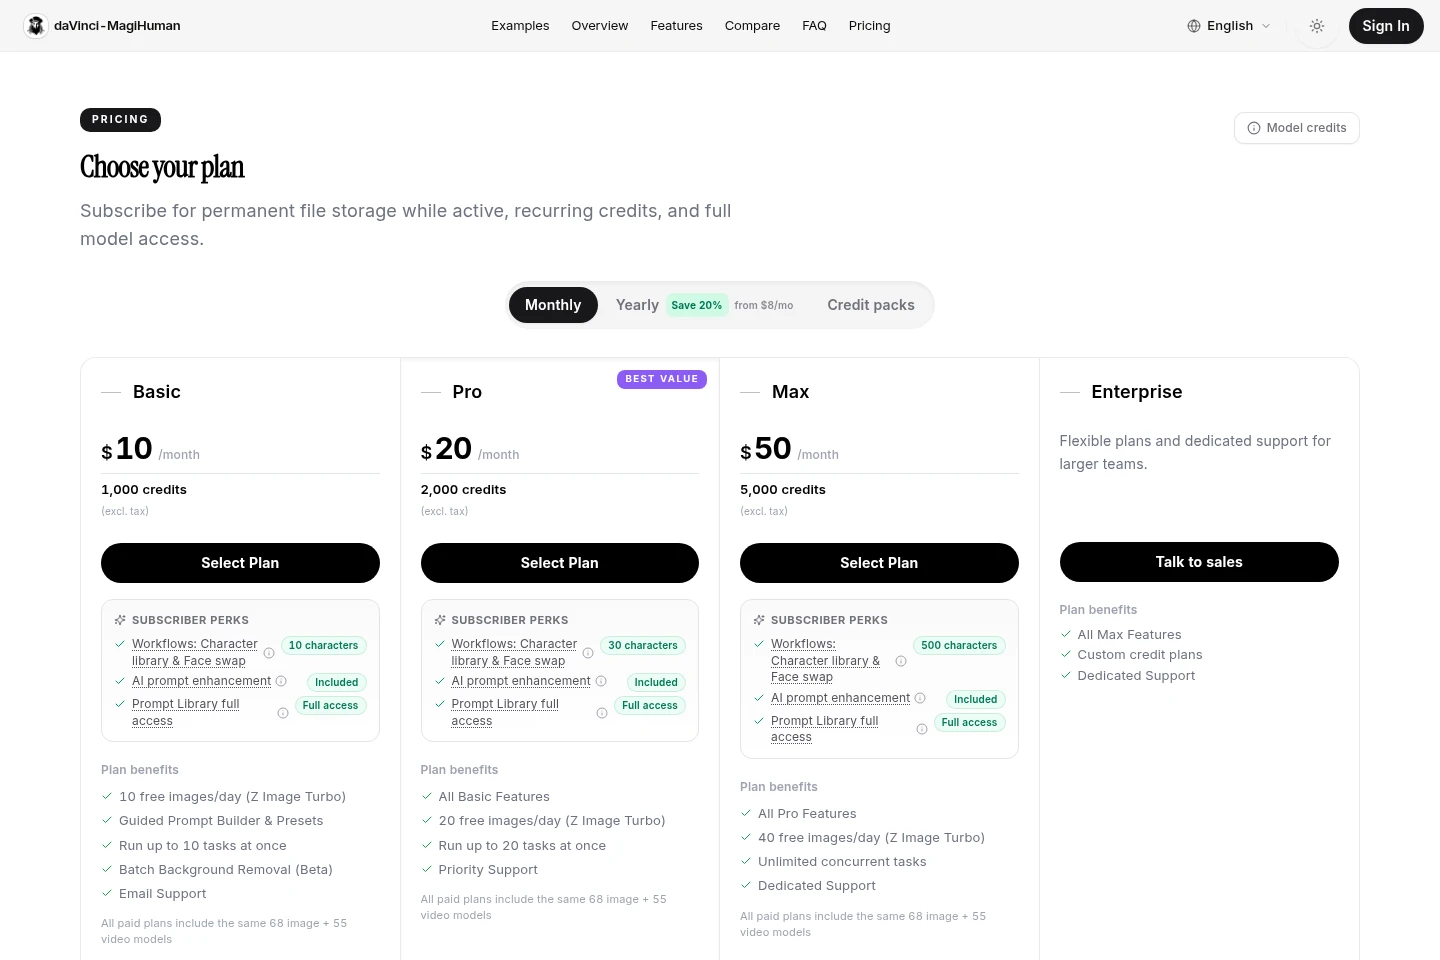
Das gehostete Studio bietet kostenlosen Zugang, monatliche oder jährliche Abonnements und einmalige Credit-Käufe. Vergleichen Sie Creditmenge, tägliche Gratisbilder, parallele Aufgaben, Charakterlimits, Support und Modellzugriff.
| Tarif | Preis | Leistungen und Limits |
|---|---|---|
| Basic | $10/Monat |
|
| Pro | $20/Monat |
|
| Max | $50/Monat |
|
| Enterprise | Flexible Tarife; Vertrieb kontaktieren |
|
| Pay-as-you-go credits | Einmalkauf; Preis variabel |
|
Jahresabonnements werden jährlich im Voraus zu einem rabattierten effektiven Preis abgerechnet; die Seite wirbt mit 20 % Ersparnis. Abonnements verlängern sich automatisch. Für neue Abonnements gilt eine siebentägige Erstattungsfrist; Probleme mit Verlängerungen müssen innerhalb von 72 Stunden gemeldet werden.
Anwendungsfälle
Lippensynchronen Porträtclip erstellen
Wenn ein Porträt einen Text oder bereitgestelltes Audio sprechen soll, geben Sie das Bild und den Text oder das Audio ein. Das Modell erzeugt ein Sprechvideo mit synchroner Sprache und Lippenbewegung.
Sprechvideo-Inferenz auf eigener Hardware ausführen
Möchten Entwickler oder Forschende das Modell lokal oder auf einem Server ausführen, laden sie die Checkpoints von Hugging Face und richten die Inferenz anhand des Projekt-READMEs ein. Die Generierung läuft anschließend auf der gewählten Hardware.
Videos im gehosteten Studio generieren
Wer Videos online erstellen möchte, ohne das Modell zu installieren, öffnet das KI-Videostudio und startet einen unterstützten Auftrag. Die Preisseite erläutert Abonnements, Credits und den verbrauchsabhängigen Creditbedarf.
Einschränkungen
Im gehosteten Abonnement werden Anfragen bei einem Creditstand von null angehalten; Credits können nachgekauft oder durch ein Upgrade ergänzt werden.
Die unterstützten Lippensynchronisationssprachen hängen von Trainingsdaten und Modellversion ab; die aktuelle Liste steht im offiziellen README.
Die Inferenzgeschwindigkeit hängt von Einstellungen und Hardware ab; die Angabe von etwa zwei Sekunden bezieht sich auf einen etwa zwei Sekunden langen 256p-Clip auf H100-Klasse-GPU.
Die kommerzielle Nutzung des Modells unterliegt den Bedingungen der Apache-2.0-Lizenz, einschließlich geltender Hinweise und Namensnennungen.
Credits aus dem Einmalkauf verfallen nicht; Abonnement-Credits werden monatlich oder jährlich bereitgestellt.
Zielgruppen
Entwickler, die ein quelloffenes Sprechvideomodell integrieren oder ausführen
Forschende zur Bewertung von Audio-Video-Modellen und Inferenz
Kreative, die online sprechende Porträtvideos erstellen möchten
Häufige Fragen
Was erzeugt daVinci-MagiHuman?
Aus einem Porträt und Text oder Audio entsteht ein lippensynchrones Sprechvideo mit passendem Audio. Das Modell erzeugt Audio und Video gemeinsam.
Kann das Modell kostenlos genutzt werden?
Die veröffentlichten Modellgewichte und der Code stehen unter Apache 2.0. Für Abonnements und Credits des gehosteten Studios gelten separate Preise und Bedingungen.
Darf ich daVinci-MagiHuman kommerziell einsetzen?
Ja, unter Einhaltung der Bedingungen der Apache-2.0-Lizenz. Prüfen Sie für Ihren Einsatz die Lizenzpflichten, einschließlich Hinweise und Namensnennung.
Welche Sprachen unterstützt die Lippensynchronisation?
Die Sprachabdeckung hängt vom veröffentlichten Modell und dessen Trainingsdaten ab. Das offizielle README nennt die aktuelle Liste und mögliche regionale Einschränkungen.
Wie werden Credits im Online-Studio berechnet?
Der Creditverbrauch richtet sich nach Länge und Einstellungen wie Auflösung und Modus. Die Preis-FAQ enthält Richtwerte; den aktuellen Bedarf zeigt das Studio an.
Verfallen Credits aus dem Einmalkauf?
Nein. Einmalig gekaufte Credits verfallen nicht; Abonnement-Credits werden dagegen monatlich oder jährlich gutgeschrieben.

Kommentare