
- Monatliche Besuche
- 3.505
- 2026-10
- Monatliches Wachstum -57,8 %
crawler.sh - Lokales Crawling, Markdown-Extraktion und SEO-Analyse
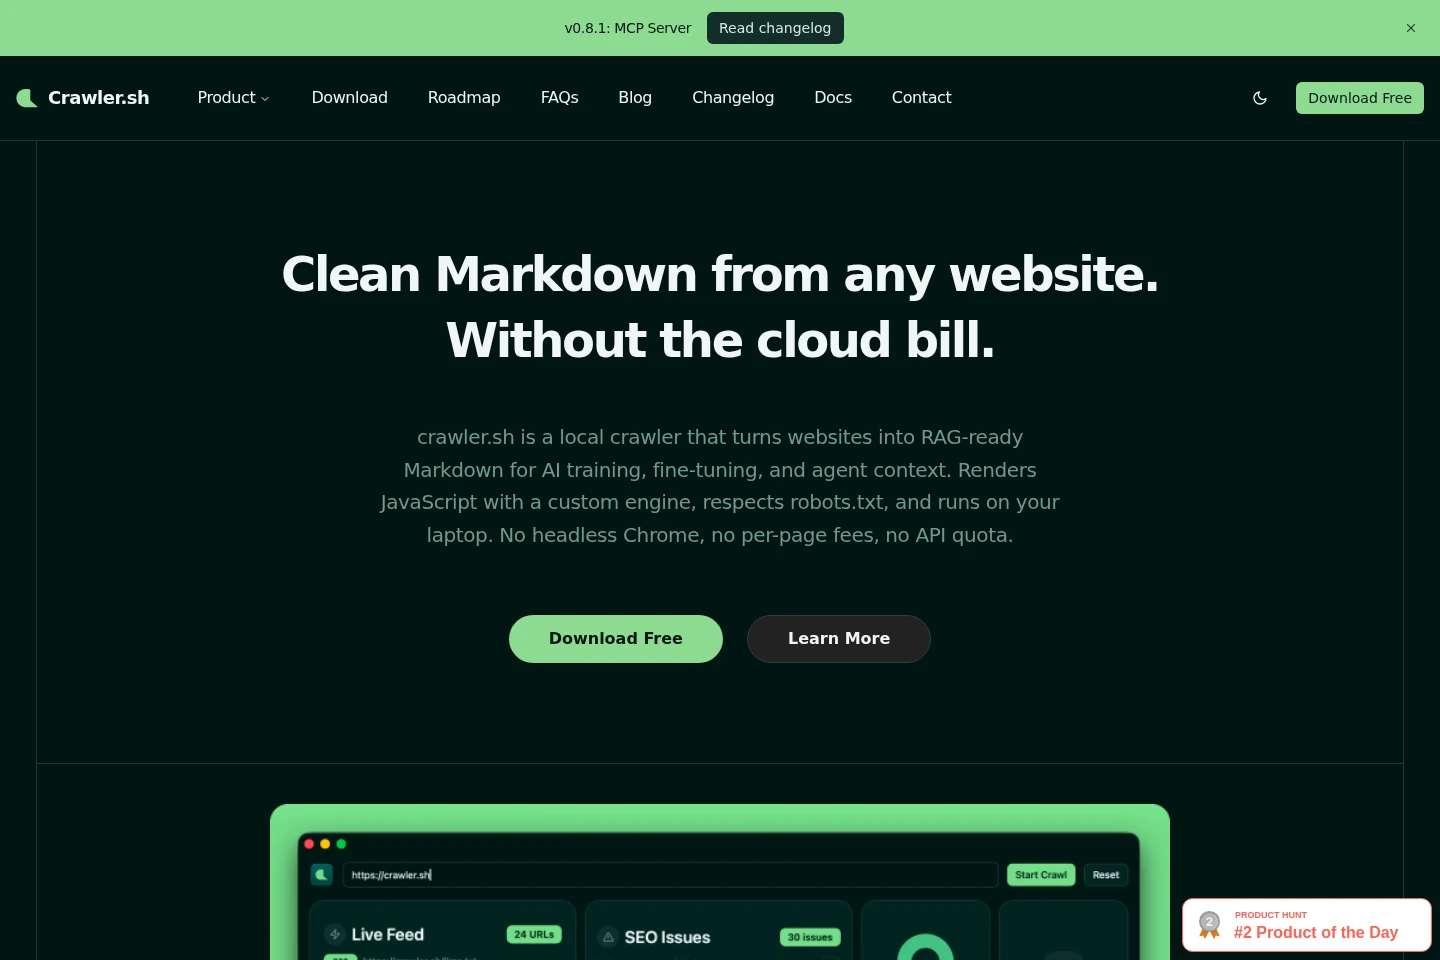
crawler.sh ist ein lokal ausgeführter CLI- und Desktop-Webcrawler. Er extrahiert Artikelinhalte als Markdown, rendert JavaScript-lastige Seiten und prüft gecrawlte Seiten auf SEO-Probleme. Das Tool beachtet robots.txt, exportiert Crawl- und Analyseergebnisse in mehreren Formaten und läuft auf dem Gerät der Nutzenden. Die kostenlose Nutzung umfasst bis zu 50 Seiten pro Sitzung; CLI Pro erlaubt bis zu 10.000.
- KI-Marketing
- SEO-Tools
- Web Scraping
- lokaler Website-Crawler
- Markdown-Inhaltsextraktion
- SEO-Audit-Tool
Funktionen
Websites crawlen
Crawlt Websites lokal und speichert Seitenergebnisse zur Prüfung oder zum Export. Parallelität, Wiederholungen und Rendering lassen sich konfigurieren; robots.txt wird beachtet und das Tempo nach 429- oder 403-Antworten angepasst.
Markdown-Extraktion
Extrahiert den Hauptartikel aus HTML-Seiten und gibt sauberes Markdown mit Wortzahl, Autorenzeile und Auszug aus. Die Extraktion ist standardmäßig aktiv und kann mit --no-extract deaktiviert werden.
JavaScript-Rendering
Rendert Seiten, die clientseitiges JavaScript benötigen, mit einer integrierten Engine. Der Auto-Modus erkennt den Bedarf; mit --render lässt sich Rendering erzwingen und mit --no-render abschalten.
SEO-Analyse
Prüft gecrawlte Seiten auf SEO-Probleme und exportiert gruppierte Ergebnisse als CSV oder TXT. Die Analyse umfasst 24 Kategorien und berücksichtigt nur HTML-Seiten mit einer 2xx-Antwort.
Crawl- und Website-Export
Exportiert Crawl-Daten als NDJSON, JSON oder W3C-konformes Sitemap XML; SEO-Ergebnisse sind als CSV oder TXT verfügbar. Der Pro Content Archive-Export schreibt extrahierte Seiten einzeln als Markdown-Dateien in ein ZIP-Archiv.
Preise
Ein kostenloser Tarif ist verfügbar; die kostenpflichtigen Pro-Tarife sind Abonnements. Vergleichen Sie Seitenlimits pro Sitzung, Oberfläche, Analyse und Exportformate. Free kostet $0, CLI Pro wird jährlich berechnet; für Desktop Pro nennen die Seiten keinen Preis.
| Tarif | Preis | Leistungen und Limits |
|---|---|---|
| Free | $0 |
|
| CLI Pro | $99 pro Jahr |
|
| Desktop Pro | Preis nicht angegeben |
|
Ein Abonnement gilt für CLI und Desktop-App. Laut Produktseite erhöht eine Anmeldung das Limit auf 400 Seiten pro Crawl; der Preis und die Abrechnungsbedingung für den zugehörigen Tarif werden nicht genannt.
Anwendungsfälle
Website-Inhalte für KI-Pipelines vorbereiten
Wenn Website-Seiten für RAG, Fine-Tuning oder Agentenkontext benötigt werden, lässt sich die Website crawlen und der Hauptartikeltext extrahieren. crawler.sh speichert sauberes Markdown und Seitenmetadaten lokal für nachgelagerte Abläufe.
SEO-Probleme einer Website prüfen
Zur Prüfung einer Website vor dem Start oder während der Wartung werden Seiten gecrawlt und die SEO-Analyse ausgeführt. Kategorisierte Probleme lassen sich als CSV oder TXT exportieren und den betroffenen URLs zuordnen.
Markdown-Archiv von Website-Inhalten erstellen
Wenn Website-Inhalte gesichert oder in einen anderen Ablauf übernommen werden sollen, können Seiten gecrawlt und extrahierte Inhalte exportiert werden. Pro Content Archive erstellt ein ZIP mit einer Markdown-Datei je extrahierter Seite.
Sitemap aus einem Live-Crawl erzeugen
Wenn eine Sitemap die gecrawlten Seiten abbilden soll, wird ein Crawl ausgeführt und W3C-konformes Sitemap XML exportiert. Die erzeugte Datei kann als Sitemap der Website verwendet werden.
Einschränkungen
Ohne Anmeldung sind 50 Seiten pro Sitzung möglich; mit Anmeldung sind es 400 Seiten pro Crawl, und CLI Pro erlaubt bis zu 10.000 Seiten pro Sitzung.
Die SEO-Analyse verarbeitet nur HTML-Seiten mit einer 2xx-Antwort.
Laut FAQ steht Windows auf der Roadmap; aktuell werden macOS und Linux für CLI und Desktop-App aufgeführt.
Support wird auf Englisch angeboten; das Team versucht laut eigener Aussage, Nachrichten in anderen Sprachen zu verstehen und zu beantworten.
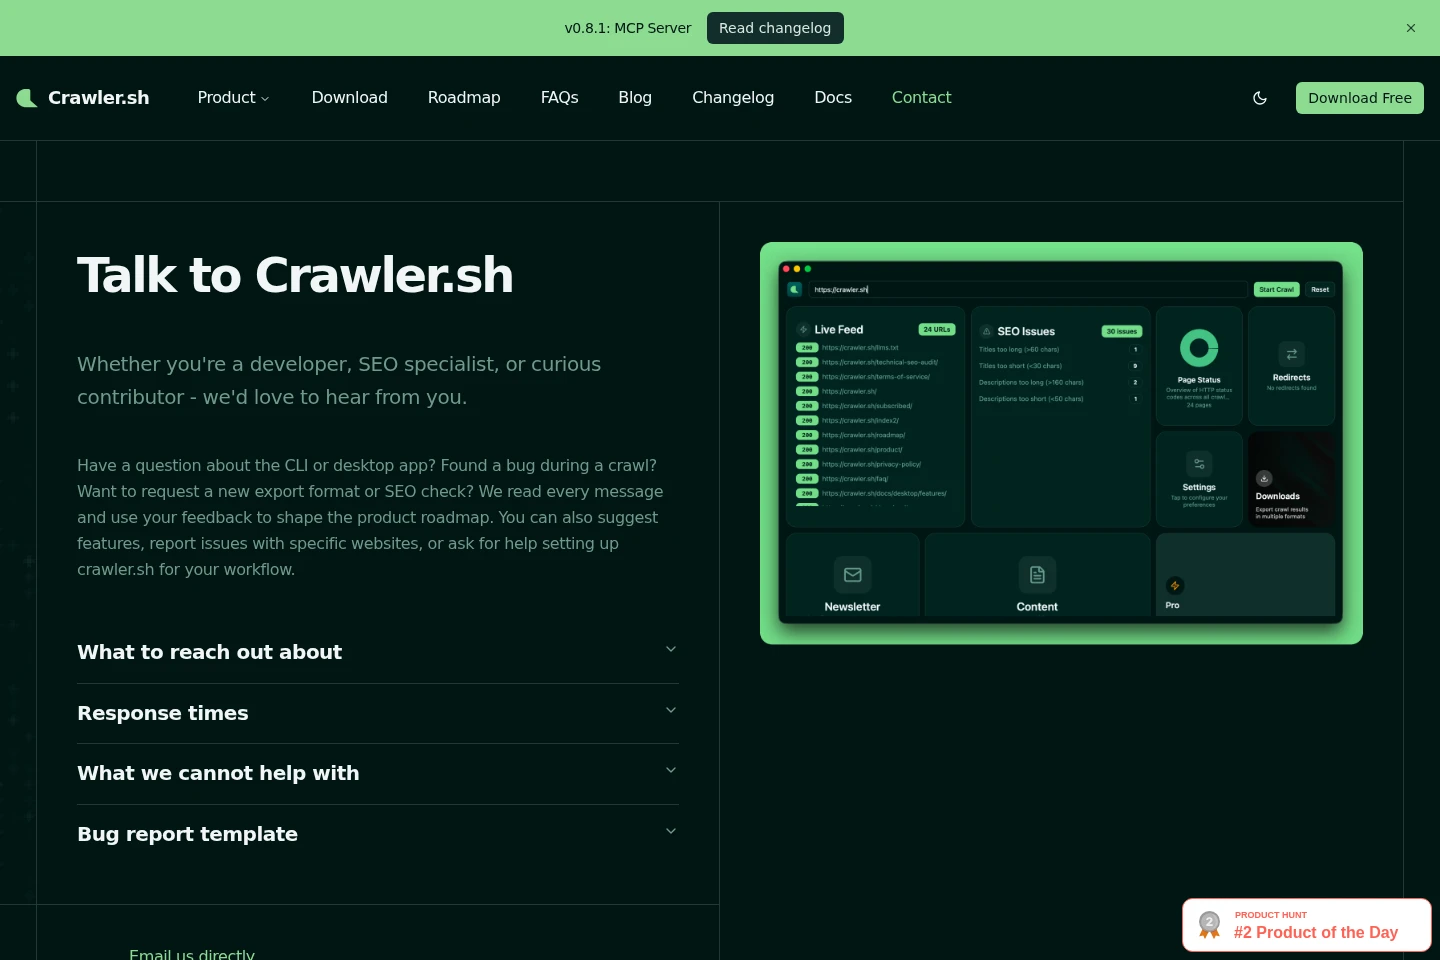
Das Team crawlt keine Websites im Auftrag, erstellt keine individuellen Dashboards und verfasst keine maßgeschneiderten SEO-Berichte als bezahlte Leistung.
Auch bei Pro gibt es keinen Telefonsupport, keine Ticket-SLAs und keine festen Account Manager.
Zielgruppen
Entwickler, die lokale Crawls in Skripten, geplanten Jobs oder CI-Pipelines benötigen
SEO-Fachleute, die technische Probleme einer Website prüfen und Berichte exportieren
Personen, die Website-Texte als Markdown für RAG, Fine-Tuning oder Agentenkontext aufbereiten
Website-Betreiber, die Inhalte archivieren, Sitemaps erzeugen oder Seitenänderungen überwachen
Häufige Fragen
Welche Betriebssysteme unterstützt crawler.sh?
CLI und Desktop-App sind für macOS und Linux verfügbar. Laut FAQ werden Apple Silicon und Intel auf macOS sowie x86_64 auf Linux unterstützt; Windows steht auf der Roadmap.
Brauche ich zum Crawlen ein Konto?
Nein. CLI und Desktop-App funktionieren ohne Konto mit einem Limit von 50 Seiten pro Crawl; nach der Anmeldung steigt das Limit auf 400 Seiten.
Kann crawler.sh JavaScript-Seiten rendern?
Ja. Die integrierte Engine erkennt clientseitige JavaScript-Frameworks im Auto-Modus. Mit --render lässt sich Rendering erzwingen, mit --no-render deaktivieren.
Welche Formate kann crawler.sh exportieren?
Crawl-Daten lassen sich als NDJSON, JSON oder Sitemap XML exportieren; SEO-Berichte als CSV oder TXT. Pro Content Archive gibt extrahierte Seiten außerdem als Markdown-Dateien in einem ZIP aus.
Wie funktioniert die Inhaltsextraktion?
Wenn sie aktiviert ist, extrahiert crawler.sh den Hauptartikel aus HTML-Seiten als Markdown und ergänzt Wortzahl, Autorenzeile und Auszug. Sie ist standardmäßig aktiv und kann mit --no-extract deaktiviert werden.
Welche Seiten fließen in die SEO-Analyse ein?
Analysiert werden nur HTML-Seiten mit einer 2xx-Antwort. Der SEO-Befehl prüft 24 Kategorien, darunter Metadaten, Überschriften, Links, kanonische URLs und Aktualitätssignale.
Kommentare